PAPER-DIGEST · 2026-08-23
Pfau & Vrettis: Was passiert, wenn man Spielerinnen und Spieler ihre eigene Pokémon-Karte gestalten lässt — Fukai liest
PCG / Sammelkartenspiele / generative KI und das Gefühl der Urheberschaft
Zusammenfassung in einem Absatz
„Die Pokémon-Karte, die man sich selbst ausgedacht hat, wird in 20 Sekunden zu einer echt aussehenden Karte." Heute habe ich ein Paper gelesen, das genau das ausprobiert hat. Eine spielende Person schreibt einen Namen und eine kurze Beschreibung, und die KI fügt Bild, Attacken und Werte zu einer fertigen Karte zusammen. Erstellt haben sie 49 Studierende, insgesamt 196 Stück. Magic: The Gathering Arena (Wizards of the Coast, 2023), Spielszene (von der Steam-Store-Seite)
Interessant ist die Zusammensetzung dieser Zufriedenheit. Die Zufriedenheit mit dem Aussehen lag im Schnitt bei 4,25 von 5 Punkten. Und fragt man, wessen Idee das fertige Ergebnis sei, antworteten 93,5 % mit „meine eigene". Die KI hat die Arbeit gemacht, und trotzdem fühlt es sich wie das eigene Werk an. Die Autoren nennen das „procedural relatedness" (prozedurale Verbundenheit).
Eine Einschränkung gibt es allerdings. Keine der entstandenen Karten wurde bisher in einem Match eingesetzt. Weder zu starke noch zu schwache Karten wurden im tatsächlichen Spiel überprüft. Darauf komme ich in der zweiten Hälfte des Artikels ausführlich zurück.
Über dieses Paper
Der Titel des Papers lautet "From LLM-Driven Trading Card Generation to Procedural Relatedness: A Pokémon Case Study". Die beiden Autoren, Johannes Pfau und Panagiotis Vrettis, sind beide an der Universität Utrecht in den Niederlanden tätig. Es erschien am 30. April 2026 als Preprint auf arXiv, also als Manuskript, das vor dem Peer-Review veröffentlicht wird. Gelistet ist es unter arXiv:2604.27972v1 in der Kategorie cs.AI, mit einer CC-BY-NC-ND-4.0-Lizenz.
Ich habe es aus zwei Gründen für heute ausgewählt. Erstens neigten die Paper, die ich hier zuletzt besprochen habe, stark zum Muster „KI ein Spiel lösen lassen und bewerten". Zweitens stellt diese Studie ungewöhnlicherweise „das Gefühl der Erschaffenden" in den Mittelpunkt. Unter den Studien zu generativer KI messen nur wenige, ob sich das Ergebnis wie das eigene anfühlte, statt nur, wie gut es geworden ist.
Seit der Einreichung sind erst rund vier Monate vergangen, man darf also davon ausgehen, dass es noch kaum zitiert wurde. Es befindet sich nicht in einem Stadium breiter Diskussion. Auch einen Hinweis darauf, dass es das Peer-Review durchlaufen hat, konnte ich im Text nicht finden. Mit diesem Vorbehalt lese ich weiter.
Das Problem, dass nur die starken Karten übrig bleiben
Sammelkartenspiele (TCG – Trading Card Games, bei denen man mit gesammelten Karten ein eigenes Deck baut und damit spielt) sind eine große Industrie. Das Paper nennt Magic: The Gathering aus dem Jahr 1993 als Ausgangspunkt und beziffert die Branche inzwischen auf mehrere Milliarden Dollar. Allein Magic werde von über 50 Millionen Menschen gespielt und erziele einen Umsatz von über einer Milliarde Dollar.
Dabei tritt ein wiederkehrendes Problem auf: Jedes Mal, wenn ein neues Kartenset erscheint, verfestigen sich die starken Kombinationen innerhalb weniger Monate. Das Paper beschreibt das Metagame – das Gesamtbild der zu dieser Zeit als stark geltenden Strategien – dabei als „sehr eingeschränkt, stagnierend und repetitiv". Auf dem Papier existieren Tausende Karten, tatsächlich gespielt wird aber nur eine Handvoll.
Ein zweites Problem ist Power Creep: das Phänomen, dass die Leistungswerte neuer Karten Schritt für Schritt steigen, um sie attraktiv wirken zu lassen. Das Paper schreibt, das trete „in praktisch jedem fortlaufend betriebenen Spiel" auf.
Am meisten bedauern die Autoren jedoch, dass die Bindung an einzelne Karten verloren geht. Früher bewahrte man eine Karte mit einer geliebten Figur wie einen Schatz. In einem Umfeld, das allein nach Stärke selektiert, überlebt diese Beziehung nicht. Ob sich das zurückgewinnen lässt, ist der Ausgangspunkt dieser Forschung. Slay the Spire (Mega Crit, 2019), Spielszene (von der Steam-Store-Seite)
Automatische Kartengenerierung an sich ist nicht neu. Das Paper reiht als vorherige Arbeiten RoboRosewater (2015) auf, das ein neuronales Netz Magic-Karten schreiben ließ, Summerville & Mateas (2016), die Kartentexte mit einem Sequenzmodell vervollständigten, sowie Chen & Guy (2020), die Hearthstone-Karten mittels Grammatik erzeugten und sogar deren Balance vorhersagten.
Als neu beansprucht dieses Paper zwei Ergänzungen: zum einen, nicht nur Attacken und Werte, sondern gleichzeitig auch das Bild zu erzeugen; zum anderen, die spielende Person selbst an den Eingang der Generierung zu setzen. Die Autoren stellen drei Fragen: Wie lassen sich Fortschritte generativer KI über mehrere Aspekte hinweg – Aussehen und Mechanik – bündeln? Wie weit lässt sich bei spielerzentrierter Generierung sowohl die Treue zur eigenen Vorstellung als auch die visuelle Qualität bewahren? Und welche iterativen Korrekturmethoden eignen sich am besten, um die Lücke zwischen Vorstellung und generiertem Ergebnis zu schließen?
Eine Karte in fünf Schritten zusammensetzen
Das System gliedert sich in fünf Schritte: Referenzkarten sammeln, ähnliche Karten abrufen, Werte und Attacken mit einem Textmodell ausfüllen, das Bild mit einem Bildmodell zeichnen und zuletzt alles zum Layout einer Karte zusammensetzen.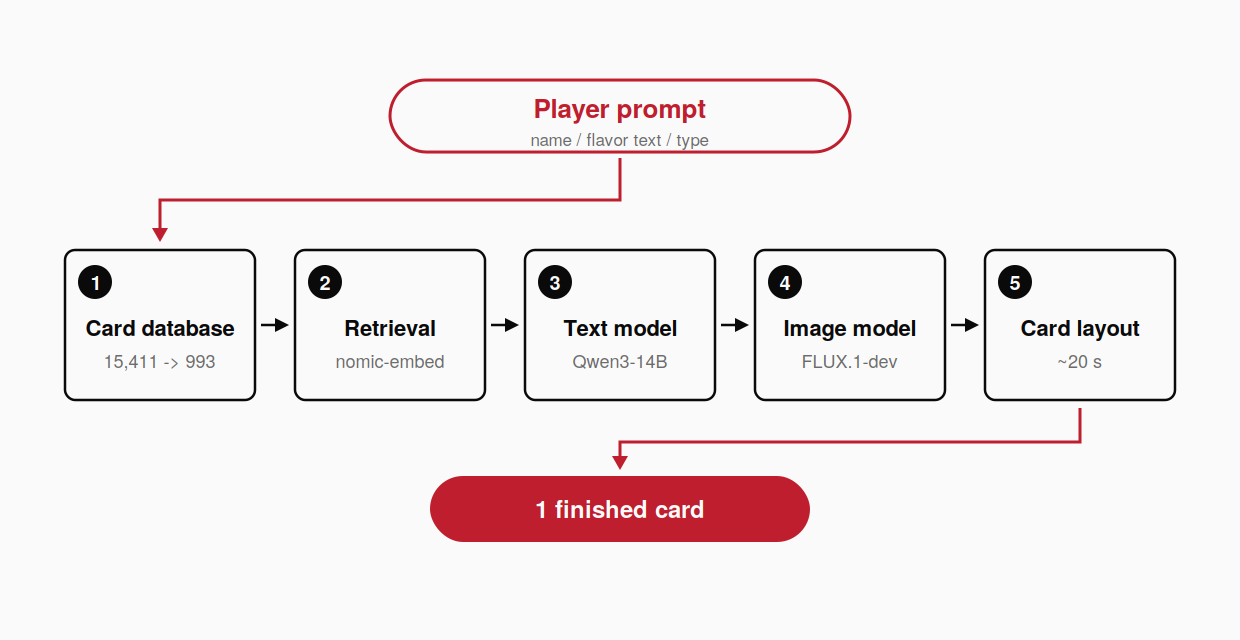 Der im Paper beschriebene Ablauf der fünf Schritte (Diagramm vom Autor erstellt, keine Reproduktion einer Abbildung aus dem Paper)
Schritt eins: Aus der offiziellen Pokémon TCG Developer Portal API werden 15.411 Karten eingelesen und auf 993 eingegrenzt – übrig bleiben nur Basis-Pokémon bis zur neunten Generation. Die Karten werden als strukturierte Daten im JSON-Format behandelt, einem Format aus Feldnamen und zugehörigen Werten: Name, Beschreibungstext, Typ, KP, Attacken, Schwächen und Ähnliches.
Schritt zwei ist das Retrieval. Das System sucht nach bestehenden Karten, die der Eingabe der spielenden Person (Name, Beschreibungstext, Typ) nahekommen. Verwendet wird das Einbettungsmodell nomic-embed-text-v1.5, ein Werkzeug, das Text in eine Zahlenreihe umwandelt, um semantische Nähe messbar zu machen. Dieses Verfahren, nahe Beispiele als Vorlage mitzugeben, nennt das Paper RAG (Retrieval-Augmented Generation – erst Vorlagen abrufen, dann schreiben lassen).
In Schritt drei füllt ein Textmodell die Lücken. Verwendet wird Qwen3-14B. Die Anweisung lautet sinngemäß: „Fülle die Felder hp, abilities, attacks, resistances, weaknesses und retreatCost des von mir begonnenen JSON aus." Es wird also nicht von einem leeren Blatt aus erzeugt, sondern es werden feste Felder ausgefüllt.
Schritt vier ist das Bild. Das Bildgenerierungsmodell FLUX.1-dev-Q8 läuft lokal über ComfyUI. Um den Stil einheitlich zu halten, mischen die Autoren zwei LoRAs – eine Technik, die den Stil eines Modells mit wenigen zusätzlichen Trainingsdaten annähert: einen Niji-Stil und einen Stil „im Pokémon-Look (Ken Sugimori)". In Schritt fünf wird die Karte mit dem Web-Tool Pokécardmaker zum fertigen Layout zusammengesetzt. Pro Karte dauert das etwa 20 Sekunden, berechnet auf einer NVIDIA RTX 5090.
Was die 196 Karten zeigten
An der Evaluation nahmen 49 Personen teil, Masterstudierende der Fachrichtungen Game and Media Technology sowie Artificial Intelligence, davon 75,5 % männlich und 24,5 % weiblich. Jede Person erstellte vier Karten, sodass insgesamt 196 zusammenkamen. Die Teilnehmenden konnten die gesamte Pipeline entweder auf dem eigenen Rechner installieren oder einen bereitgestellten Server nutzen, und sie durften Modelle, Parameter und den System-Prompt selbst anpassen.
Bewertet wurde auf einer fünfstufigen Skala. Die Zufriedenheit mit dem Aussehen lag im Schnitt bei 4,25 (Standardabweichung 0,9). „Wie nah kommt das Bild der eigenen Vorstellung" erreichte 3,95 (1,07). „Wie gut passen Attacken und Werte zur Vorstellung" erreichte 4,04 (0,75). Alle drei Werte liegen auf der positiven Seite.
Aufschlussreicher ist die Aufschlüsselung. Beim Bild waren 35,5 % beim ersten Versuch zufrieden, 38,4 % nach kleinen Nachbesserungen. Bei Attacken und Werten lag die Zufriedenheit beim ersten Versuch mit 51,0 % noch höher. Nie zufrieden wurden 11,6 % beim Bild und 10,2 % bei Attacken und Werten. In Summe kamen beim Aussehen 88,4 % und bei der Mechanik 89,8 % letztlich zu einem zufriedenstellenden Ergebnis.
Auch die Art der Korrektur wurde erfasst. Am häufigsten, mit 51,8 %, war das Umschreiben des Prompts. Erneutes Generieren mit demselben Prompt kam auf 18,8 %, das Ändern der ursprünglichen Idee auf 13,4 %, das Feinjustieren von Parametern auf 6,3 % und manuelles Nachbessern auf 0,9 %. „Aufgegeben" gaben 8,9 % an.
Schließlich gaben 93,5 % an, das fertige Design sei „ihre eigene Idee", nur 1,4 % nannten es „die Idee der KI". 14 Teilnehmende hielten ausdrücklich fest, dass das Ergebnis ihre Erwartungen übertroffen habe, und 7 sagten, sie mochten das generierte Ergebnis lieber als das, was sie sich ursprünglich vorgestellt hatten.
Die Freitextantworten wurden mittels thematischer Analyse ausgewertet, bei der beide Autoren unabhängig voneinander Codes vergaben. Daraus geht auch hervor, dass 10 Teilnehmende Fehlschläge nicht dem Konzept, sondern der unzureichenden Leistungsfähigkeit des Modells zuschrieben. Das Werkzeug sei eben noch unausgereift, der Ansatz selbst aber schlüssig – so wurde es aufgenommen.
In den Abbildungen des Papers stehen benannte Beispiele nebeneinander. Als gelungene Beispiele werden unter anderem Glister, Ferrafox und Möbiusect genannt. Als Fehlschläge gelten Zagarin (unzureichend beschriebene Attacke), Aurellune (zu stark) und Oricrane (wiederholter Text).
Was Entwicklerinnen und Entwickler mitnehmen können
Erstens: Statt „frei erzeugen zu lassen" sollte man ein Design wählen, das feste Felder ausfüllen lässt. Das System dieser Studie nutzt die Struktur bestehender Karten direkt als Vorlage. Würde ich selbst ein Deckbau-Spiel entwickeln, würde ich der KI ein Formular mit Lücken übergeben, kein leeres Blatt. Je stärker man den Freiheitsgrad der Generierung einschränkt, desto höher sollte der Anteil brauchbarer Ergebnisse ausfallen.
Zweitens: Der Weg zur Korrektur sollte eher auf „anders formulieren" als auf „neu erzeugen" setzen. Mehr als die Hälfte (51,8 %) löste ihr Problem durch Umschreiben des Prompts. Eine Oberfläche, die nur einen großen Neu-generieren-Button anbietet, passt nicht zu dem, wie Menschen tatsächlich korrigieren. Ein Eingabefeld, das sich direkt vor Ort umschreiben lässt, wirkt besser. Balatro (LocalThunk / Playstack, 2024), Spielszene (von der Steam-Store-Seite)
Drittens: Ein Mechanismus, der die „8,9 % Aufgeben" erfasst, gehört dazu. Wie gut ein Generierungswerkzeug wirklich ist, erkennt man nicht, wenn man nur die gelungenen Ergebnisse betrachtet. Wird festgehalten, nach welchem Versuch jemand aufgegeben hat und an welchem Schritt es stockte, wird sichtbar, wo als Nächstes nachgebessert werden muss.
Viertens: Aussehen und Mechanik getrennt abfragen. In dieser Studie wurden die Zufriedenheit mit dem Bild und die mit Attacken und Werten getrennt gemessen, und die Werte fielen auch unterschiedlich aus. Oft genügt es, nur eine der beiden Seiten zu korrigieren. Auch bei der automatischen Erzeugung von Rätseln halte ich es für sinnvoll, „gefällt mir das Aussehen" und „hat sich das Lösen gut angefühlt" getrennt zu erfragen.
Fünftens, eine Frage des Maßstabs. Dieses System läuft auf einem einzigen PC. Das Textmodell liegt in der 14B-Klasse, das Bildmodell ist ein quantisiertes FLUX, die Generierung dauert pro Karte etwa 20 Sekunden. Auch ohne externe API ist das ein Maßstab, der sich im Rahmen einer Einzelentwicklung ausprobieren lässt. Dass die Teilnehmenden es in ihrer eigenen Umgebung installieren und betreiben konnten, untermauert das.
Sechstens, das ist die Warnung: generierte Karten nicht direkt in einen Kontext einbringen, in dem Sieg und Niederlage zählen. Der Grund folgt im nächsten Abschnitt. Sicherer ist es, zunächst mit Einzelspielmodus, Sammeln oder Vorzeigen zu beginnen – Orten, an denen niemandem durch eine Niederlage geschadet wird.
Was noch nicht bekannt ist
Die von den Autoren selbst eingeräumten Schwächen sind eindeutig. Die größte ist, dass keine der erzeugten Karten je gespielt wurde. Das Paper hält ausdrücklich fest, dass sie weder in der gedruckten noch in der digitalen Version eingesetzt wurden. Die Balance bleibt somit ungeprüft.
Die Autoren räumen auch die Bedeutung der Balance ein. Es gibt eine Passage, die sinngemäß besagt, das Generierte müsse bestehen können, ohne andere zu dominieren oder von ihnen dominiert zu werden. Sie erwähnen ihren eigenen Kampfsimulator, verschieben diese Arbeit aber, da sie den Rahmen dieses Papers deutlich sprengen würde.
Weiter nennen die Autoren die einseitige Stichprobe von 49 Masterstudierenden aus Spiele-/KI-Studiengängen, die Tatsache, dass nur Pokémon-Karten behandelt und keine anderen TCGs getestet wurden, sowie Bedenken zu Urheberrecht und geistigem Eigentum. Als Schwächen des Modells selbst nennen sie Halluzinationen (etwa das Erfinden nicht existierender Attacken), Grenzen von Gedächtnis und Schlussfolgerung, eine Schwäche im Umgang mit Zahlen sowie Nichtdeterminismus bei gleicher Eingabe. Auch dass jede Karte isoliert erzeugt wird, ohne den Kontext des gesamten Sets zu berücksichtigen, räumen sie ein.
Was ich, Fukai, hier anmerken möchte, betrifft die Position der Bewertenden. Ob das Ergebnis der eigenen Vorstellung entsprach, wurde von der Person bewertet, die die Karte selbst erstellt hat. Was man selbst mit Mühe geschaffen hat, neigt man dazu, positiver zu sehen. Wie eine dritte Person dieselben 196 Karten bewerten würde, lässt sich aus dieser Studie nicht ablesen.
Ein zweiter Punkt von mir betrifft das Fehlen einer Vergleichsgruppe. Der Wert von 93,5 % für „meine eigene Idee" liegt nahe an der Obergrenze. Doch ohne eine Kontrollgruppe – etwa Personen, denen einfach eine von der KI allein erzeugte Karte übergeben wurde – fehlt der Maßstab, um zu beurteilen, ob dieser Wert hoch ist. Auch die von den Autoren genannte „prozedurale Verbundenheit" liest sich für mich eher als Behauptung denn als mit einer eigenen Bindungs-Skala gemessenes Ergebnis.
Wie Fukai es liest
Ich möchte diese Studie als eine Frage der Platzierung lesen: Wo setzt man die generative KI ein? In diesem System denkt sich die KI nichts aus. Die Idee kommt von der spielenden Person, und die KI übernimmt lediglich die Rolle, feste Felder auszufüllen. Deshalb, so meine Vermutung, blieb das Gefühl der Urheberschaft erhalten. In der Sprache der Designkritik ist das eher eine Automatisierung der Reinschrift als eine Automatisierung der Erschaffung. Hätte man die Reihenfolge umgekehrt und die KI das Konzept vorschlagen lassen, wäre der Wert von 93,5 % vermutlich nicht zustande gekommen. Das ist allerdings meine eigene Lesart, nichts, was das Paper in einem Vergleichsexperiment gezeigt hätte.
Zum Schluss
Für alle, die sich in diesem Feld weiter umsehen möchten, hier einige der Arbeiten, auf denen das Paper aufbaut. RoboRosewater (2015) war ein früher Versuch, ein neuronales Netz Magic-Karten schreiben zu lassen. Summerville & Mateas (2016) vervollständigten Kartentexte mit einem Sequenzmodell. Chen & Guy (2020) erzeugten Hearthstone-Karten mittels Grammatik und gingen so weit, deren Balance vorherzusagen. Ich nenne sie hier nur als Zitate aus dem Paper; die Originale habe ich nicht erneut gelesen.
Auf dieser Seite haben wir zuvor auch das Paper zu AutoBG vorgestellt, das den Entwurf eines Brettspiels von der Idee bis zur Fertigstellung unterstützt. Dort geht es um die Seite „die KI entwerfen lassen". Liest man das neben dem heutigen Paper, zeichnet sich klarer ab, wie sehr sich das Ergebnis danach richtet, wo man die generative KI platziert.
Quellenangaben
In diesem Artikel herangezogene Paper und Materialien:
- Google-Scholar-Profil von Johannes Pfau (Erstautor, Assistant Professor an der Universität Utrecht)
- Vorarbeiten, auf denen dieser Beitrag aufbaut: Milewicz / RoboRosewater (2015) zur Magic-Kartengenerierung, Summerville & Mateas (2016) zur Kartenvervollständigung mittels Sequenzmodell, Chen & Guy (2020) zur grammatikbasierten Hearthstone-Generierung mit Balance-Vorhersage, Summerville et al. (2018) als PCG-Überblicksarbeit, und Maleki & Zhao (2024) als Überblick zu LLMs in der PCG. Ich nenne sie hier nur als Zitate aus dem Paper; die Originale habe ich nicht erneut gelesen.
- Quellen der im Artikel verwendeten Spielbilder: die Steam-Store-Seite von Magic: The Gathering Arena (Wizards of the Coast, 2023), die von Slay the Spire (Mega Crit, 2019) sowie die von Balatro (LocalThunk / Playstack, 2024). Keines davon steht in Zusammenhang mit dem Paper; sie wurden als real existierende, thematisch passende Kartenspiele herangezogen.
- Das Diagramm der fünf Schritte ist eine eigene Arbeit des Autors und keine Reproduktion einer Abbildung aus dem Paper.
Reactions (no login)
Anonymous • one of each per visitor per day
関連シリーズ
Paper Digest第66回 / 全104回