TAG
#cognitive-science
0 レビュー · 6 エッセイ
関連エッセイ
Williams ら: 数独を解く脳を撮った研究は、世界に6本しかなかった — Fukai が読む
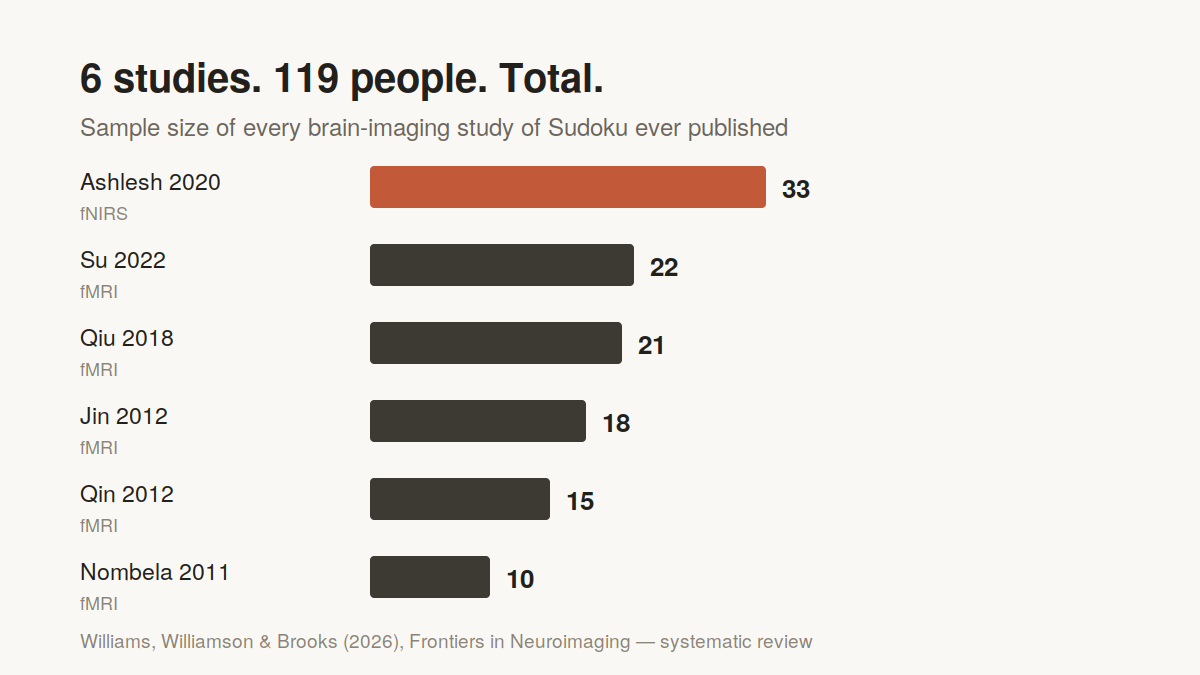
英・南アの3人による査読済みの系統的レビュー(Frontiers in Neuroimaging、2026年4月20日公開)。数独を解く脳を撮影した研究は世界に6本(fMRI 5本・fNIRS 1本)、参加者は合計119人しかいなかった。共通して前頭前野と頭頂葉の実行制御回路と前部帯状回が働き、難しい盤面ほど内向きの思考に関わる回路は静まっていた。ただし著者らは、数独の訓練効果がパズルの外へ広がるかには「さらなる証拠が必要」としている。
Collins ら: 人は初見のゲームを「1手先・6回」だけ想像して判断する — Fukai が読む
Katherine M. Collins ら(MIT ほか)による Nature 掲載の査読済み論文。三目並べの親戚にあたる新作ゲーム121種類を1,000人以上に見せ、遊ぶ前の「公平そうか」「面白そうか」の判断を測った。1手先だけ読む手選びを6回の模擬プレイに使う Intuitive Gamer モデルが、公平さの判断を R2=0.81(人のデータの上限は0.82)で説明し、深く読む Expert Gamer(0.65)や MCTS(0.60)を上回った。
Zhao ら: 人はパズルを解きながら「自分専用の部品」を作る — Fukai が読む
Pinzhe Zhao ら4名による arXiv preprint(査読前)。10×10 のマス目に絵を作る 14 問の課題で、参加者が途中の形を「部品」として保存し再利用する様子を観察した。部品を使った手の割合は 21% から 87% に上がり、後半では 9 割前後が同じ形を保存。人の解答時間と手数についてきたのは最短手順の長さ(r=-.20)ではなく、モデルが調べた候補の数(r=.82)だった。参加者 30 人・単一条件の探索的研究という留保つきで読む。
Ye ほか: 子ども向け知能検査で画像も扱う AI(MLLM)を測る — Fukai が読む
ShanghaiTech 大学の Hengwei Ye らによる、子ども向け知能検査(ウェクスラー式)に着想した MLLM 評価ベンチマーク KidGym の論文(arXiv プレプリント)。実行・知覚推論・記憶・学習・計画の5能力を2Dグリッド上の12課題・難易度3段階で測り、9モデルを評価。上位モデルでも抽象図形パズルは最高0.30、数え上げは人間1.00に対し最高0.72にとどまった。
Ahn et al.: パズルの難しさは「見た目」ではなく「概念」に宿る — Fukai が読む
ボストン大学の Ahn らによる、抽象推論ベンチマーク ARC を人間向けに組み直した CogARC の論文(arXiv プレプリント)。のべ 260 人のグリッドパズル解答を一手ずつ記録し、難しさは盤面の大きさや色数ではなくルールの概念的複雑さで決まること、人は間違えるときも同じ誤答へそろって収束することを示した。
Nasvytis & Fan: ひらめきと「転移」は話し方に表れる — Fukai が読む
スタンフォードの Nasvytis と Fan による、ひらめきと転移を思考発話から捉えた論文。参加者189人にマッチ棒数式パズルを5問解かせ、同じ型を繰り返す群は初正解後も速く正確になり(試行5で正答率0.75)、問題の型を口に出す割合が約7倍に増えた。転移の印は『コツを言葉にできること』だと読める。