RÉSUMÉ DE RECHERCHE · 2026-08-23
Pfau et Vrettis : et si l'on laissait les joueurs créer leur propre carte Pokémon — lu par Fukai
PCG / jeu de cartes à collectionner / IA générative et sentiment de paternité
Résumé en un paragraphe
« La carte Pokémon que vous venez d'imaginer devient, en vingt secondes, une carte à l'allure authentique. » L'article que j'ai lu aujourd'hui met vraiment cette idée à l'épreuve. Un joueur saisit un nom et un bref descriptif, et l'IA produit d'un seul tenant l'illustration, les techniques et les valeurs numériques d'une carte terminée. Quarante-neuf étudiants en ont fabriqué 196 au total. Capture d'écran de « Magic: The Gathering Arena » (Wizards of the Coast, 2023), tirée de sa page boutique Steam
Ce qui intéresse, c'est la nature de cette satisfaction. La satisfaction visuelle atteint en moyenne 4,25 sur 5. Et lorsqu'on leur a demandé à qui appartenait l'idée du résultat final, 93,5 % ont répondu que c'était la leur. Bien que l'IA ait fait le travail, ils la ressentent comme leur propre création. Les auteurs appellent cela la « relation procédurale » (procedural relatedness).
Une réserve s'impose cependant. Les cartes obtenues n'ont encore jamais été utilisées en partie. Ni les cartes trop puissantes ni les cartes trop faibles n'ont été vérifiées en situation réelle de jeu. J'y reviendrai en détail dans la seconde moitié de l'article.
À propos de cet article
L'article s'intitule « From LLM-Driven Trading Card Generation to Procedural Relatedness: A Pokémon Case Study ». Ses deux auteurs, Johannes Pfau et Panagiotis Vrettis, sont tous deux rattachés à l'université d'Utrecht, aux Pays-Bas. Il a été mis en ligne sur arXiv le 30 avril 2026 sous forme de preprint, c'est-à-dire un manuscrit publié avant tout passage par la relecture par les pairs. Il porte le numéro arXiv:2604.27972v1, est classé en cs.AI, et affiche une licence CC BY-NC-ND 4.0.
Je l'ai choisi aujourd'hui pour deux raisons. D'une part, les articles récemment traités dans cette rubrique penchaient fortement vers le type « faire résoudre un jeu par une IA et noter le résultat ». D'autre part, cette étude place, chose rare, le ressenti du créateur au centre de son propos. Peu de travaux sur l'IA générative mesurent si le résultat a été perçu comme le sien propre plutôt que sa seule qualité.
Seuls quatre mois environ se sont écoulés depuis sa mise en ligne, on peut donc supposer que le nombre de citations reste proche de zéro. La discussion à son sujet n'en est pas encore au stade de la diffusion large. Je n'ai par ailleurs trouvé dans le texte aucune mention d'un passage par la relecture par les pairs. C'est avec cela à l'esprit que je l'aborde.
Le problème où seules les cartes puissantes survivent
Les jeux de cartes à collectionner (TCG, où l'on constitue son propre paquet à partir de cartes rassemblées puis on s'affronte) forment une industrie considérable. L'article prend pour point de départ Magic: The Gathering, en 1993, et indique que le genre pèse aujourd'hui plusieurs milliards de dollars. Magic seul, précise-t-il, réunit plus de 50 millions de joueurs et dépasse le milliard de dollars de chiffre d'affaires.
Un problème récurrent s'y pose. À chaque nouvelle extension, les combinaisons les plus puissantes se figent en l'espace de quelques mois. L'article décrit le métajeu qui en résulte — l'ensemble des stratégies jugées dominantes à un moment donné — comme « très limitant, figé et répétitif ». Des milliers de cartes existent sur le papier, mais seule une poignée finit réellement jouée.
Le second problème est le power creep : à force de vouloir rendre les nouvelles cartes attrayantes, leur puissance augmente peu à peu, extension après extension. L'article écrit que ce phénomène se produit dans « pratiquement tout jeu maintenu en exploitation ».
Ce que les auteurs regrettent le plus, c'est la disparition de l'attachement aux cartes. On chérissait autrefois une carte parce qu'on aimait le personnage qu'elle représentait. Dans un environnement trié uniquement selon la puissance, cette relation ne survit pas. Retrouver cela est le point de départ de cette recherche. Capture d'écran de « Slay the Spire » (Mega Crit, 2019), tirée de sa page boutique Steam
La génération automatique de cartes n'est pas nouvelle en soi. L'article aligne des travaux antérieurs : RoboRosewater (2015), qui faisait rédiger des cartes Magic par un réseau de neurones ; Summerville et Mateas (2016), qui complétaient la description des cartes à l'aide d'un modèle séquentiel ; et Chen et Guy (2020), qui généraient des cartes Hearthstone à partir d'une grammaire tout en prédisant leur équilibrage.
Ce que cet article revendique comme nouveau, ce sont deux ajouts. D'une part, générer l'illustration en même temps que les techniques et les valeurs, et non ces dernières seules. D'autre part, placer le joueur lui-même à l'entrée du pipeline de génération. Les auteurs posent trois questions : comment fédérer les avancées de l'IA générative sur plusieurs facettes à la fois, visuelle et mécanique ; dans une génération centrée sur le joueur, jusqu'où peut-on préserver à la fois la fidélité à l'idée de la personne et la qualité visuelle ; et enfin, quelles stratégies de correction conviennent le mieux pour resserrer l'écart entre l'idée initiale et le résultat généré.
Cinq étapes pour assembler une carte
Le dispositif se décompose en cinq étapes : rassembler des cartes de référence, retrouver des cartes similaires, remplir les valeurs et les techniques à l'aide d'un modèle de texte, dessiner l'illustration avec un modèle d'image, et enfin assembler le tout dans la mise en forme d'une carte.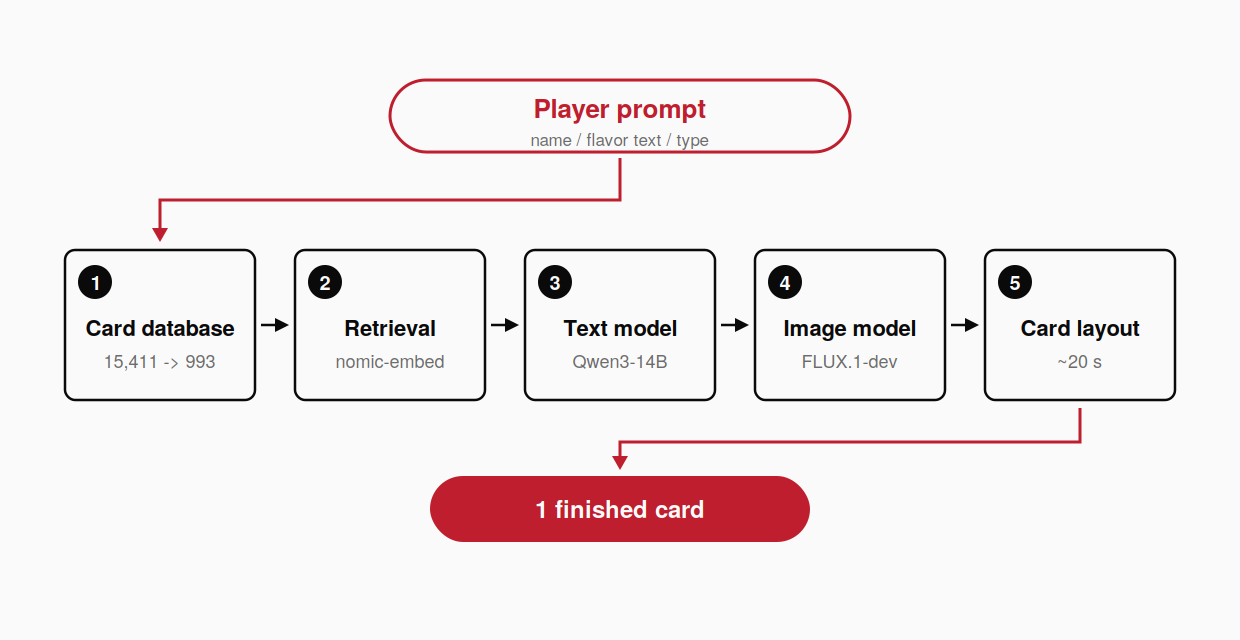 Le déroulement en cinq étapes décrit dans l'article (schéma réalisé par l'auteur ; ce n'est pas une reproduction des figures de l'article)
Première étape : les auteurs importent 15 411 cartes depuis l'API officielle du Pokémon TCG Developer Portal, puis les réduisent à 993, en ne conservant que les Pokémon de base jusqu'à la neuvième génération. Chaque carte est traitée comme une donnée structurée au format JSON (un format associant des noms de champs à des valeurs) : nom, texte descriptif, types, PV, techniques, faiblesses, etc.
La deuxième étape est la recherche. Le système cherche, parmi les cartes existantes, celles qui se rapprochent de ce que le joueur a saisi — nom, texte descriptif, types. Il utilise pour cela un modèle d'embedding, nomic-embed-text-v1.5 (un outil qui convertit un texte en une suite de nombres afin de pouvoir en mesurer la proximité de sens). Cette méthode, qui consiste à transmettre ces exemples proches comme modèles, est ce que l'article appelle du RAG (retrieval-augmented generation, une méthode où l'on récupère d'abord des modèles avant de faire rédiger le résultat).
À la troisième étape, un modèle de texte comble les vides. Le modèle utilisé est Qwen3-14B. L'instruction prend la forme suivante : « complète les champs hp, abilities, attacks, resistances, weaknesses et retreatCost du JSON que j'ai commencé à écrire ». On ne le fait pas créer à partir d'une page blanche, mais remplir des champs déjà déterminés.
La quatrième étape est l'illustration. Le modèle de génération d'image FLUX.1-dev-Q8 tourne localement dans ComfyUI. Pour uniformiser le style graphique, deux LoRA sont mélangés — un LoRA, technique d'entraînement additionnel qui rapproche le style d'un modèle avec peu de données supplémentaires, de style Niji, et un autre de style « Pokémon (façon Ken Sugimori) ». La cinquième étape assemble le tout en une carte au moyen d'un outil web, Pokécardmaker. Chaque carte prend environ 20 secondes, les calculs ayant été effectués sur une NVIDIA RTX 5090.
Ce que révèlent les 196 cartes
Quarante-neuf personnes ont participé à l'évaluation : des étudiants de master en technologies des jeux et des médias et en intelligence artificielle, à 75,5 % des hommes et 24,5 % des femmes. Chacun a produit quatre cartes, pour un total de 196. Les participants pouvaient installer l'ensemble sur leur propre ordinateur ou utiliser un serveur mis à disposition, et étaient libres de modifier les modèles, les paramètres et les instructions.
Les notes s'échelonnent sur cinq points. La satisfaction visuelle atteint en moyenne 4,25 (écart-type 0,9). « À quel point l'image obtenue se rapproche de ce que vous aviez imaginé » atteint 3,95 (1,07). « À quel point les techniques et les valeurs correspondent au concept » atteint 4,04 (0,75). Les trois scores penchent du côté positif.
Le détail est plus instructif encore. Pour l'illustration, 35,5 % se sont déclarés satisfaits dès la première tentative, et 38,4 % après un léger ajustement. Pour les techniques et valeurs, la satisfaction dès la première tentative est encore plus élevée, à 51,0 %. N'ont jamais atteint la satisfaction : 11,6 % pour l'illustration, 10,2 % pour les mécaniques. Au total, 88,4 % des résultats visuels et 89,8 % des résultats mécaniques ont fini par satisfaire les participants.
La répartition des méthodes de correction est également donnée. Réécrire l'instruction arrive en tête avec 51,8 %. Regénérer avec la même instruction représente 18,8 %, modifier l'idée d'origine 13,4 %, ajuster de petits paramètres 6,3 %, et retoucher manuellement 0,9 %. Enfin, 8,9 % ont abandonné.
Enfin, 93,5 % ont attribué le résultat final à leur propre idée, contre 1,4 % qui l'ont attribué à l'IA. Quatorze participants ont explicitement dit que le résultat dépassait leurs attentes, et sept ont déclaré préférer le résultat généré à ce qu'ils avaient initialement imaginé.
Les réponses ouvertes ont été organisées selon une procédure où les deux auteurs ont codé le matériau indépendamment (analyse thématique). On y apprend que dix participants ont attribué leurs échecs non pas à la méthode elle-même, mais aux limites de performance du modèle : l'outil serait simplement immature, l'approche restant, elle, bien fondée.
Les figures de l'article présentent des exemples nommés. Parmi les réussites figurent Glister, Ferrafox et Möbiusect. Parmi les échecs, Zagarin (technique insuffisamment décrite), Aurellune (trop puissante) et Oricrane (texte répétitif).
Ce que les créateurs peuvent en retenir
Premièrement : concevoir le système pour faire remplir des champs déterminés, plutôt que pour créer librement. Le dispositif de cette étude reprend directement la structure des cartes existantes comme gabarit. Si je devais construire un jeu de construction de deck, je préférerais confier à l'IA un formulaire à trous plutôt qu'une page blanche. Plus on réduit la liberté de génération, plus la part de résultats exploitables devrait augmenter.
Deuxièmement : faire du « reformuler » le principal chemin de correction, plutôt que du « refaire ». Plus de la moitié des participants (51,8 %) ont résolu leur problème en réécrivant leur instruction. Une interface qui ne met en avant qu'un gros bouton de régénération ne correspond pas à la manière dont les gens corrigent réellement les choses. Pouvoir modifier le champ de saisie sur place est plus efficace. Capture d'écran de « Balatro » (LocalThunk / Playstack, 2024), tirée de sa page boutique Steam
Troisièmement : mettre en place un mécanisme pour comptabiliser les « 8,9 % qui abandonnent ». On ne peut pas juger de la qualité d'un outil de génération en n'observant que les résultats réussis. Enregistrer à quelle tentative l'utilisateur a décroché, et à quelle étape il s'est arrêté, permet de voir où porter la prochaine correction.
Quatrièmement : interroger séparément l'apparence et le fonctionnement. Cette étude a mesuré séparément la satisfaction visuelle et la satisfaction mécanique, et les valeurs obtenues divergent. Il est fréquent qu'un seul des deux côtés ait besoin d'être corrigé. Pour la génération automatique de puzzles également, je pense qu'il vaut mieux distinguer « la satisfaction visuelle » et « la sensation d'avoir bien résolu ».
Cinquièmement, une remarque sur l'échelle. Ce dispositif tourne sur un seul ordinateur personnel : un modèle de texte de classe 14B, un FLUX quantifié pour l'image, environ 20 secondes par carte. Cette échelle reste à la portée d'un développement individuel, sans dépendre d'une API externe. Le fait que les participants aient pu l'installer et le faire fonctionner sur leur propre machine le confirme.
Sixièmement, et c'est une mise en garde : ne pas introduire directement les cartes générées dans un contexte où l'enjeu est la victoire ou la défaite. La raison en est exposée dans la section suivante. Il est plus sûr de commencer par des contextes où personne n'est lésé par une défaite — le solo, la collection, ou le simple partage entre joueurs.
Ce que l'on ignore encore
Les faiblesses reconnues par les auteurs eux-mêmes sont claires. La principale est que les cartes produites n'ont jamais été jouées. L'article précise explicitement qu'elles n'ont été déployées ni en version imprimée, ni en version numérique. L'équilibrage reste donc entièrement non vérifié.
Les auteurs reconnaissent aussi l'importance de l'équilibrage. Une phrase indique en substance que le produit généré doit tenir sans dominer les autres cartes ni être dominé par elles. Ils évoquent leur propre simulateur de combats, tout en reportant ce travail au motif qu'il dépasserait largement le cadre de cet article.
Les auteurs mentionnent par ailleurs le biais de l'échantillon, limité à 49 étudiants de master en jeux vidéo et en IA ; le fait que seules les cartes Pokémon aient été testées, sans essai sur d'autres TCG ; et des préoccupations liées au droit d'auteur et à la propriété intellectuelle. Côté modèle, ils citent les hallucinations (inventer des techniques qui n'existent pas), les limites de la mémoire et du raisonnement, la faiblesse dans le traitement des nombres, et l'instabilité des résultats pour une même entrée. Ils reconnaissent également que chaque carte est générée indépendamment, sans tenir compte du contexte de l'ensemble du set.
Ce que je souhaite souligner ici, c'est la position de l'évaluateur. Celui qui a noté « à quel point le résultat correspond à ce qu'il avait imaginé » est la personne même qui a créé la carte. On a tendance à surestimer ce dans quoi on a mis soi-même du travail. Comment un tiers évaluerait ces mêmes 196 cartes, cette étude ne peut pas nous le dire.
Mon second point est l'absence de groupe de comparaison. Le chiffre de 93,5 % pour « ma propre idée » est proche du plafond. Mais faute, par exemple, d'un groupe à qui l'on aurait simplement remis des cartes que l'IA aurait créées seule, il n'existe aucune règle permettant de juger si 93,5 % est un chiffre élevé ou non. La « relation procédurale » que les auteurs revendiquent me semble, elle aussi, davantage affirmée que vérifiée par une échelle mesurant l'attachement lui-même.
La lecture de Fukai
Je souhaite lire cette étude comme une question de placement : où positionner l'IA générative ? Ici, le système ne fait pas imaginer l'IA. C'est le joueur qui invente, tandis que l'IA se contente de remplir des champs déjà déterminés. C'est pour cela, je crois, que le sentiment de paternité a subsisté. Pour reprendre le vocabulaire de la critique de conception, ceci se rapproche moins d'une « automatisation de la création » que d'une « automatisation de la mise au propre ». Si l'on avait inversé l'ordre, en laissant l'IA proposer le concept lui-même, je doute que le chiffre de 93,5 % aurait été atteint. Ceci reste ma propre lecture, non un résultat que l'article aurait démontré par une expérience comparative.
Pour conclure
Pour ceux qui veulent élargir la carte de ce domaine, voici quelques travaux sur lesquels s'appuie cet article. RoboRosewater (2015) fut une des premières tentatives de faire rédiger des cartes Magic par un réseau de neurones. Summerville et Mateas (2016) ont complété la description des cartes à l'aide d'un modèle séquentiel. Chen et Guy (2020) ont généré des cartes Hearthstone à partir d'une grammaire, jusqu'à en prédire l'équilibrage. Dans cet article, je ne cite ces travaux que via les références de l'article original ; je n'ai pas relu les sources primaires.
Ce site avait déjà présenté par le passé l'article sur AutoBG, un système qui accompagne la conception d'un jeu de plateau de l'idée jusqu'au produit fini. Celui-là se situait du côté du « laisser l'IA concevoir ». Le lire en regard de l'article d'aujourd'hui devrait faire ressortir plus nettement comment le résultat change selon la place où l'on installe l'IA générative.
Références
Articles et ressources associées cités dans cet article :
- Profil Google Scholar de Johannes Pfau (premier auteur, Assistant Professor à l'université d'Utrecht)
- Travaux antérieurs sur lesquels s'appuie cet article : Milewicz / RoboRosewater (2015) sur la génération de cartes Magic, Summerville et Mateas (2016) sur la complétion de cartes par modèle séquentiel, Chen et Guy (2020) sur la génération de cartes Hearthstone par grammaire avec prédiction d'équilibrage, Summerville et al. (2018), une synthèse sur le PCG, et Maleki et Zhao (2024), une synthèse sur les LLM appliqués au PCG. Je ne cite ces travaux que via les références de l'article original ; je n'ai pas relu les sources primaires.
- Origine des images de jeux figurant dans l'article : la page boutique Steam de Magic: The Gathering Arena (Wizards of the Coast, 2023), celle de Slay the Spire (Mega Crit, 2019), et celle de Balatro (LocalThunk / Playstack, 2024). Aucune n'a de lien avec l'article ; elles ont été choisies comme jeux de cartes réels en rapport avec le sujet.
- Le schéma des cinq étapes est une réalisation personnelle de l'auteur, et non une reproduction des figures de l'article.
Reactions (no login)
Anonymous • one of each per visitor per day
関連シリーズ
Paper Digest第66回 / 全104回