论文摘要 · 2026-08-23
Pfau & Vrettis:让玩家做出专属自己的宝可梦卡牌会怎样——Fukai 解读
PCG / 集换式卡牌游戏 / 生成式AI与创作者意识
一段话总结
「自己构思的宝可梦卡牌,20秒就能变成一张以假乱真的实物。」我今天读的,正是一篇真正做出这件事的论文。玩家写入名字和简短设定后,AI 便会把插画、技能与数值一并整合成一张完成的卡牌。参与制作的是49名学生,共计196张。 《Magic: The Gathering Arena》(Wizards of the Coast,2023年)的游戏画面(取自 Steam 商店页面)
有意思的是满意度的内容构成。外观满意度在5分制中平均为4.25分。而当被问及「最终成果是谁的构思」时,93.5%的人回答「是自己的构思」。明明是交给AI来制作,却依然感觉那是自己的东西。作者将这种现象称为「程序性关联(procedural relatedness)」。
不过也有需要留意之处。做出来的卡牌至今还没有被用于任何一场对战。无论是强度过高还是过低的卡牌,都尚未在实战中得到验证。这一点我会在文章后半部分详细写明。
关于这篇论文
论文标题为 "From LLM-Driven Trading Card Generation to Procedural Relatedness: A Pokémon Case Study"。作者是 Johannes Pfau 与 Panagiotis Vrettis 两人,均任职于荷兰的乌得勒支大学。这是一篇于2026年4月30日发布到 arXiv 的预印本(即在通过同行评审之前公开的稿件)。编号为 arXiv:2604.27972v1,分类为 cs.AI,许可证标注为 CC BY-NC-ND 4.0。
我今天选择这篇论文有两个原因。其一,这个专栏最近介绍的论文,偏向于「让AI解游戏并打分」这一类型。其二,这项研究难得地把「制作者的感受」放在了主角的位置上。在生成式AI的研究中,测量「是否觉得那是自己的东西」、而非单纯测量成品好坏的研究并不多见。
距离投稿仅过去约4个月,可以认为被引用次数几乎还是零,尚未进入被广泛讨论的阶段。正文中也没有找到已通过同行评审的记载。我会带着这一前提往下读。
只有强力卡牌留存下来的问题
集换式卡牌游戏(TCG,即收集卡牌、组建自己的牌组进行对战的游戏)是一个庞大的产业。论文以1993年的《Magic: The Gathering》为起点,写道这一类型如今已达数十亿美元规模。文中还介绍,仅 Magic 一款游戏的玩家就超过5,000万人,销售额超过10亿美元。
其中有一个反复出现的问题:每当新一批卡牌发布,强力组合总会在几个月内固定下来。论文将这种现象描述为元游戏(即某一时期被认为强力的战术的整体格局)变得「局限、停滞、重复」。名义上有成千上万张卡牌,实际被使用的却只有一小撮。
另一个问题是数值膨胀(power creep)。指的是为了让新卡牌显得有吸引力,性能逐渐水涨船高的现象。论文写道,这种现象「几乎会发生在任何持续运营的游戏中」。
而作者最为惋惜的,是玩家对卡牌的感情逐渐消失。人们曾经珍藏着自己喜爱角色的那一张卡。而在一个只按强度筛选的环境里,这种关系无法留存下来。能否找回这一点,正是这项研究的出发点。 《Slay the Spire》(Mega Crit,2019年)的游戏画面(取自 Steam 商店页面)
卡牌的自动生成本身并不新鲜。论文列举了此前的相关研究:让神经网络撰写 Magic 卡牌的 RoboRosewater(2015)、用序列模型补全卡牌描述的 Summerville & Mateas(2016),以及用文法生成炉石传说卡牌并进一步预测其平衡性的 Chen & Guy(2020)。
这篇论文所主张的新意在于增加了两点。其一,不仅生成技能与数值,还同时生成插画。其二,把玩家本人放在生成流程的入口处。作者提出的问题有三个:如何在外观与机制这两个层面上整合生成式AI的进展;以玩家为起点进行生成时,能在多大程度上兼顾对本人构想的忠实度与外观质量;以及应当采用怎样的修正方式,来缩小构想与生成结果之间的落差。
用五道工序组装一张卡牌
整套系统分为五道工序,依次为:收集作为范本的卡牌、检索出相似的卡牌、用文本模型填入数值与技能、用图像模型绘制插画,最后组装成卡牌的版式。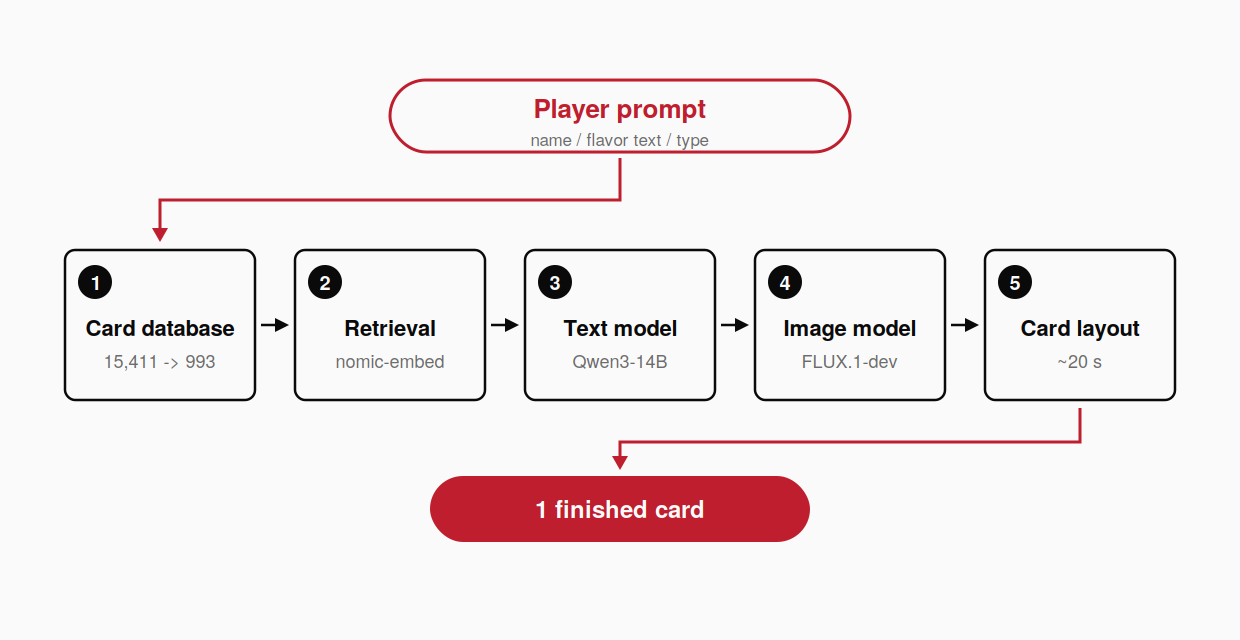 论文所展示的五道工序流程(图解为笔者自制,并非论文图表的转载)
第一步:从官方的 Pokémon TCG Developer Portal API 中导入15,411张卡牌,再从中筛选出993张,只保留到第9世代为止的「未进化」宝可梦。卡牌被处理为结构化数据(JSON,一种字段名与数值成对排列的格式),包含名称、说明文字、属性、HP、技能、弱点等项目。
第二步是检索。系统会寻找与玩家所写内容(名称、说明文字、属性)相近的现有卡牌,使用的是名为 nomic-embed-text-v1.5 的嵌入模型(一种把文本转换成数值序列、从而能够测量语义相近程度的工具)。把相近的范例一并传递过去的这种做法,论文称之为 RAG(Retrieval-Augmented Generation,即先检索范例、再让模型据此撰写的方式)。
第三步由文本模型来填空,使用的是 Qwen3-14B。指令的形式是「请补全我已经开始撰写的 JSON 中的 hp、abilities、attacks、resistances、weaknesses、retreatCost 字段」。这并非让模型从白纸开始创作,而是让它填入既定的栏位。
第四步是绘图。系统在本地的 ComfyUI 中运行名为 FLUX.1-dev-Q8 的图像生成模型。为了统一画风,混合使用了两个 LoRA(一种用少量额外数据使画风向特定方向靠拢的追加训练手法):Niji 风格与「宝可梦(杉森建)风」。第五步则用一个名为 Pokécardmaker 的网页工具组装成一张完整卡牌的版式。每张卡牌耗时约20秒,计算主要在 NVIDIA RTX 5090 上完成。
196张卡牌说明了什么
参与评估的共49人,均为游戏媒体技术与人工智能专业的硕士研究生,男性占75.5%,女性占24.5%。每人制作4张卡牌,合计收集到196张。参与者既可以把整套系统装到自己的电脑上,也可以使用研究方提供的服务器,还可以自由更改模型、参数与指令文本。
评分采用5分制。外观满意度平均为4.25分(标准差0.9)。「成品插画与心中构想的接近程度」为3.95分(1.07)。「技能与数值是否符合构想」为4.04分(0.75)。三项数值都偏向正面一侧。
细分数据更具启发性。就插画而言,35.5%的人「一次就满意」,38.4%的人「经过小幅修改后满意」。就技能与数值而言,「一次就满意」的比例更高,达到51.0%。始终未能满意的比例,插画为11.6%,技能与数值为10.2%。合计来看,插画有88.4%、机制有89.8%最终达到了令人满意的状态。
修改方式的细分也有公布。改写指令文本最多,占51.8%;用相同指令重新生成的占18.8%;改变原本构想的占13.4%;调整细节参数的占6.3%;手动补画的占0.9%。此外,「放弃」的比例为8.9%。
最后,认为成品是「自己的构思」的人占93.5%,认为是「AI的构思」的人占1.4%。14人明确表示成品超出了预期,7人表示比起自己最初设想的样子,更喜欢生成出来的结果。
开放式回答则由两位作者各自独立编码(主题分析)的方式加以整理。由此还得知,有10人把失败归结为模型性能不足,而非系统本身的问题——也就是说,他们认为只是工具尚不成熟,方法本身的思路是合理的。
论文的图表中列出了带名字的具体例子。成功的例子包括 Glister、Ferrafox、Möbiusect 等。失败的例子有 Zagarin(技能说明不足)、Aurellune(强度过高)、Oricrane(描述文字重复)。
创作者可以带走的经验
第一点:与其「让它自由创作」,不如设计成「让它填入既定栏位」。这项研究的系统,直接把现有卡牌的结构当作模板。如果是我自己来做一款组牌游戏,我会想把带有空缺的表格交给AI,而不是一张白纸。生成的自由度越受限制,可用结果的比例应该就越高。
第二点:修正流程应当以「换一种说法」为主,而不是以「重新生成」为主。半数以上(51.8%)的人靠改写指令文本解决了问题。一个只把「重新生成」按钮做得很大的界面,与人们实际的修正方式并不吻合。能够当场改写输入栏,反而更管用。 《Balatro》(LocalThunk / Playstack,2024年)的游戏画面(取自 Steam 商店页面)
第三点:要建立能统计出「放弃的8.9%」的机制。只看做出来的成品,是无法判断生成工具好坏的。记录下玩家在第几次尝试时离开、卡在了哪一道工序,下一步该修正哪里就会浮现出来。
第四点:外观与机制要分开询问。这项研究把插画满意度与技能、数值满意度分开测量,数值也确实不同。很多情况下,只需要修正其中一侧即可。在解谜关卡的自动生成中,我也认为应当把「外观是否满意」与「解开时的手感是否到位」分开来问。
第五点,是规模的问题。这套系统在一台普通电脑上就能运行:文本模型是14B级别,图像模型是量化过的 FLUX,每张卡牌生成约需20秒。不依赖外部API,规模处于个人开发者也能尝试的范围之内。参与者能够在自己的环境中安装并运行,这一事实也印证了这一点。
第六点,是一项提醒。不要把生成出来的卡牌直接投入有胜负之分的场合。原因会写在下一节中。先从单人游玩、收藏、互相展示这类「输了也不会让任何人为难」的场合开始,会更为安全。
尚不清楚的事
作者自己所承认的弱点很明确。最大的一点是,生成出来的卡牌一次都没有被拿去实际游玩过。论文中明确写道,无论是印刷版还是数字版,都未曾投入使用。也就是说,平衡性至今仍未经过验证。
作者也承认了平衡性的重要性。文中有一句大意是:生成的内容必须做到既不压倒性地强于其他卡牌,也不被其他卡牌压倒性地压制。他们提到了自己开发的对战模拟器,但表示这已大大超出本次研究的范围,将其留待日后处理。
作者列举的其他问题还包括:49名参与者全部是游戏/AI相关专业的硕士生,样本存在偏差;研究只处理了宝可梦卡牌,并未在其他TCG上进行尝试;以及版权与知识产权方面的担忧。就模型本身的弱点,作者列举了幻觉(即编造出并不存在的技能之类)、记忆与推理能力的局限、对数字处理能力较弱,以及同样的输入也会得到不同结果的问题。此外,作者也承认卡牌是逐张独立生成的,并未考虑整套卡组的整体语境。
Fukai 在这里想指出的是评分的立场问题。为「是否符合构想」打分的人,正是制作那张卡牌的本人。人们往往容易把自己亲手做的东西评价得更高。第三方会如何评价这同样的196张卡牌,这项研究并未告诉我们。
Fukai 想指出的另一点是,这里缺少可供比较的对象。93.5%这个「自己的构思」的数值已经接近天花板。但由于并不存在,例如「直接拿到AI自行制作的卡牌」这样的对照组,因此没有一把尺子可以用来判断这个数字究竟算不算高。作者所说的「程序性关联」,在我看来,也更像是被主张出来的,而非用衡量依恋本身的量表加以验证过的。
Fukai 的解读
我想把这项研究解读为一个「把生成式AI放在哪个位置」的配置问题。这套系统并没有让AI去构思。构思由玩家来完成,AI则被安排去填写既定的栏位。我认为,正因如此,创作者意识才得以保留下来。用设计批评的语言来说,这与其说是「创造的自动化」,不如说更接近「誊清的自动化」。如果把顺序倒过来,让AI来提出构想,恐怕就不会出现93.5%这个数字了。当然,这终究只是我的解读,并非论文通过对照实验所证实的结论。
结语
为了想要拓宽这一领域视野的读者,我在此列出几项论文所依托的先行研究。RoboRosewater(2015)是让神经网络撰写 Magic 卡牌的早期尝试。Summerville & Mateas(2016)用序列模型补全卡牌描述。Chen & Guy(2020)用文法生成炉石传说卡牌,并进一步涉足了平衡性的预测。以上几项,本文都只是作为论文引用的名称列出,我并未重新阅读其原文。
本站此前也介绍过 AutoBG 这篇论文,它支持桌游设计从构思到完成的全过程,属于「让AI来设计」这一侧的故事。把它与今天这篇论文放在一起读,应该能更清晰地看出——把生成式AI安放在哪个位置,结果会产生怎样的变化。
参考文献
本文所参考的论文与相关资料:
・该论文的 HTML 全文(包含 Approach 的五道工序、Evaluation 的参与者与流程、Results 的数值,以及 Limitations & Future Work)
・Johannes Pfau 的 Google Scholar 主页(第一作者,乌得勒支大学助理教授)
・本文所依托的先行研究:Milewicz / RoboRosewater(2015)的 Magic 卡牌生成、Summerville & Mateas(2016)的序列模型卡牌补全、Chen & Guy(2020)的文法生成炉石传说卡牌及平衡性预测、Summerville et al.(2018)的 PCG 综述,以及 Maleki & Zhao(2024)的 LLM×PCG 综述。以上均只是作为论文引用的名称列出,本文并未重新阅读其原文。
・文中游戏图片的出处:Magic: The Gathering Arena(Wizards of the Coast,2023年)的 Steam 商店页面、Slay the Spire(Mega Crit,2019年)的 Steam 商店页面、Balatro(LocalThunk / Playstack,2024年)的 Steam 商店页面。以上均与论文本身无关,只是作为与主题相符的真实卡牌游戏而引用。
・五道工序的图解为笔者自制,并非论文图表的转载。
Reactions (no login)
Anonymous • one of each per visitor per day
関連シリーズ
Paper Digest第66回 / 全104回