PAPER-DIGEST · 2026-08-19
Battleday et al.: ルールを教えない70本のゲームで、AI の「発見する力」を測る — Fukai が読む
発見のベンチマーク / 隠されたルール / 人間との比較
一段落要約
今日読んだのは、ルールも勝利条件も教えられていない小さな世界に放り込まれたとき、AI は手を動かして規則を見つけ出せるのか、を測るために作られた 70 本のゲーム集の preprint である。名前は DiG-bench(Discovery in Games、ゲームの中の発見)。1本のゲームは短い文字列として表示され、レベルは 1 から 16 まであり、各レベルには手数の上限がある。プレイヤーに渡されるのは操作の一覧と最初の画面だけで、「何が起きる規則なのか」も「どうすれば勝ちなのか」も、遊びながら自分で当てなければならない。
結果は、私が予想していたよりも人間側に寄っていた。70 本すべてが、少なくとも 1 人の人間によって初回の挑戦で解かれている。一方で最も強かったモデルは 50 本、全モデルのどれかが解けた本数を合わせても 57 本にとどまり、最上位2ティア(合計 20 本)では 9 本しか落ちていない。さらに、真のルールを最初から教えてしまうと、同じモデルが 18 本から 69 本に跳ね上がる。つまり詰まっているのは「規則に従って解く力」ではなく、「規則を見つける力」の側だと読める。
パズルを作る側から読むと、この論文は評価指標の話であると同時に、レベルデザインの手引きとしても読める。観測を短い文字列に閉じ込めること、選べる行動をだいたい10通り未満に絞ること、手数を消費しない「砂場」を別に用意すること、難易度を機械の解けなさで階層化しつつ人間側の下限を別に保証すること。どれもそのまま自分の盤面に持ち帰れる設計判断だ。なお本稿は arXiv preprint(arXiv:2608.12593、2026年8月12日投稿)であり、まだ査読を通っていない段階のものである。
はじめに — 誰が、どこに出した論文か
論文の題は「DiG-bench: Discovery in Games」。arXiv の識別番号は 2608.12593、投稿日は 2026年8月12日、一次分類は cs.AI(人工知能)で、cs.LG(機械学習)にも相互掲載されている。著者は Ruairidh M. Battleday を筆頭に、Kai Sandbrink、Tri Dao、Jürgen Schmidhuber、Joshua Tenenbaum、Thomas L. Griffiths、James C.R. Whittington を含む16名(全員の名前は参考文献に挙げた)。認知科学と機械学習の両側から人が集まっている顔ぶれだ。公開サイトは digbench.ai にある。
私がこれを今日選んだのは、扱っている問いがパズル制作の中心とほとんど重なっているからだ。DiG-bench が測ろうとしているのは「ルールが隠された状態から、手を動かして規則を当てる力」である。これは、良いパズルゲームがプレイヤーにさせていることの、ほぼそのままの言い換えだ。『Baba Is You』にも『Chants of Sennaar』にも説明書はない。プレイヤーは触って、失敗して、そこから規則を組み立てる。その過程を 70 本ぶん揃えて数値にした資料が出てきた、というのが今日の話である。
先に断っておくと、これは arXiv に置かれた preprint であり、査読を通った論文ではない(preprint とは、学会や雑誌の審査を経る前に著者自身が公開する原稿のこと)。投稿からまだ日が浅く、被引用も積み上がっていない段階なので、数値の扱いは慎重にいきたい。以下で挙げる数字はすべて、論文本文と図表に書かれている通りに引く。
背景 — 既存のベンチマークが測れていなかったもの
AI の能力を測るテストは山ほどある。それでも著者らは、いま並んでいるテストの中に「目的が分からない環境で、実験しながら新しい知識を見つける力」を正面から測るものがほとんどない、と書いている。ここで著者らが使う「発見(discovery)」の定義は明快だ。曰く、これまで説明されていなかった規則性を見つけ、それを既に見た観測を短くまとめ直せる形に、そして系の新しい状態について考えられる形に、意味づけすること。要は「まとめて、次を予想できるようになること」である。
既存のテストがどう足りないのか、著者らは名前を挙げて整理している。ARC-AGI-3 は発見と流動的な推論のテストとして枠づけられているが、視覚の知覚能力と混ざってしまう。ARC-AGI-1/2、Bongard-LOGO、IOLBench はルールの帰納(いくつかの例から規則を当てること)を測るが、自分で手を動かして実験する部分がない。DiscoveryWorld は実験を測るものの、科学の予備知識と絡み合うか、「発見の選択肢一覧」に頼ってしまう。知覚や前提知識に汚されずに「発見そのもの」だけを切り出したテストがなかった、という主張だ。
そこで著者らはゲームを使う。ゲームは AI 研究の伝統的な舞台だが、DiG-bench の使い方は少し違う。ここでの1本1本のゲームは、独自の法則を持つ小さな世界であり、しかもその法則と目的の両方がプレイヤーから隠されている。パズル作家の言葉に翻訳すれば、「チュートリアルもゴール表示も外した盤面を、それでも解けるように設計する」という課題設定だ。しかも 70 本すべてが人間の専門家の手で新しく作られており、インターネット上のどこにも存在しない。学習データに答えが混ざっている(いわゆる汚染)心配を、作り下ろしと非公開によって断ち切っている。
アプローチ — 70本のゲームはどう作られているか
作りは驚くほど素朴だ。ゲームは 70 本。それを機械にとっての難しさに応じて 7 つのティア(段階)に振り分け、ティア1が最も易しく、ティア7が最も難しい。各ティアから 3 本ずつ、合計 21 本が P-1 から P-21 という名前で公開され、残りの 49 本は評価の健全性のために非公開に保たれている。公開分には API と SDK が用意されており、誰でも自分のモデルを走らせられる。
1本のゲームの観測(画面)は短い Unicode 文字列である。ほとんどのゲームは英字・数字・簡単な記号だけで表示される。ゲームには 1 から 16 のレベルがあり、レベルを進むごとにプレイヤーはゲームの構造をより深く当てさせられる。各レベルには手数の上限がある。そして選べる行動は多くない — 論文は、ほとんどのゲームで可能な行動が全部で 10 通り未満だと書いている。これは設計として重要な点だと私は思う。行動が少ないほど、詰まる理由が「操作を思いつけない」ではなく「規則が分からない」に絞られる。
私が最も面白いと思った仕掛けは「creative mode(創作モード)」だ。これは本編とほぼ同じ規則を持つ砂場で、ここで消費した手数はレベルの上限に数えられない。プレイヤーは「/」という行動でこの砂場に入れる。ただし砂場の初期状態は本編と違うように作られている — つまり、砂場で見つけた解き手をそのまま本編に写すことはできない。実験は自由に、しかし答えの丸写しは不可能に。この二つを両立させるための、たった一つの設計上の工夫である。
評価の作りも書いておく。標準的な仕掛け(論文の言う basic harness)では、最初にモデルへ課題の説明と初期状態が渡され、以降は1ターンに1つの合法な行動を返させる。とても長いゲームでは履歴が文脈の窓に収まらなくなるので古い手から切り落とし、これが起きたのは全実行の 6.1% だという。推論の労力を設定できるモデルではそれを「高」にしている。別条件として、Claude Code・Codex・Kimi Code・Prime Agent・PRO-LONG といったエージェント型の仕掛け(モデルが自分で道具を呼び、文脈を自分で管理する枠組み)でも走らせ、対照として、真のルールを教えてから解かせる条件も置いている。人間側はエージェントと同じ情報に加えて「時間をかけてよい」と伝えられ、紙とペンで考えを書き出すことを勧められた。
発見 — 数字はどこに置かれたか
まず全体像。最も弱かったモデル(Qwen 3.6 27B)は 70 本のうち 1 本しか解けていない。最も強かった Opus 5 は 50 本。そして「どのモデルかが解けた本数」を全部合わせても 57 本である。標準の仕掛けで試されたのは Claude Opus 5・Gemini 3.1 Pro・GPT-5.5・Kimi K3・GLM-5.2・DeepSeek V4 Pro Preview・DeepSeek V4 Flash 0731・Qwen 3.6 27B。最も低いティアは一世代前の Gemini 3.1 Pro でもだいたい落ちるが、上位ティアは最新のモデルにとっても難しく、最上位2ティアの合計 20 本のうちモデル側が取れたのは 9 本だった。
対して人間は 70 本すべてを、少なくとも 1 人が初回挑戦で解いている。ただし著者らは人間が楽勝だったとは書いていない — 多くのゲームは人間にとってもかなり骨が折れる、発見にはしばしば労力がかかる、と明記している。手数の比較も出ている。人間と Gemini 3.1 Pro の双方が突破したレベルに限ると、Gemini は 1 レベルあたり 46 ± 63 手、人間は 49 ± 78 手で、統計的な差は出ていない(Wilcoxon 検定で p=0.15。論文の Figure 5A)。解けたレベルについては、かかる手数がほぼ同じということだ。差は速さではなく、そもそも解けるかどうかに出ている。
この論文でいちばん雄弁な数字は、ルールを教える対照条件だと思う。Gemini 3.1 Pro は、ルールを与えられない状態では70 本のうち 18 本しか解けない。ところが真のルールを渡すと 69 本を解く(Figure 5B)。同じモデル、同じゲーム、同じ手数上限で、足した情報が「規則の説明」だけでこれだけ動く。しかもルールを渡すと、そのモデルは creative mode をほとんど使わなくなる(Figure 5C)。実験は、規則を知らないから必要だったのだという筋が数字で見える。もう一つ意外だったのは、エージェント型の仕掛けが効かなかったことだ。Fable 5(Claude Code)、GPT-5.6 Sol(Codex)、Opus 5(Prime Agent)などのいずれも、標準の仕掛けの Opus 5 を上回らなかった。
公開分と非公開分でおかしなずれが出ていないかも確認されている。Gemini の勝率は公開ゲームと非公開ゲームでおおむね同じで、人間の手数効率も同様に近い(Figure 5D)。公開されている 21 本で測った印象が、隠された 49 本にもだいたい当てはまるということだ。実行条件については、多くの実行が 200 ドルの費用上限のもとで走り、Kimi K3 は 12 時間の実時間上限、文脈の大きさは 262k から 1M トークンまで。上限に当たって打ち切られた実行は条件ごとに 0 から 6 本(Table 3)。
使いどころ — パズルを作る人が持ち帰れるもの
一つ目、練習用の砂場を「答えの写せない砂場」にする。creative mode の設計がそのまま参考になる。仮に自分がデイリーの記号パズルを運営していて、初見の人が本番の手数を無駄にせずに操作を試せる場所を用意したいとする。素直に作ると、練習盤で見つけた並びをそのまま本番に写せてしまう。DiG-bench の答えは「砂場の初期状態を本番と変える」だ。実験の自由は残しつつ、写経は封じる。この一手だけで練習モードは学習装置になる。
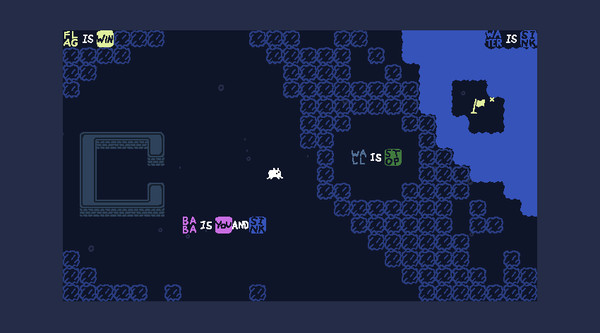 『Baba Is You』(Steam公式スクリーンショットより)
二つ目、難易度を「機械の解けなさ」で階層化し、人間側の下限は別に保証する。DiG-bench は 7 ティアを機械にとっての難しさで割り振り、そのうえで 70 本すべてを少なくとも 1 人の人間が初回で解いたことを別途確認している。この二重構造は真似する価値がある。自作パズルなら、自分のソルバや汎用モデルに解かせて「機械が落とせない盤面」を上のティアに置き、同時に「人間のテスターが 1 人でも初見で解けたか」を出荷条件にする。前者だけだと理不尽な盤面が上位に紛れ込み、後者だけだと階層がぼやける。
三つ目、ヒントの値付けをこの論文の数字で考える。ルールを渡すだけで 18 本から 69 本に跳ねたということは、パズルにおいて「規則の説明」はほぼ答えに等しい情報だという意味になる。段階ヒントを作るとき、私たちはつい「ルールを一言だけ教える」を軽いヒントだと思いがちだが、この枠組みで言えばそれは最上級のヒントだ。規則そのものを渡すのは最後の段に置き、その前に「どこを見るか」「どの操作をもう一度試すか」といった注意の誘導を挟むほうが、発見の体験を壊さない。
四つ目、観測を短い文字列に閉じ込め、選べる行動を絞る。DiG-bench が視覚の知覚を意図的に外したのは AI 評価の都合だが、パズル制作にも効く。盤面を文字と記号だけで表現できるなら、モバイルの小さな画面でも崩れず、スクリーンリーダーにも乗り、共有画像も軽い。そして何より「見づらいから解けない」と「分からないから解けない」が混ざらない。行動を10通り未満に抑えるのも同じ方向の判断で、操作が少ないほどプレイヤーは「次に何を押すか」ではなく「この盤面で何が起きているのか」に注意を向ける。行動を削るのは表現力を削ることではなく、詰まりの原因を一本化することだと読める。
限界 — 著者が認めている点と、私が読んで気づいた点
まず著者らが本文で認めている弱点。最大のものは試行回数だ。ほとんどのモデル×ゲームの組は 1 回しか走らせていないため、結果は実質的に単一の試行であり、種違いによるばらつきは報告されていないと明記されている。50 対 57 のような差が偶然の範囲なのかは、この資料からは分からない。加えて、とても長いゲームでは履歴が切り落とされており、それが起きたのは全実行の 6.1%。費用と時間の上限に当たって打ち切られた実行も条件ごとに 0 から 6 本ある。上限の額が条件ごとに 100〜200 ドルとばらついている点も、モデル間の直接比較を少し曖昧にする。
ここから先は Fukai がここで指摘する点である。第一に、人間側の 70 対 70 という数字と、モデル側の 50 という数字は、そのまま並べられる量ではない。人間の 70 は「各ゲームを、誰か 1 人が初回で解いた」の集計であり、モデルの 50 は「1 つのモデルが解いた本数」だ。同じ土俵で比べるなら、モデル側も全モデルを合わせた 57 と並べるのが筋で、その 57 対 70 が本当の距離に近い。論文の結論部はこの二つを慎重に書き分けているが、数字だけを引き写すと人間優位が実際より大きく見える。
第二に、人間のプレイヤーの人数や属性が本文に出ていない。集められた経路は書かれている — 人脈、研究者への直接依頼、教授経由の学生推薦、そしてパズル愛好家のコミュニティ。そして著者ら自身が「プレイヤーはパズルを解くこと自体に動機づけられている傾向があった」と書いている。つまりこの人間の基準線は一般の人ではなく、パズルが好きで、時間をかけてよいと言われ、紙とペンを勧められた人たちのものだ。パズル制作の参考にする分にはむしろ都合の良い集団だが、「人間一般 対 AI」という読み方には向かない。データは匿名の集計としてのみ提示されている。
第三に、この preprint には独立した「限界」の節が置かれておらず、弱点への言及は考察の中に散っている。査読前の原稿ではよくあることだが、著者がどこまでを自分の弱点として認識しているのかを一箇所で確認できない点は、読む側には少し不便だ。第四に、70 本のうち 49 本は非公開である。汚染を防ぐには正しい判断だが、外部の第三者が難易度ティアの妥当性やゲームの公平性を検証できないという代償を伴う。避けられない取引だが、取引であることは書き留めておきたい。第五に、評価に使われたモデルは名前も版も動きが速い。半年後にこの表を読み返したとき、どの数字が「モデルの限界」でどの数字が「その時点の版の限界」だったのかを切り分けるのは難しくなるだろう。
Fukai の読み
ここは私の解釈である。私はこの研究を、「ルールが隠されていること」をこれまで作家の勘に任せてきた領域から、測れる資源の側へ動かす流れの中に位置づけたい。パズルの設計批評の語彙で言えば、DiG-bench がやったのは難易度の自動化ではなく、不明性の目盛り付けに近い。同じ盤面でも、規則を伏せるか明かすかで解けるかどうかが 18 対 69 まで動くのなら、「何を伏せるか」は難易度の一部ではなく難易度の主成分だと読める。私たちが盤面の複雑さや手数で難しさを語ってきたのは、伏せた情報の量を測る道具がなかったからではないか。この 70 本は、その道具の最初の版として置かれたものだと私は受け取っている。
おわりに
もっと深く知りたい人には、まず論文が名前を挙げている先行のベンチマーク群 — ARC-AGI 系、Bongard-LOGO、IOLBench、DiscoveryWorld — をざっと眺めることを勧める。DiG-bench が何を引き算して作られたのかが分かると、この 70 本の輪郭がはっきりする。当サイトの記事で言えば、AI がルールを当てる話としては Ahn らの CogARC を読んだ回、洞察と探索の関係については Chao らの回、鉛筆パズルを機械に解かせる評価の話としては Waugh らの回が地図の役に立つ。
私自身の宿題としては、公開されている 21 本を実際に自分の手で遊んでみたい。ティア1から順に触って、どのあたりで自分の勘が止まるのかを確かめる。紙とペンを勧められているのだから、それに従うつもりだ。
参考文献
本記事で参照した論文と関連資料:
・同論文の HTML 全文(Table 1〜3、Figure 1・4・5 を含む)
・DiG-bench 公式サイト(公開 21 本のプレイ、リーダーボード、API/SDK)
・discos-research/dig-bench(公開実装のリポジトリ)
・論文が比較対象として挙げている先行ベンチマーク: ARC-AGI-3 / ARC-AGI-1・2 / Bongard-LOGO / IOLBench / DiscoveryWorld
・当サイト関連記事: Ahn らの CogARC を読む回 / Chao らの洞察と探索の回 / Waugh らの鉛筆パズル評価の回
・査読状況: 本稿は arXiv preprint(2026年8月12日投稿、cs.AI 一次分類 / cs.LG 相互掲載)であり、DOI は付与されていない。投稿直後のため被引用はまだ積み上がっておらず、広く議論された段階には至っていない
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第63回 / 全101回
次に読む
関連レビュー
Rusty Lake: Roots
一族の人生を生まれてから死ぬまで順にたどり、家系図を育てていく、手描きの怪奇ポイント&クリック・パズル。Cube Escape シリーズの Rusty Lake が2016年に出した、世代をまたぐ不穏な一作。
Rusty Lake Hotel
ホテルの客に五回の晩餐を出すため、六つの部屋で材料と仕掛けを集めて組み立てる、手描きの怪奇ポイント&クリック・パズル。Cube Escape シリーズの Rusty Lake が2016年に出した、短くて不穏な一作。
Bilkins' Folly
相棒の犬とともに、島々を歩いて宝の地図と景色を照らし合わせ、謎を解いて宝を掘り当てるドット絵のパズルアドベンチャー。Webbysoft 開発、Armor Games Studios 発行。