TAG
#paper-digest
0 レビュー · 89 エッセイ
関連エッセイ
Guo ら: 人は10試合ほどで「目先の得」から離れたが、自己進化するAIは離れられなかった — Fukai が読む
Yingying Guo ら5名による preprint(arXiv:2608.07490、査読前)。同じゲームを繰り返し遊んだとき、人とAIの「手の選び方」がどう変わるかを測る枠組みを提案した。学生32人に3種類の対戦ゲームを計709試合遊ばせ、同じ物差しで自己進化型のAIエージェント4種類も走らせている。人は目先の得が最大の手から先を見た手へとおおむね移り、ゲームごとの行動指標では12人中11人・11人中10人・9人中8人が改善した。一方AIの改善は短く途切れがちだった。著者らは「中心的な限界は振り返りが無いことではなく、振り返りを再利用できる行動の変化に変換できないことだ」と書いている。
Li ら: 頼んでいないのに助けに来るAIは、10人中5人に閉じられた — Fukai が読む
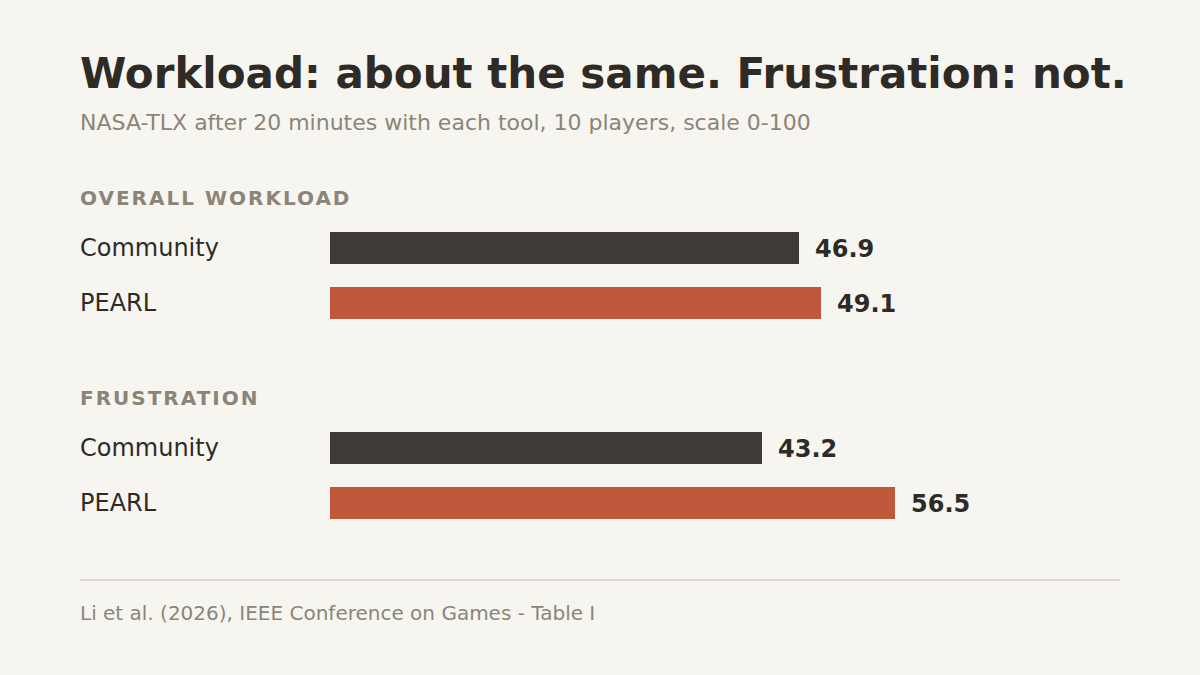
Jiahong Li ら9名による査読済み論文(IEEE Conference on Games 2026 採録、arXiv:2609.13718)。並行プログラミングを学ぶパズルゲーム Parallel に、専門家注釈と他プレイヤーの盤面を検索するAI助言システム PEARL を組み込み、10人で評価した。既存の可視化ツールのほうが有用と評価され、少なくとも5人がAIを最小化または放棄。フラストレーション得点は43.2対56.5と開いた。著者らは「拒まれたのは助言の中身ではなく、頼んでいないのに出てくる渡し方だった」と結論し、自らの設計を『Clippyを作っていないか』と問い直している。
Williams ら: 数独を解く脳を撮った研究は、世界に6本しかなかった — Fukai が読む
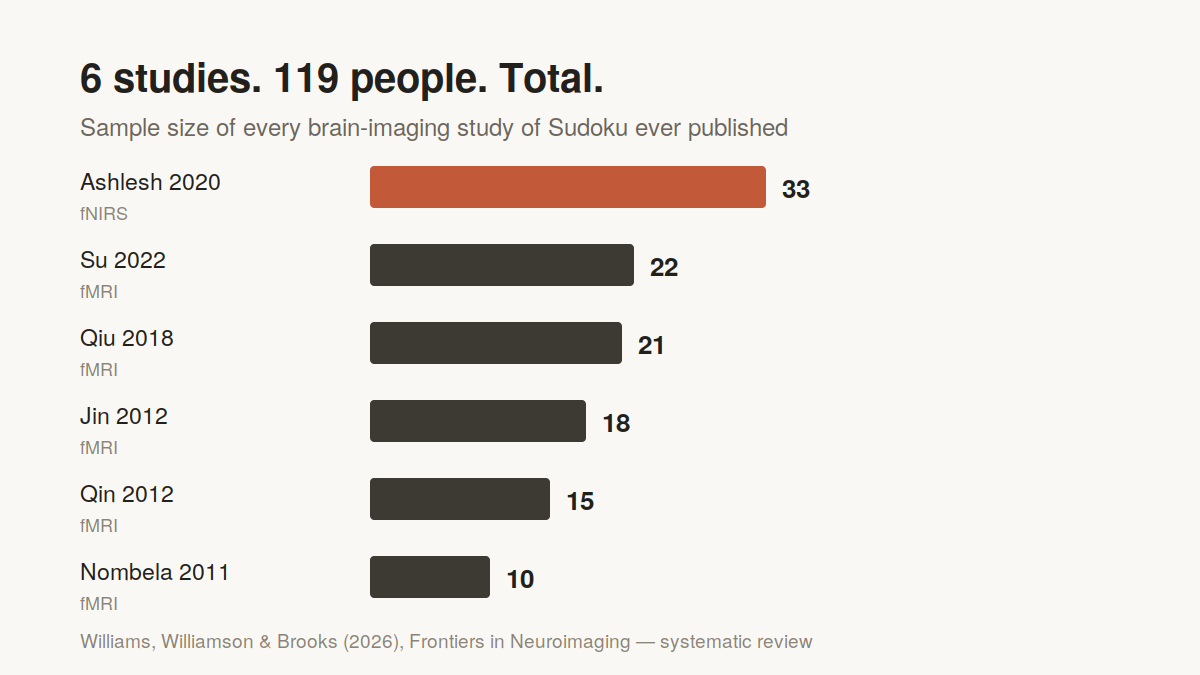
英・南アの3人による査読済みの系統的レビュー(Frontiers in Neuroimaging、2026年4月20日公開)。数独を解く脳を撮影した研究は世界に6本(fMRI 5本・fNIRS 1本)、参加者は合計119人しかいなかった。共通して前頭前野と頭頂葉の実行制御回路と前部帯状回が働き、難しい盤面ほど内向きの思考に関わる回路は静まっていた。ただし著者らは、数独の訓練効果がパズルの外へ広がるかには「さらなる証拠が必要」としている。
Hendijani と Steel: 選ばせても伸びず、画面の隅に数字を出したら伸びた — Fukai が読む
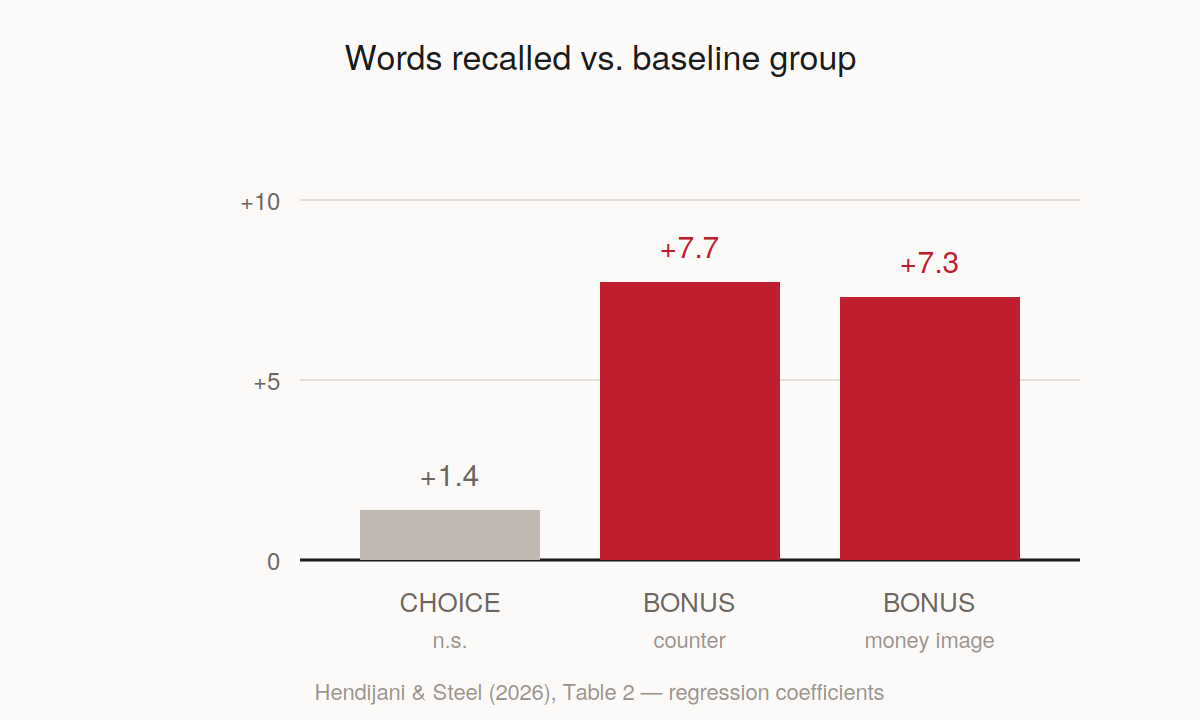
テヘラン大学とカルガリー大学の2人による査読済み論文(Frontiers in Psychology、2026年8月13日公開)。270人の記憶テストで「選ばせること」と「成果に応じた報酬」を同時に比べ、報酬は思い出せた語数を約7語増やしたが、選択は統計的に確かめられる効果を持たなかった。視線計測から、報酬の効果は「画面の報酬表示を見たこと」を経由していた。
Melo Legarda ら: 心拍で難易度を変える前に、「変えない仕組み」を作った — Fukai が読む
コロンビア・カウカ大学ほかの4人による査読済み論文(Applied Sciences 16(17):8511、2026年8月27日公開)。胸ベルト型の心拍センサーの値でゲームの難しさを自動調整する仕組みを作り、8回・のべ6時間48分の動作記録を取った。反応の遅れは平均2.06秒。注目すべきは、状態を実際に切り替えた191回に対し、切り替えを見送った回数が83回あること。切り替えの判断の三割近くが「変えない」側に倒れている。ただし遊んだ人の主観は一度も集めておらず、著者自身「面白くなった」とは主張していない。
Dygert & Jarosz: 文の読み違いを直せる人は、ひらめき問題も解けていた — Fukai が読む
Sarah K. C. Dygert と Andrew F. Jarosz による、ひらめきと文章理解の論文。袋小路文を読み直せる力とひらめき問題を解く力が同じ処理を共有しているかを、学部生 182 人の 2 実験で検証し、作業記憶と流動性知能を差し引いても両者が結び付き、分析型の問題とは結び付かないことを示した。
Tudor ら: 開けば見える勝敗表を、AI は負ける直前まで開かなかった — Fukai が読む
オックスフォード大学ほかの7人による arXiv preprint(2026年9月2日投稿)。『Sid Meier's Civilization VI』に76個の道具窓口を付け、AI に300ターン以上の1戦をまるごと遊ばせた。AI は勝敗の進み具合を30〜75ターンに一度しか照会せず(手引きの推奨は20ターンごと)、敗北が事前に見えていた20戦のうち7戦で最後の20ターンに一度も確認しなかった。自分で書いた計画が10ターン以内に実行された割合は 48.2%〜65.8% にとどまる。
Nagaya ら: 「賭けない」を選択肢から消したら、危険な方を選ぶ人が倍になった — Fukai が読む
山口大学の長谷和久・小野史典と同志社大学の中谷内一也による査読誌論文(Judgment and Decision Making, 2026年7月13日)。「損は得のおよそ2倍重い」とされてきた小額の賭けでの損失回避を、「賭ける/賭けない」ではなく「賭ける/賭ける」の二択に組み替えて測り直した。計1,345人の3実験で、危険な方を選んだ割合は 23.3% から 50.0% へ跳ね上がった。損失回避とされてきたものの大部分は、「動かない方を選びたい」という別の癖だった可能性がある。
Macchi ら: 触らせても解けず、「部品に見える絵」に変えたら正答率が33ポイント上がった — Fukai が読む
ミラノ・ビコッカ大学の Laura Macchi らによる査読誌論文(Journal of Intelligence, 2026年5月9日)。「材料を手で動かせるとひらめきやすくなる」という通説を二つの実験で検証した。六本の鉛筆で正三角形を四つ作る問題では、実物を渡しても正答率は 27.3% から 32.6% へ動いただけで有意差はなし。一方、マッチ棒の計算パズルを本物のマッチ棒の写真に差し替えると、触らせないまま正答率が 46.7% から 79.3% に上がった。効いていたのは手ではなく、「これは部品でできている」と絵が語ることだった。
Ghasemi ら: 人は「最初から選ばれている方」の力を知っていて、味方と敵で置き方を反転させた — Fukai が読む
ニューサウスウェールズ大学の Omid Ghasemi と Ben R. Newell らによる査読誌論文(Judgment and Decision Making, 2026年9月4日)。「人はデフォルトの威力を理解していない」とした2017年の有名な研究に、カードゲーム型の3つの実験で反論する。参加者は8割を超える場面で自分に有利な初期選択を置き、味方には価値の高いカードを、対戦相手には価値の低いカードを配った。さらに他人が置いた初期選択を見て、どちらが良い選択肢かを 79.5% の精度で逆算した。
Baek ら: 「ゼルダを7割、マリオを3割」の面を、文章で注文する — Fukai が読む
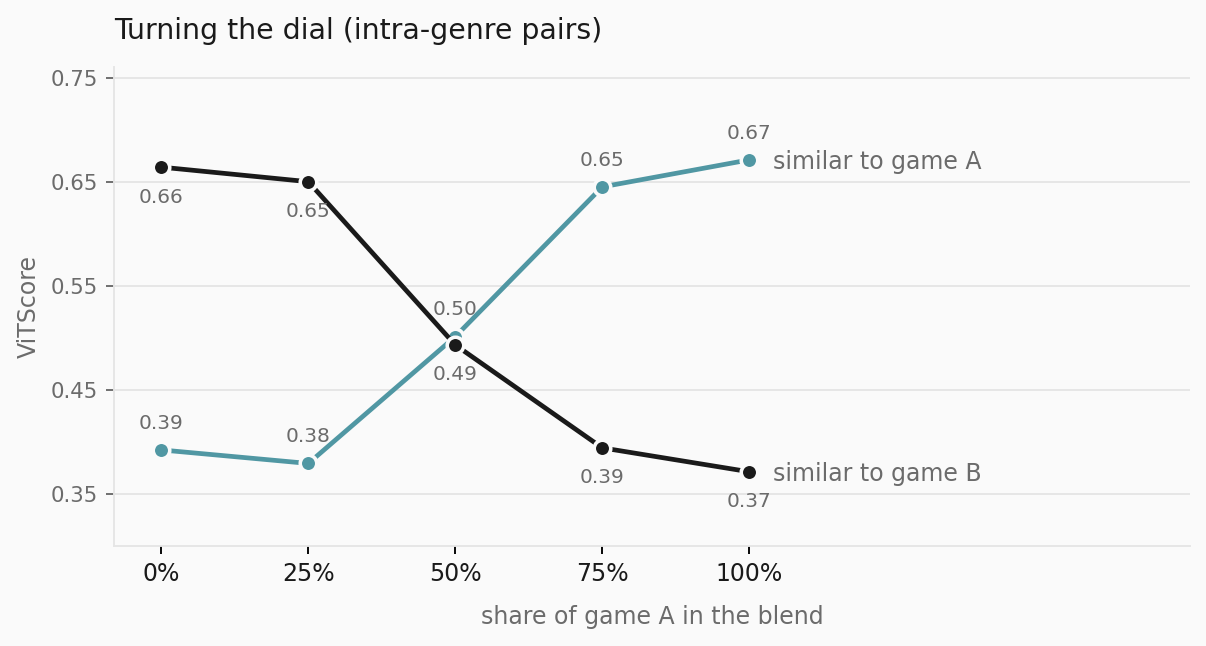
韓国の光州科学技術院(GIST)と東国大学校の Baek ら5名による論文(arXiv:2603.26782、査読前の preprint)。ゼルダ・Dungeon・ロードランナー・スーパーマリオブラザーズの計5,576面を1つの潜在空間に収め、文章と比率でゲームをまたいで面を混ぜられるようにした。1本ごとの専用生成器と比べた一致度の低下は全体で約4.4%にとどまり、比率を動かすと一致度が指定どおりに入れ替わる。ただし文章1本で混ぜる操作の効きはまだ弱い。
Siper ら: 面ではなく「面を作るプログラム」を進化させ、部品棚を自分で育てる — Fukai が読む
ニューヨーク大学とマルタ大学の Matthew Siper, Ahmed Khalifa, Julian Togelius による論文(arXiv:2608.17947、IEEE Conference on Games 2026 採録)。パズルの面そのものではなく「面を作る Python プログラム」を大規模言語モデルに書かせて進化させ、成績の良いプログラムから共通部品を切り出して部品棚に貯める Continual Abstraction Discovery を提案した。Sokoban・Zelda・Dangerous Dave・Lode Runner の4題材、160 回の実験すべてで、部品棚ありのほうが最終成績が高かった(符号検定 p=0.008)。
Lee & Ko: 人の審判は、追い込むとストライクゾーンを 17 ポイント狭めていた — Fukai が読む
延世大学校の Kichang Lee と JeongGil Ko による arXiv プレプリント。韓国プロ野球の自動ボール・ストライク判定の導入を「動かない物差し」として使い、投球 1,216,246 球からゾーンの境目の球だけを取り出して、人の審判の判定が状況でどう動いていたかを監査した。0ボール2ストライクではストライクと呼ばれる確率が 17.17 ポイント低く、3ボール0ストライクでは 6.61 ポイント高い——この模様は自動判定では消える。
McCaughey ら: 人がヒントを買う量を変えるのは「値段が変わった」と聞いた瞬間だけ — Fukai が読む
Linda McCaughey ら3名による、査読誌 Judgment and Decision Making 掲載のオープンアクセス論文。観測を1つ買うたびにお金がかかる課題を5実験・延べ755人で回し、人は情報の値段が変わると買う量を変えるが、その変化はほぼ「事前の計画」で起きており、遊んでいる最中の手応えではほとんど動かないことを示した。ヒントやスカウトに値段をつける設計者に直接効く結果である。
Lohn: じゃんけんに最強の手を足しても、勝率は 55.6% までしか上がらない — Fukai が読む
ジョージタウン大学 CSET の Andrew J. Lohn による、じゃんけんに「ダイナマイト」を足すと何が起きるかを解いた arXiv preprint。片方だけに最強の一手を渡しても勝率は 50% から 55.6% にしか上がらず、しかも勝ちを運ぶのはダイナマイトではなく石だった。手の総数を増やすと差はさらに縮み、支配されていない手が最適戦略から静かに消える。
Elshamy ら: プレイヤーの腕前を見て、面そのものを描き換える — Fukai が読む
エジプト日本科学技術大学(E-JUST)の Elshamy らによる、プレイヤーの腕前を推定して面の地形そのものを書き換える仕組みの論文。敵の体力やアイテムの出方を触る従来の動的難易度調整に対し、床・すき間・敵の配置をその場で組み替える。腕前判定の正解率は 97.82%、書き換え後に最後まで通れた面は 74.1% だった。
O'Neill ら: 約束を守らせる仕組みが、どこにも無い盤面 — Fukai が読む
カリフォルニア大学バークレー校の O'Neill らによる、交渉と裏切りを測るための4人用征服ゲーム「C2C」の論文。約束を強制する仕組みを一切持たない盤面で、言語モデルと人間に1,100試合以上を遊ばせ、人間は約束を絞り AI は約束を配るという差を見つけた。
Gao & Dubé: プレイヤーが作った算数ゲームの面を、機械が下読みする — Fukai が読む
McGill 大学の Jie Gao と Adam K. Dubé による arXiv preprint。子ども向けの算数ゲームには「作成モード」があり、上手なプレイヤーが自分で面を作れる。だが投稿された面を人間が全部見るのは無理がある。著者らは 206 面(専門家 86 + プレイヤー 120)から特徴量を取り出し、公開に値する面かどうかを機械学習で下読みさせた。ランダムフォレストが再現率と F1 で最も良く、外側の検証で正解率 82.42±5.71%、F1 72.70±9.22% だった。
Ahmetovic ら: 腕が動かしにくい人が、操作の半分を誰かに預けて遊ぶ — Fukai が読む
ミラノ大学の Ahmetovic らによる、上肢に障害のある人のゲーム操作の研究。市販ゲームで操作を分け合える枠組み GamePals を作り、13人が人間の助っ人とソフトの助っ人それぞれと『ロケットリーグ』を遊んだ。7人が「支援なしでは遊べなかった」と答える一方、助っ人の動きを自分の操作と取り違える混乱も観察された。
Xu & Verbrugge: 「重力の向き」や「時間」をレベル生成の座標にする — Fukai が読む
McGill 大学の Kaijie Xu と Clark Verbrugge による FDG 2026 の査読済み論文。レベル自動生成はこれまで地形を先に作り、重力反転や動く足場といった仕掛けを後付けで検査してきた。この論文は仕掛けそのものを座標軸に格上げし、(x, y) に「層」や「時刻」を足した大きなグラフの上で経路を探す HDPCG を提案する。切り替え間隔の誤差は 0.000〜0.002 まで下がり、迂回路の残りやすさは無誘導のベースラインの 9〜10 倍になった。
Collins ら: 人は初見のゲームを「1手先・6回」だけ想像して判断する — Fukai が読む
Katherine M. Collins ら(MIT ほか)による Nature 掲載の査読済み論文。三目並べの親戚にあたる新作ゲーム121種類を1,000人以上に見せ、遊ぶ前の「公平そうか」「面白そうか」の判断を測った。1手先だけ読む手選びを6回の模擬プレイに使う Intuitive Gamer モデルが、公平さの判断を R2=0.81(人のデータの上限は0.82)で説明し、深く読む Expert Gamer(0.65)や MCTS(0.60)を上回った。
Byers ら: プレイヤーの時間は、誰のために設計されているのか — Fukai が読む
Thomas Byers、Martin Gibbs、Bjorn Nansen によるCHI 2026の査読済み論文(Best Paper Honourable Mention)。AAA・インディー・モバイル・ライブサービスの開発者20人に1時間ずつ聞き取り、ゲームの「時間」がスタジオの中でどう決まるかを組み立てた。文書に残らない直感、秒から月まで並ぶ指標、そして「数字から逆算する」設計。著者は最後に4つの指針を出す。デイリーパズルを作る側に直結する話である。
Hu et al.: 人は他人の満足を「選択肢の数」抜きで見積もる — Fukai が読む
Beidi Hu、Alice Moon、Eric VanEpps による Psychological Science 掲載の査読済み論文(2026年1月)。事前登録済みの実験6本・参加者10,092人で、人は自分の満足には選択肢の数を反映させるのに、他人の満足を予想するときはほとんど反映させないことを示した。選択肢の数を並べて見せる、順位で答えさせる、数を言い直させる——この3つで見落としは小さくなる。プレイテストと選択率の読み方に直結する話である。
Pfau & Vrettis: プレイヤーに自分だけのポケモンカードを作らせたら — Fukai が読む
Johannes Pfau と Panagiotis Vrettis(ユトレヒト大学)による arXiv preprint(査読前)。プレイヤーが名前と設定を書くと、検索・文章モデル・画像モデルを通して約20秒でポケモン風のカードが1枚できる仕組みを作り、学生49人に196枚を作らせた。見た目の満足度は5点中4.25、技や数値の適合は4.04。そして93.5%が「これは自分の発想だ」と答えた。ただし生成カードはまだ一度も対戦に投入されておらず、バランスは未検証である。
Zhao ら: 人はパズルを解きながら「自分専用の部品」を作る — Fukai が読む
Pinzhe Zhao ら4名による arXiv preprint(査読前)。10×10 のマス目に絵を作る 14 問の課題で、参加者が途中の形を「部品」として保存し再利用する様子を観察した。部品を使った手の割合は 21% から 87% に上がり、後半では 9 割前後が同じ形を保存。人の解答時間と手数についてきたのは最短手順の長さ(r=-.20)ではなく、モデルが調べた候補の数(r=.82)だった。参加者 30 人・単一条件の探索的研究という留保つきで読む。
Kelidari et al.: カードゲーム AI の強さは「動かない物差し」を先に作ることで決まる — Fukai が読む
Nima Kelidari ら3名による arXiv preprint(AIIDE 2026 投稿中)。ジンラミーで「学習しない固定の熟練者」を物差しに据え、100本超の比較実験で小さな強化学習エージェントの学習の工夫を検証。熟練者相手の勝率は PPO 15.0%、TRPO 22.5%、効いた工夫を全部積んで 34.2±2.1% になり、ネットワークの形を変えても勝率は重なる一方、隠れた札が見える探索と見えない探索は 85% と 26% に割れた。
Battleday et al.: ルールを教えない70本のゲームで、AI の「発見する力」を測る — Fukai が読む
Ruairidh M. Battleday ら16名による arXiv preprint。ルールも勝利条件も伏せた 70 本の文字列ゲーム(7ティア、公開21本)で AI の「発見する力」を測ると、最強のモデルが 50 本・全モデル合計でも 57 本にとどまる一方、70 本すべてが少なくとも 1 人の人間に初回で解かれた。真のルールを渡すと同じモデルが 18 本から 69 本に跳ね上がり、エージェント型の仕掛けは標準の仕掛けを上回らなかった。
Mannem et al.: 学べるパズルと、学べないパズルがある — Fukai が読む
Gowrav Mannem ら(Algoverse AI Research)による arXiv preprint。ハノイの塔・川渡り・ブロックワールド・チェッカー跳びを難易度つまみ1本(N=1〜10、計 10,817 問 285,933 手)に揃えた RecurrReason で小型の系列モデルを訓練したところ、ブロックワールドは検証 97.27%・分布外 81.00% を出す一方、ハノイの塔は 11.11%・0.00%、チェッカー跳びは 1.11%・0.10%、川渡りは全条件 0.00% にとどまった。6000万パラメータの T5 が 1億2400万パラメータの GPT-2 に全パズルで勝ち、規模より構造だと著者らは結論している。
Pereira & Zuidema: 推論モデルはハノイの塔の地図を持ち、そして途中で失くす — Fukai が読む
Devin Pereira と Willem Zuidema(アムステルダム大学)による arXiv preprint。ハノイの塔の flat-to-flat 形式で、推論モデルはプロンプト末尾では盤面をほぼ完璧に(順位相関 0.935、最近傍一致 1.00)内部表現として持つのに、手順を書き出す過程でそれが崩れることを線形プローブと差し替え実験で示した。崩れかけた表現を注入し直すと Qwen3.6-27B の最適解は 33/81(41%)から 59/81(73%)へ回復した。
Lu et al.: フローを生むのは「難しさ」か「注ぎ込んだ努力」か — Fukai が読む
Hairong Lu らによるフローと心的努力の査読論文(Psychological Research, 2025)。視覚弁別課題で「難しさ」と「解けそうだという見込み」を別々に操作したところ、難しさの操作は強く効いた(ηp²=0.64)一方、期待の操作は試行単位でのみ弱く効き(d=0.04)、フローの逆U字は p=0.053 と境界、P300 はフローと無関係だった。N=37 の探索的研究である。
Li et al.: ジグソーパズルで「AI は本当に形を見ているか」を測る — Fukai が読む
Shawn Li らによる視覚言語モデルの空間推論ベンチマーク JigShape の論文。凸凹の噛み合うピースで正解を一意にし 4×4 から 16×16 まで 95,468 問を用意したところ、ゼロショットで乱数を超えたのは GPT-5.5 だけ(4×4 で 69.65%)、8×8 以降は微調整しても崩れ、凹凸を消すと 97% が 10% に落ちた。
Bazzaz と Cooper: 生成AI と PCG を Steam レビュー 50万件で比べる — Fukai が読む
Northeastern の Bazzaz と Cooper による、Steam レビュー 508,192 件を分析した論文。生成AI 使用を開示したゲーム 5,970 本と PCG 使用の 5,186 本を比べ、好評率は PCG 86.3% に対し生成AI 68.4%(差 17.9 ポイント)、感情の内訳は生成AI 側で好意的 53.0%/否定的 47.0% と、ほぼ半々に割れた。600 件のテーマ分析からは「開発の手抜きの合図」「思想的拒絶」「条件付き受け入れ」「開示と実物の整合」「使うべきところで使わないことへの批判」の5テーマが立った。arXiv:2608.11539、ACM DOI 10.1145/3831347 割当済み。
Randelshofer et al.: AAA スタジオの UX リーダー15人に、企画段階の意思決定を聞いた — Fukai が読む
Ubisoft の Randelshofer 氏と Waterloo 大学 HCI Games グループらの共著による、AAA タイトルの UX リーダー15名(Blizzard、EA DICE、Guerrilla、Larian、Remedy、Ubisoft ほか)への半構造化インタビュー研究。企画段階の意思決定が「理論」「経験」「勘」の三つを場面に応じて混ぜて行われていること、strike/competency team という横断チーム構造、そして学術フレームワークが現場に届かない理由を反射的テーマ分析で整理する。arXiv preprint(2026年8月、査読前)。ゲーム制作の内側を UX の視点から覗ける貴重な質的研究である。
Cai et al.: 千人が同じ世界を見るために、学習モデルに「権威あるサーバ」を持ち込む — Fukai が読む
Alaya Lab・北京大学・東京科学大学の Cai 氏ら9名による、マルチプレイ環境のワールドモデルの論文。オンラインゲームの「権威あるサーバ」の取り決めを学習モデルに移植し、型付きの共有状態を進める Logic Engine と、そこから各カメラの絵を作る Rendering Engine に分離した。条件を揃えたマルチプレイ Snake で状態復元スコア 0.764(映像ベース最良は 0.128)、同時視点の食い違いは構成上 0.000。1,024体のプレイヤー実体を10,000手進めた。arXiv preprint(2026年8月6日投稿、査読前)。
Han et al.: 学ぶ順番が効く場面と効かない場面を、計算量で切り分ける — Fukai が読む
カリフォルニア大学デービス校の Han 氏ら5名による、教育系列化の計算量を扱った論文。前提条件でつながった概念を学ぶ順序の最適化を確率的最短経路問題として定式化し、失敗によるやり直しという確率性はコストを成功確率で割るだけで厳密に消せること、それでも最適順序の決定は NP 困難であること、そして最適化の前に「順番をいじって得られる利得の上限」を安価に計算できることを示した。入門CS科目の70,893件の実データではその余地が0.2%未満だった一方、人工的な罠では貪欲な順序が28.3〜45.1%の損をした。arXiv preprint(2026年8月5日投稿、査読前)。
Honda et al.: 「試す価値のある選択肢」を、減る不確実性の量で測る — Fukai が読む
東京大学の本多氏ら6名による B-EUR モデルの論文。ある選択肢を試す価値を「行動と結果の対応についての不確実性がどれだけ減ると期待できるか」で定式化し、グラフ形当てゲームでシミュレーションと人間実験(44名)を行った。試す価値・楽しさ・選ばれやすさはいずれも一般化可能性が中程度のときに最大となる逆U字を示した。結果の見分けやすさは選択行動には効いたが、主観評定には有意な効果が出なかった。arXiv preprint(2026年8月6日投稿、査読前)。
Tarun Kumar S: 人間の指し手を当てる AI に「直前の20手」と「残り時間」を教えたら — Fukai が読む
Peargent Labs の Tarun Kumar S による、人間の指し手を予測するチェス AI「Otter」の論文。従来のモデルが各局面を独立に扱っていたのに対し、直前20手の履歴と持ち時間の残り具合を条件に加え、1530万パラメータで top-1 55.23% を達成。Maia 2 を 1.98 ポイント上回った。盤面のみのベースラインからの改善 +7.62 ポイントのうち、履歴が +5.24、時計が +2.38。arXiv preprint(2026年8月5日投稿、査読前)。
Geheeb et al.: ゲームの「デザインピラー」を LLM に突いてもらう — Fukai が読む
ミュンヘン工科大学の Julian Geheeb らによる、ゲームのデザインピラーと LLM の論文。業界で広く使われながら学術的にはほぼ未整理だったピラーに形式的な定義と品質基準を与え、試作ツール SPINE で構造チェック・矛盾検出・機能評価を LLM に任せた。42時間のゲームジャムと開発者4名のインタビューから、ピラーを言葉にする局面には有用、書き直しは反復するほど薄まる、矛盾指摘は意図的な対比を認識できない、という像が出た。査読を通った FDG '26 論文。
Chen: 物語から「持続する世界」を先に復元してから遊べる場を作る — Fukai が読む
Yi-Chun Chen による物語からのゲーム生成の論文。シーンやゲームプレイを個別に生成する前に、物語から「持続する世界」(実体・場所・関係・状態)を明示的に復元し、全工程が共有する計算対象として維持することを中心課題に据える。GPT-5-mini と制約付き世界補完で世界を組み、PyGame のタイルベース環境として実現。3ケースでの定性的な実行可能性の実証にとどまり、定量評価はない arXiv preprint。
Huang et al.: 生成したゲームを AI に「遊ばせて」直させる — Fukai が読む
Yixu Huang ら(復旦大学・小紅書ほか)によるゲーム生成の論文。画面を見て操作する GUI エージェントをテストプレイヤーとして生成ループに組み込む Play2Code と、200 本・1,548 項目の評価環境 PlaytestArena を提案する。3モデル平均の基準通過率は、一回書き切り 29.7%、コード検査のみの既存手法 52.2% に対し 66.8% だった。
Wu et al.: 症例の文章を「決断が連なる物語」に組み替える — Fukai が読む
Qian Wu ら(香港中文大学ほか)による医療教育ゲーミフィケーションの論文。静的な症例報告を Act / Scene / Decision Node の三層台本に変換し、さらに多モーダル生成の依存グラフへ落とす二段構えの枠組み MedGame を提案する。5,000 症例の評価セットで追加学習すると構造的妥当性は 79.4% から 99.1% へ上がるが、医学的正確さは 7 点前後で頭打ちのままだった。
Wang et al.: パズルのソルバーを一手ごとの先生にする — Fukai が読む
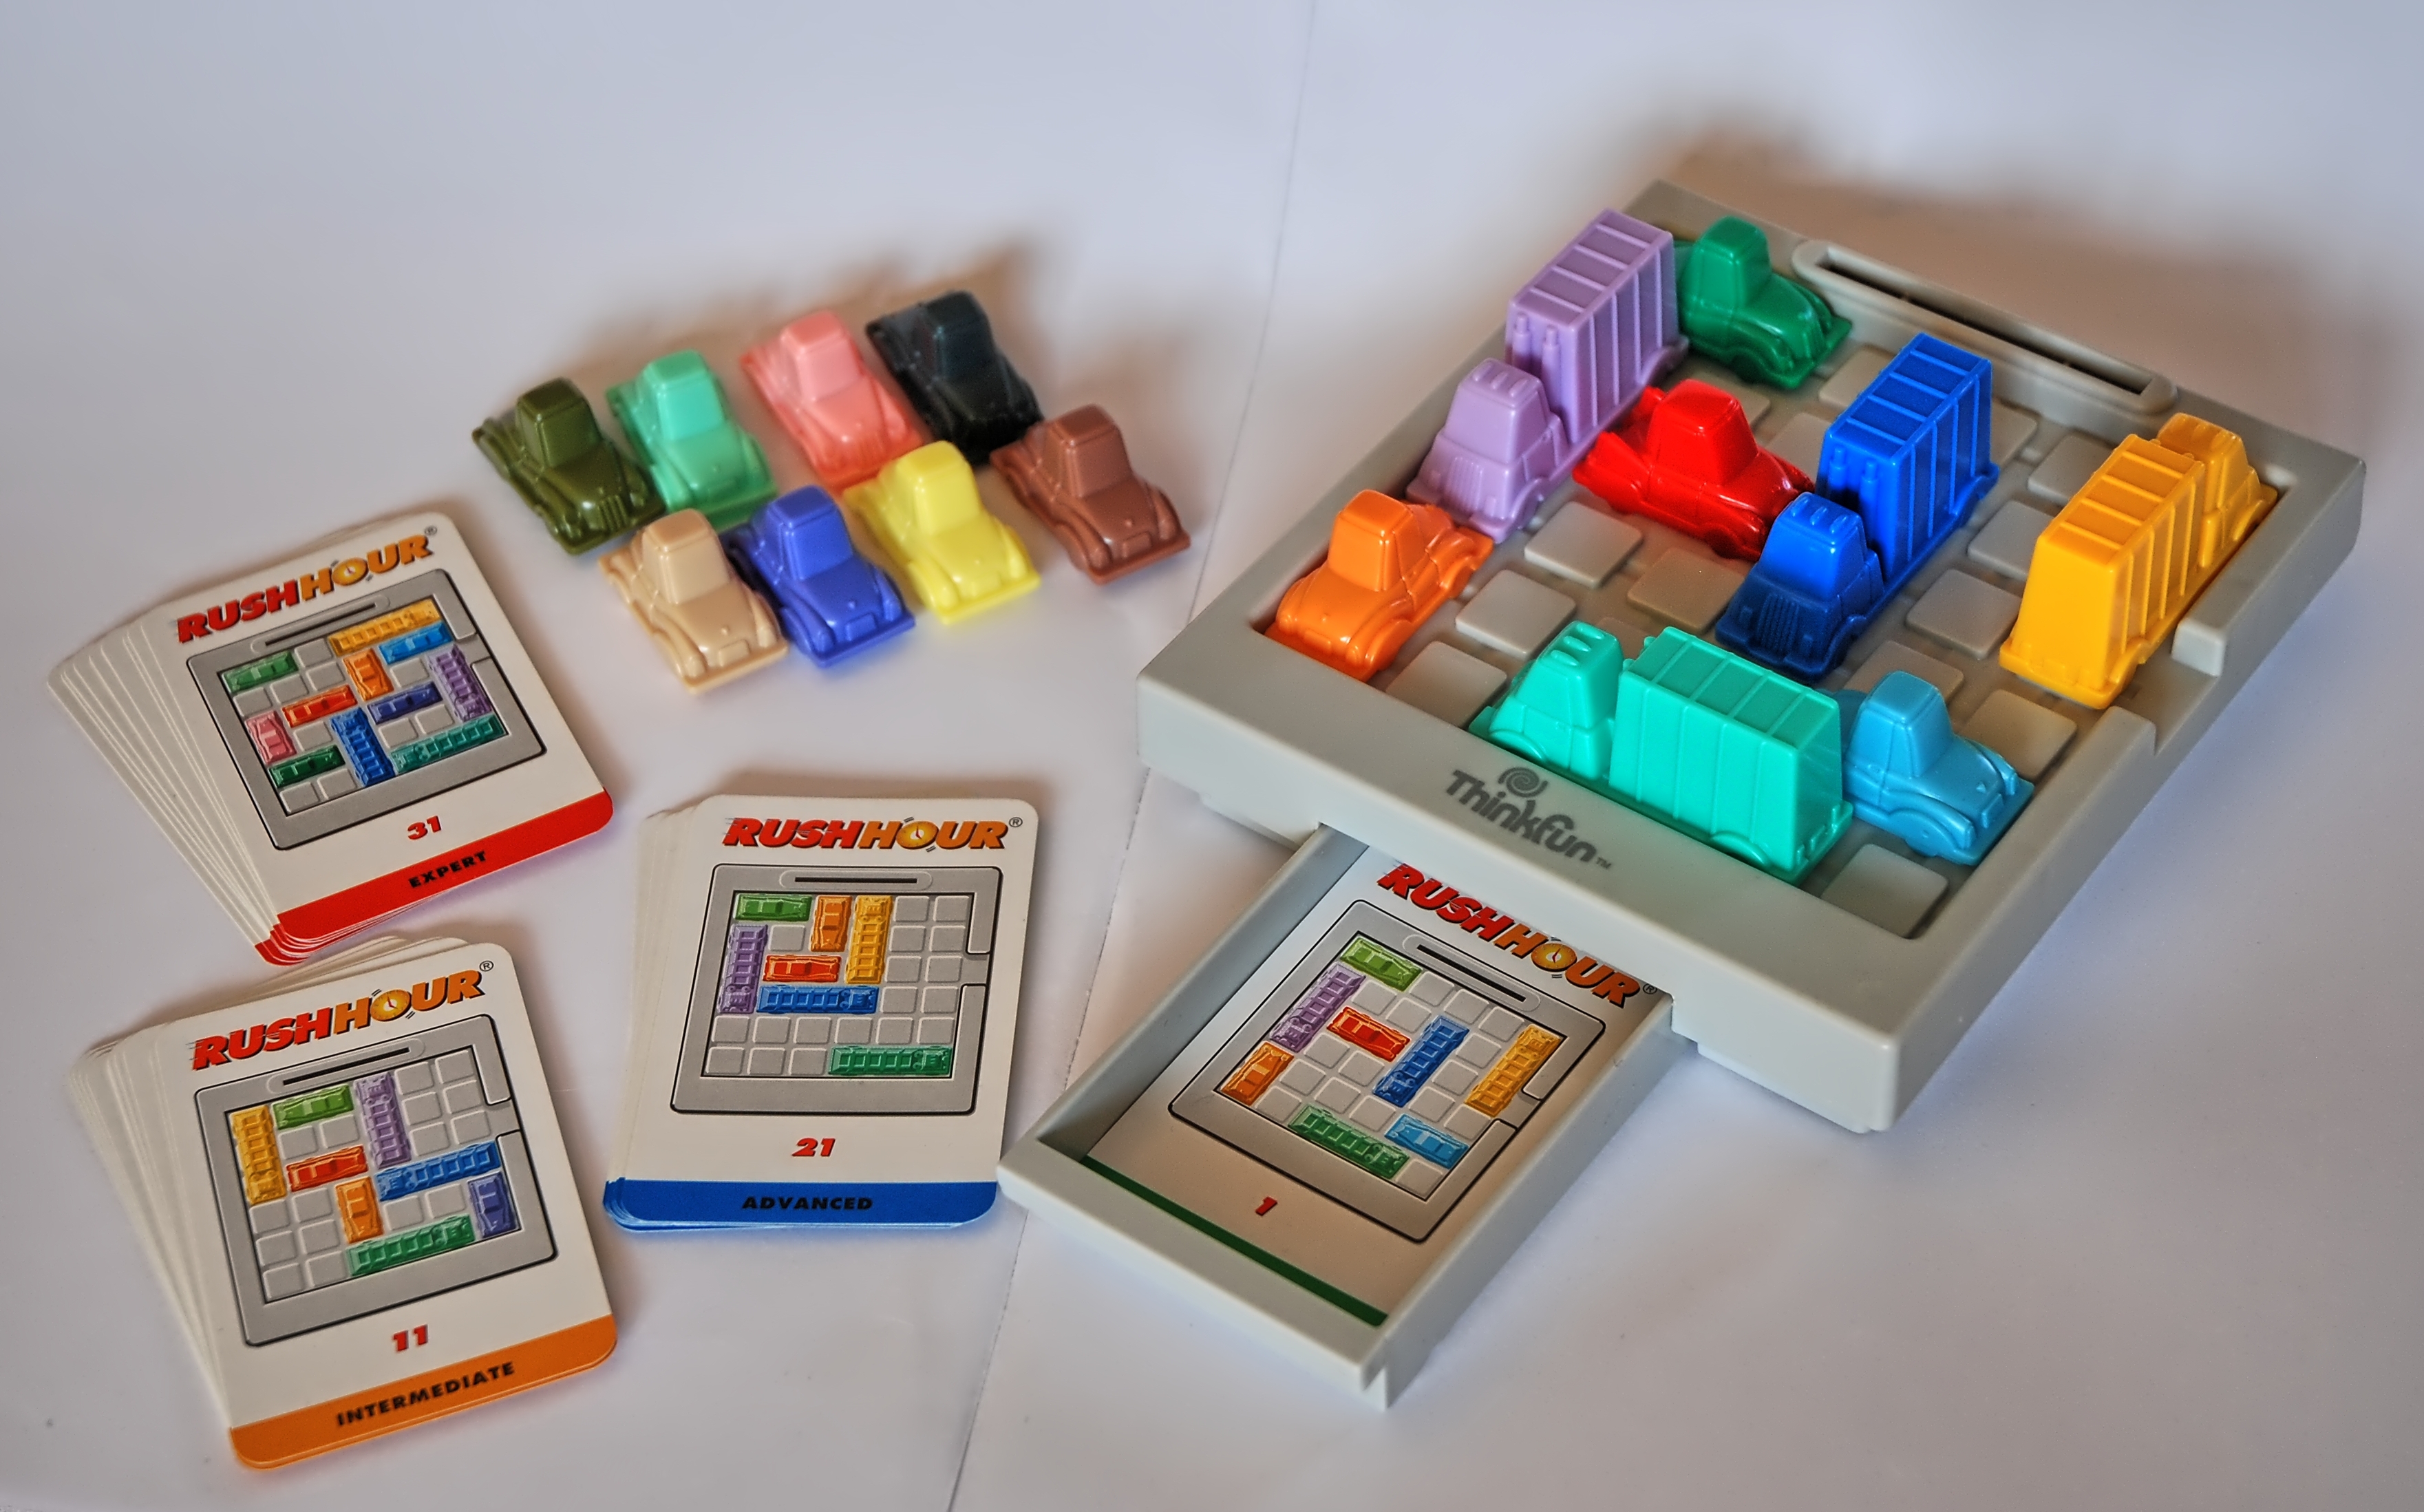
Yu Wang らによるゲーム AI の論文。長手数パズルで最後の勝敗しか報酬がない問題に対し、専用ソルバーが返す「ゴールまでの残り手数」の減り方を一手ごとの評価に変換して学習に混ぜる。Sokoban・Minesweeper・Rush Hour の三種平均で成功率を 16.6% から 62.1% へ、未学習難易度で 5.9% から 28.4% へ引き上げた。ソルバー問い合わせのコストは学習時間の 100 万分の 73 程度。
Ponnock & Ho: マリオ 1-1 の「順番」には、測れる教育効果があった — Fukai が読む
Jesse Ponnock と Lucas Ho による強化学習とレベルデザインの論文(arXiv preprint、査読前)。スーパーマリオブラザーズのワールド 1-1 をタイル格子として実装し直し、内容を固定したまま 6 区画の順序だけを入れ替えて学習させたところ、オリジナルの順番が収束最速・学習効率最高・破滅的失敗ゼロの唯一の条件だった。ただしこの順序効果はモンテカルロ法では現れ、再生バッファを持つ DQN では完全に消える。
Jeong et al.: 同じ問題でも、答え方を変えると難しさが変わる — Fukai が読む
Harim Jeong らによる認知負荷とインタラクション設計の論文(JMIR Serious Games、査読済み)。タブレット上のストループ課題で、刺激を固定したまま答え方だけを文字ラベルから色パッチに変えると、6〜12歳の子ども127人で正答率が 0.86 から 0.91 へ、反応時間が 85.4ms 短縮した。前頭前野の脳指標には有意差が出なかった。
Zhou et al.: 検証器がカリキュラムである — 起動チェックだけでゲーム自動生成を鍛える — Fukai が読む
Chenyu Zhou らによるゲーム自動生成の論文。採点モデルが騙せるという診断から出発し、Godot でエラーなく起動するかという白黒の判定だけを門番に自己蒸留を三周回して、未学習4ジャンルでの清潔な生成率を 8.8% から 42.2% へ、best-of-16 のカバー率を 18/25 から 25/25 へ引き上げた。門番を緩めると効果は消える。
Gould & Ward et al.: パズルの難易度を「人間の所要時間」で測る — Fukai が読む
Gould と Ward らによる AI 評価の論文。43 ベンチマーク・3万問超に「人間の所要時間」を付け、思考を書き出さないモデルが 50% 成功する課題の時間を測ったところ、6年で約373日ごとに倍増し GPT-5.5 で約3分に達した。数独やクロスワードを含む難易度計量の作法が、パズル設計にそのまま使える。
Li et al.: 動画生成 AI をゲームエンジンとして読み直す——「状態」という残された難所 — Fukai が読む
Zhen Li らによるインタラクティブ世界モデルのサーベイ。動画生成でゲーム世界を作る研究群を、ゲームエンジンの「行動—状態—観測」ループから取り出した4つの軸で整理し、残された難所がすべて「明示的なゲーム状態」に関わると指摘。『黒神話:悟空』の90時間超データセットも公開。
Teo et al.: AI は「助けすぎる」——問題解決中の介入を測る Int-Bench — Fukai が読む
Teo らによる LLM の介入行動の論文。AI アシスタントが問題解決中に「いつ・どれだけ助けるか」を Int-Bench という模擬環境で測り、AI は人間より早く頻繁に介入して答えを漏らしやすく、応用力を伸ばさないと報告。パズルのヒント設計に効く一本。
Halina & Guzdial: レベルを「時間のケーキ」として生成する — Fukai が読む
Halina と Guzdial による手続き的レベル生成の論文。レベルを「時間の各瞬間の盤面を積み重ねたケーキ表現」で表し、プレイの軌跡を組み替える PRP でレベルと解答を同時生成。倉庫番で六つの既存手法と比べ、遊べる率100%と高い多様性を、人手の制約や報酬なしで両立した。
Hsu et al.: LLM がしゃべる NPC は、プレイヤーの頭を重くする——「諸刃の剣」の実験 — Fukai が読む
Hsu ら(中国伝媒大学ほか)による LLM NPC の実証論文。同じゲームの「台本 NPC」版と「GPT-4.1 の LLM NPC」版を作り、130人の被験者間比較で検証。LLM NPC は認知負荷を有意に増やし(p<.001)、全体の面白さは有意に改善せず(p=.195)、自律感は上がるが使いやすさと信頼は下がる、と報告する。
Wang ら: Tetris Block Puzzle の難易度を強い AI の学習速度で測る — Fukai が読む
台湾・陽明交通大学と中央研究院のグループによる、スマホで人気の Tetris Block Puzzle の難易度を測る arXiv プレプリント。ルール変種の難しさを、強い AI(Stochastic Gumbel AlphaZero)がどれだけ速く高得点まで学習できるかで評価し、手札やプレビューを増やすと易しく、ブロック形状を追加すると難しく(T-pentomino が最大)なることを示した。
Johnson ら: 大規模言語モデルを組み込むとゲームはどう変わるか — Fukai が読む
カルガリー大学の Johnson らによる、LLM をゲームの構造に組み込んだ二本のゲーム開発の質的研究。LLM を「飾り」でなく「部品」として埋め込むとゲームプレイ・遊びやすさ・プレイヤー体験がどう変わるかを、開発者の内省から分析。変化と個人化が増える一方、正しさ・難易度較正・一貫性という新たな負担が生まれ、スキーマ強制と検証が鍵になると報告する。
Earle et al.: レベル設計を「1人の作業」から「複数エージェントの協働」に組み替える — Fukai が読む
Earle らによる強化学習レベル生成(PCGRL)の論文。1体のエージェントが盤面を編集する従来手法を、複数エージェントが手分けして同時編集するマルチエージェント問題に組み替え、エージェントを増やすほど生成の質・未知の盤面への一般化・計算効率が上がることを、迷路とダンジョンの二領域で示した。
Bhaumik et al.: WFC と強化学習を縫い合わせて「遊べて綺麗な」レベルを作る — Fukai が読む
Bhaumik らによる手続き的レベル生成の論文。「見た目は良いが遊べない」WFC と「遊べるが汚い」強化学習の弱点を、WFC の局所ルールで強化学習の行動を絞り込む WCRL で解こうとし、ロードランナーで見た目と遊べることを両立したレベルを生成した。
Shyne et al.: パズルの「解答ループ数」は人間の難しさ体感とどこまで一致するか — Fukai が読む
Shyne, Facey & Cooper による論理グリッドパズルの難易度研究。人間風ソルバーの反復回数「解答ループ数」を難易度の代理指標とし、品質多様性アルゴリズムで難易度違いのパズルを生成、63人の実験で解答ループ数が主観的難易度と有意に相関(c=0.30, p=0.015)することを示した。
Nath ら: 配信で「映像が汚れる」ゲーム AI をどう鍛えるか — Fukai が読む
Microsoft のチーム(Nath ら)による、配信されるビデオゲームの模倣学習エージェントの論文。クラウドゲーミングで映像に生じる時間的につながったノイズを人工的に作って学習に混ぜる「ストリーミング拡張」を提案。わずか5本のデモでも最大4割ほど達成率が上がり、通信遅延下の性能低下を 49.82% から 7.45% に抑えた。
Ye ほか: 子ども向け知能検査で画像も扱う AI(MLLM)を測る — Fukai が読む
ShanghaiTech 大学の Hengwei Ye らによる、子ども向け知能検査(ウェクスラー式)に着想した MLLM 評価ベンチマーク KidGym の論文(arXiv プレプリント)。実行・知覚推論・記憶・学習・計画の5能力を2Dグリッド上の12課題・難易度3段階で測り、9モデルを評価。上位モデルでも抽象図形パズルは最高0.30、数え上げは人間1.00に対し最高0.72にとどまった。
Zeng et al.: ゲームバランス調整を LLM 同士の自己対戦で自動化する — Fukai が読む
Zeng らによる自動ゲームバランス調整の論文。非対称戦略ゲームのバランス調整という問題を、複数の LLM の自己対戦を評価器に、ベイズ最適化でルールのパラメータを探索することで扱い、自作ゲーム CivMini で勝率差がほぼ0%になる設定へ収束できたと報告する。
Waugh: 数独やスリザーリンクで AI の推論力を測る — Fukai が読む
Approximate Labs の Justin Waugh による、ペンシルパズルで LLM の推論を測るベンチマーク Pencil Puzzle Bench の論文(arXiv プレプリント)。62,231 問・94 種類から 300 問を選び、一手ごとにルール違反を機械が検算できる点を核に 51 モデルを評価。最強の GPT-5.2 でもエージェント的解法で 56.0% にとどまり、約半分が未解決だった。
Ahn et al.: パズルの難しさは「見た目」ではなく「概念」に宿る — Fukai が読む
ボストン大学の Ahn らによる、抽象推論ベンチマーク ARC を人間向けに組み直した CogARC の論文(arXiv プレプリント)。のべ 260 人のグリッドパズル解答を一手ずつ記録し、難しさは盤面の大きさや色数ではなくルールの概念的複雑さで決まること、人は間違えるときも同じ誤答へそろって収束することを示した。
Luo et al.: AI の「助け方」は助けの中身と同じくらい効く — Fukai が読む
UC Santa Barbara の Luo らによる、混合主導 AI の「助け方」に関する論文。ラッシュアワー・パズルを題材に、ボタンで要求するオンデマンド助力と、無操作時間で自動発動するタイマー助力を比較し、成績はほぼ同じでもタイマー型のほうが AI への評価が高くなることを示した。IUI '26 採択。
Ying et al.: あらゆる「人間のゲーム」で AI の一般知能を測る — Fukai が読む
MIT・ハーバードらの研究チームによる、AI の一般知能を『人間が作ったゲーム』で測るプレプリント。App Store と Steam の人気作100本を LLM で作り直し、7つの最新視覚言語モデルに遊ばせたところ、最強でも人間の中央値100に対し8.5点にとどまり、記憶・計画・ルールの推測で人間に大きく及ばなかった。
Triebel et al.: 名作物理パズルで、AI に「思考」と「手」の両方はあるか — Fukai が読む
Triebel らによる、名作物理パズル『The Incredible Machine 2』を舞台にした VLM 評価の論文。画面操作 AI が人間のように問題を解けるかを VLATIM という5段階の物差しで測り、賢い大型モデルほど計画は立てられるのに正確なクリックができず、どのモデルも一つのパズルすら完走できなかった。
Nasvytis & Fan: ひらめきと「転移」は話し方に表れる — Fukai が読む
スタンフォードの Nasvytis と Fan による、ひらめきと転移を思考発話から捉えた論文。参加者189人にマッチ棒数式パズルを5問解かせ、同じ型を繰り返す群は初正解後も速く正確になり(試行5で正答率0.75)、問題の型を口に出す割合が約7倍に増えた。転移の印は『コツを言葉にできること』だと読める。
Li et al.: 記号ソルバーを審判にして幾何問題を「検証可能」に解く — Fukai が読む
Can Li らによる幾何問題解決(GPS)の arXiv プレプリント。図と文の問題を記号ソルバーが実行できる形式へ翻訳し、行き詰まりでは補助的な補題を提案してソルバー自身に検証させる SD-GPS を提案。要旨によれば Geometry3K・PGPS9K で既存手法を一貫して上回ったという。解けることを保証するパズル生成への応用を Fukai が読む。
Sestini et al.: AAA ゲームの NPC を強化学習で「本物らしく」する — Fukai が読む
Electronic Arts の研究チームによる vision 論文。AAA ゲームの NPC を強化学習で改良できるかを、EA SPORTS FC 25 のゴールキーパー位置取りと Battlefield 6 の歩兵移動という2つの実例で検証し、制作現場で RL を使うために満たすべき7つの要件を整理する。RL は既存のゲーム AI を置き換えるのではなく補強する道具だ、と結論づける。
Xu ら: 生成AIが「遊びの芯」になるゲームとは — Fukai が読む AIネイティブゲーム調査
Zhiyue Xu ら6名による、生成AIが中核ループそのものになる「AIネイティブゲーム」の調査論文(arXiv プレプリント)。「AIを外したら遊びが成立しないか」という反実仮想で定義し、実在53本をゲームの型(G)と支配的なAIの働き(N)の二軸で分類。物語系に偏り、ルールを裁く使い方は薄いことを示す。
Wermann et al.: ゲーム内 AI の「言葉」と「実演」で学びと認知負荷はどう変わるか — Fukai が読む
LMU ミュンヘンらによる、シリアスゲーム内の AI NPC が与える「言葉による支援」と「実演による支援」を比較した事前登録済みの実験。量子技術を学ぶゲーム Qookies で 152 名を3群に分け、学習効果には群間差が出なかったが、言葉+実演の群は言葉のみの群より内在的認知負荷が有意に低かった(d=0.60)。
Aryan et al.: 行き詰まると世界が変わる——静的なRL環境を「適応の試験場」に変える AbideGym — Fukai が読む
Abide AI の Aryan らによる強化学習の環境設計の論文(preprint)。訓練環境が最初から最後まで固定だとAIがもろくなる問題を、プレイ中にAIの「手が止まったこと」を引き金にルールや地形を変える AbideGym で扱い、覚えた手順を崩して立て直しを促す設計と既存手法との比較を示した(実験結果は未掲載)。
Wang et al.: 視線から「頭の忙しさ」を読む LLM エージェント — Fukai が読む
Meta Reality Labs らによる、視線データから認知負荷(頭の忙しさ)を推定する論文。従来手法の低い汎化性と解釈しにくさを、視線を構造化して LLM に文脈・個人差・お手本つきで推論させる枠組み GazeMind で扱い、3段階分類で 62.73% の精度(既存手法比 +20 ポイント超)を報告した。
Mirowski et al.: 物語を「書く」から「見つける」へ — 作家コミュニティと育てた執筆AI「Fabula」 — Fukai が読む
Google DeepMind による執筆支援AI「Fabula」の論文。物語を階層的に計画・生成する「ドラマ・マネージャ」を、42名の専門家との参加型デザインで批判的に育てた記録で、構造づくりは得意だが文体や意外性は苦手だと分かった。ゲームのインタラクティブ・ナラティブに直接効く知見を Fukai が読む。
Özkan: レベルを生成する AI と攻略する AI を一緒に育てる — Fukai が読む
Miraç Buğra Özkan による、強化学習でレベル生成と攻略を同時に学ばせる論文。Unity 上でハチドリ(攻略役)と浮遊島(生成役)の2体を互いの成績を見ながら学習させ、未知レイアウト100種で約90.2%の攻略成功率に到達した。
Liu et al.: 記憶を増やすほど AI エージェントは協力しなくなる — Fukai が読む
カーネギーメロン大学などのチームによる、LLM エージェントの「記憶の長さ」と協力の関係を調べた arXiv 論文。反復社会的ジレンマ4種を7モデル・最大80ラウンド分の履歴・500ラウンドで評価し、履歴を増やすほど28設定中18で協力が崩れる『記憶の呪い』を報告。原因は文脈長ではなく蓄積した裏切り記録の内容で、前向きな推論で部分的に緩和できると示す。
Feng et al.: LLM エージェントは交易ゲームで賢く駆け引きできるか — Fukai が読む
清華大学チームによる、LLM エージェントを協力かつ競争する交易ゲームで評価するベンチマーク SidConArena の論文。ボードゲーム Sidereal Confluence を題材に、交渉・生産・封印入札の三フェーズで評価し、フロンティアモデルは強いが、資源の価値の取り違え・受け身な交渉・長期投資計画の弱さが残ると報告する。
Bazzaz et al.: 「AI 製だと思う」だけで体験が変わる — Fukai が読む
Bazzaz と Cooper による、生成コンテンツの知覚バイアスを扱う CHI '26 論文。Super Mario Bros. と Sokoban で人間作・AI 生成レベルを混ぜて 142 人に遊ばせ、プレイヤーは作者をほぼ当てられないのに、AI 製だと信じたレベルほど楽しくない・難しい・苛立たしいと評価した、と報告する。
Liu ほか: AI の手助けは「粘り」を奪う——独力とヒント設計への警告 — Fukai が読む
Grace Liu らによる、AI支援が独力での問題解決と粘り強さに与える影響を調べた論文。計1,222人のランダム化比較試験で、AIは作業中の成績を上げる一方、AIを外すと成績が下がり途中で諦めやすくなることを示した。答えを直接もらった人ほど落ち込みが大きく、ヒント利用者は落ちなかった——ゲームのヒント設計に直結する。
Jara Gonzalez & Guzdial: 敵の「形」を、動きで倒せる関門として自動生成する — Fukai が読む
Jara Gonzalez と Guzdial による敵モーフォロジー(当たり判定の形)生成の論文。「特定の動きでだけ倒せる敵」を 4×4 グリッド上で生成する問題を、強化学習・A*探索・ニューラル生成の三手法で扱い、素朴な A* 到達可能性ルールが最良のゲート性能と多様性を最小コストで示した。
Munk et al.: 小さな言語モデルでゲームのテキストを動的生成する — Fukai が読む
コペンハーゲン IT 大学の Munk らによる、小規模言語モデル(SLM)でゲーム内テキストを動的生成する論文。クラウド LLM のオフライン化・コスト・一貫性という壁を、狭い仕事に特化させて微調整した小さなモデルで解こうとする。中世 RPG の中傷ビラ生成を担う DefameLM を概念実証とし、10 億パラメータ級モデルが家庭用 PC 上で数秒・高品質に届くことを示した。
Zeytuncu: パズルの難しさは『使う数の個数』で決まる — Fukai が読む
Yunus E. Zeytuncu による整数四則パズル(数を組み合わせて目標数を作るナンバーズ系)の難易度モデリング論文。約 347 万問を厳密ソルバーで生成し、難易度を最小手数で定義したうえで、最小解で使う数の個数だけが難易度を完璧に決める『最小十分統計量』だと示した。
Chao et al.: ひらめきの正体は「遠くまで探す」こと — Fukai が読む
Chao・Hsieh・Wu による洞察的問題解決(ひらめき)の論文。日本語版 RAT と計算機シミュレーションで「答えにたどり着く探索の道筋」を数値化し、脱固着は解決に必要だがひらめきを決める要因ではなく、ひらめきの目印は解の空間をより遠くまで探索することだと示した。
Monti et al.: 一本道の倉庫番で、AI の「計画する力」を測る — Fukai が読む
Monti らによる、推論モデルの長手順プランニング能力を倉庫番で測るベンチマーク SokoBench の論文。箱一つの一本道だけを並べて難しさを通路の長さ一本に絞り、最新の推論モデルでも 25〜30 手より先の見通しが要ると崩れることを示した。原因は「数え間違いの蓄積」にあると著者らは見る。
Luo et al.: AI エージェントは実際のゲームエンジンで遊べるゲームを丸ごと作れるか — Fukai が読む
Luo, Wang らによる、コーディングエージェントの End-to-End ゲーム生成を測る評価基盤 GameCraft-Bench の論文。自然言語仕様から Godot 上で遊べるゲームを丸ごと作らせ、起動・操作再生・映像採点で判定する 140 課題(15 ジャンル)を提案。最強の構成でも全体 41.46% にとどまり、エージェントは仕組みは作れても内容・見やすさ・仕上げを備えた完成品には届かない、と報告している。
Li ら: ボードゲーム設計を発想から完成まで一気通貫で支援するAI「AutoBG」 — Fukai が読む
Zizhen Li らによるボードゲーム設計支援AI「AutoBG」の論文(arXiv preprint)。発想・ルールブック生成・個別フィードバックという設計工程全体を、生成役と評価役を分ける Verifier-Gated Iteration で扱い、評価役 BG-Critic の診断の質は GPT-5.4 を上回ったと報告する。
Nasir ら: ゲームの「ルールそのもの」を進化させる — Fukai が読む MORTAR
Nasir・Togelius らによる自動ゲームデザインの論文。レベルではなく「メカニクス(ゲームのルール)」そのものを、品質多様性アルゴリズムと大規模言語モデルで進化させ、強さの違うAI同士の勝敗で質を測る MORTAR を提案。GPT-4o-mini で多様で遊べるゲームを生成し、各メカニクスの貢献度まで数値化した。
Jiang ら: 言葉だけで「遊べるゲーム」は作れるか — Fukai が読む OpenGame
Yilei Jiang ら(香港中文大学)による、自然言語からウェブ2Dゲームを丸ごと自動生成するエージェント OpenGame の論文。再利用できる骨組みと『生きたデバッグ手順書』で統合エラーを抑え、150課題で最高水準を達成。ただしパズルは最も苦手なジャンルとして残った。
McConnell & Zhao: 遺伝的アルゴリズムで「ちょうどいい難しさ」のパズルをリアルタイム生成する — Fukai が読む
McConnell と Zhao による、遺伝的アルゴリズムを使った適応的パズル生成の論文。Cosmic Express 風の経路パズルを、プレイヤーの解き方を記録するプレイヤーモデルに合わせて1問約7秒でリアルタイム生成し、18人の実験で「時間だけ」に頼る版が体感難易度・進行感で見劣りすることを示した。
Li ら: LLM は2Dゲームを「遊んで勝てる」か — Fukai が読む GVGAI-LLM
Li ら(NYU ほか)による GVGAI-LLM の論文。118本の2Dゲームを言語モデルに遊ばせ、推論力と空間把握を測るベンチマークを提案。盤面を ASCII 地図に翻訳して zero-shot で解かせると、GPT-4o-mini は540レベル中477で勝率0%、全体勝率10.27%にとどまり、古典的な探索アルゴリズムに及ばなかった。問題・方法・発見・使いどころ・限界の順に解きほぐす。
Kar: 生成したコースが本当に通れるかを実行中に自動エージェントで検べる — Fukai が読む
King's College London の Rishabh Kar による PCG(コンテンツの自動生成)の論文。生成したコースが本当に通れるかという検証を、ゲームを止めず実行中の同じループの中で行う仕組み Momentum を提案。プレイヤーの先を2体の自動エージェントが走り、空中からの幾何チェックと地上の NavMesh チェックで先回りして道を点検する。評価はコードから導いた構造的な見積もりで示される。
Xu et al.: ゲームの「仕掛け」を座標に格上げして解けるレベルを自動生成する — Fukai が読む
McGill 大学の Xu と Verbrugge による PCG(レベル自動生成)の論文。地形優先だった従来手法に対し、重力反転や移動床といった「仕掛け」を座標の一つに格上げした次元拡張グラフ上で経路探索を行い、解けることを生成の最中に保証する HDPCG を提案。Unity 上で実際に遊べるレベルまで再現してみせた。