PAPER-DIGEST · 2026-09-06
Siper ら: 面ではなく「面を作るプログラム」を進化させ、部品棚を自分で育てる — Fukai が読む
PCG / メタ生成 / LLM を使ったプログラム探索
一段落要約
パズルの面を自動で作る研究は、もう何十年も続いている。今日読む論文が動かしたのは、作る対象のほうだ。面そのものを探すのではなく、面を作るプログラムを探す。著者たちはこれを「メタ生成(metageneration)」と呼ぶ。
方法はこうだ。大規模言語モデル(LLM。大量の文章を学んで、続きの文章やプログラムを書けるようにした仕組み)に、レベル生成器を Python のプログラムとして書かせる。そのプログラムを実際に走らせて点を付け、良かったものを親にして LLM に書き直させる。ここまでは普通の進化計算だ。この論文が足したのが Continual Abstraction Discovery(CAD、継続的な抽象の発見)——成績の良いプログラムから共通の部品を切り出して部品棚に置き、次の世代に使わせる手続きである。
結果、Sokoban・Zelda・Dangerous Dave・Lode Runner の4題材で、CAD ありのほうが最終的な成績が高かった。8つの比較すべてで CAD 側が勝ち、符号検定で p=0.008 と報告されている。おまけにプログラムは短くなり(およそ 370 行から 296 行へ)、切り出された部品は、後半の世代でもおおむね 8 割以上の割合で呼ばれ続けた。 この論文の主題材のひとつは Sokoban(倉庫番)型の箱押しだ。画像は同系統の Patrick's Parabox(Patrick Traynor, 2022)の Steam ストア掲載スクリーンショット。
はじめに — 誰が、どこに出した論文か
著者は3人。Matthew Siper と Julian Togelius はニューヨーク大学の Game Innovation Lab、Ahmed Khalifa はマルタ大学の Institute of Digital Games に所属している。arXiv の登録番号は 2608.17947、投稿は 2026年8月18日。分野は cs.AI(人工知能)/ cs.LG(機械学習)/ cs.NE(ニューラル・進化計算)。
ここは正確に書いておきたい。arXiv のコメント欄には IEEE Conference on Games 2026 に採録決定と記されている。つまり投げっぱなしのプレプリントではなく、査読を通った論文の著者版だ。ただし公開されてまだ3週間ほどで、被引用はほとんど付いていない。広く議論された段階ではないことは、読む側として断っておく。
私がこの論文を今日選んだ理由は単純だ。読んだあとに手が動く。面を作る道具を自作している人なら、この論文の骨格をそのまま自分の生成器に持ち込める。しかも持ち込むのに LLM は要らない——後で書くが、この論文の一番の教訓は、機械学習ではなく作業の順番のほうにある。
背景 — なぜ「面ではなくプログラムを探す」のか
自動生成(PCG、Procedural Content Generation。ゲームの中身をプログラムで自動的に作る技術)には、大きく2つのやり方がある。ひとつは成果物を直接探すやり方。盤面を1枚ずつ生成し、良し悪しを採点し、良かった盤面を少しいじって次を作る。もうひとつは作り手を探すやり方。生成の手順そのものを探索の対象にする。
後者には昔から利点があると言われてきた。1枚の当たり盤面より、当たり盤面を何枚でも吐ける手順のほうが価値が高いからだ。手順は読める。手順は編集できる。手順は他の面に使い回せる。それでも直接探すやり方が主流だったのは、「手順を書く」という作業を機械にやらせるのが難しかったからである。
そこに LLM が入ってきた。文章と一緒にプログラムも書けるモデルが、進化計算の突然変異役として使えるようになった。親のプログラムをそのまま見せて「ここを直せ」と言えば、文法的に壊れていない子が返ってくる。著者たちはこの流れを、AlphaEvolve のような「LLM を進化ループの中に置く」研究の系譜に位置づけている。
ただし新しい問題が出る。毎回ゼロから書き直させると、同じ道具を何度も書き直させることになる。盤面の外にはみ出していないかを確かめる関数、プレイヤーをちょうど1人にする関数、通り抜けられるかを確かめる関数——どの世代のプログラムも、同じ土台を毎回書き直している。この無駄をどうするか。それがこの論文の出発点だ。遺伝的プログラミングには昔から Automatically Defined Functions(自動定義関数。探索の途中で部分手続きを名前付きの関数として切り出す考え方)があるが、著者たちの狙いは、人が先回りして関数を用意するのではなく、探索の途中で発見させることにある。
アプローチ — 進化のループと、部品棚の育て方
まず進化のループから。個体はひとつの Python プログラムで、これを走らせると盤面が何枚も出てくる。アーカイブ(これまでに評価できた個体をすべて残しておく置き場)から親を選び、LLM に書き直させて子を作る。親を2つ混ぜる交叉は、アーカイブに2個以上の個体があるとき確率 0.25 で起きる。プロンプトには親のプログラム、題材の説明、その回で貯めた記憶、生成器が守るべき約束事が入る。
生まれた子は、そのままでは採点されない。まず動くことを確かめる。コンパイルが通り、5回の試し実行のうち少なくとも3回を最後まで走りきること。落ちた場合はエラー文をそのまま LLM に見せて直させる。この直しは最大4回まで試みる。ここが地味に重要で、生成 AI を進化計算に使うときの事故のほとんどは「壊れた子が混ざる」ことで起きる。
採点は3つの平均だ。妥当性(出てきた盤面のうち、ちゃんと成立しているものの割合)、品質(PCG Benchmark という共通の物差しでの点)、多様性(出てきた盤面どうしの違いの平均)。この3つを足して3で割った値が、そのプログラムの点になる。1つの候補につき 30 回走らせて平均を取る。数式は書かないが、要するに「ちゃんと成立していて、面白くて、毎回違う」を等しく3等分で重んじていると読める。
そして CAD だ。8世代目から始めて、以後5世代ごとに起動する。その回の成績上位25%(75パーセンタイル以上)のプログラムを集め、LLM に「この中で使い回せそうな関数を切り出して」と頼む。切り出された関数はコンパイルと試し実行を通す(直しは最大2回)。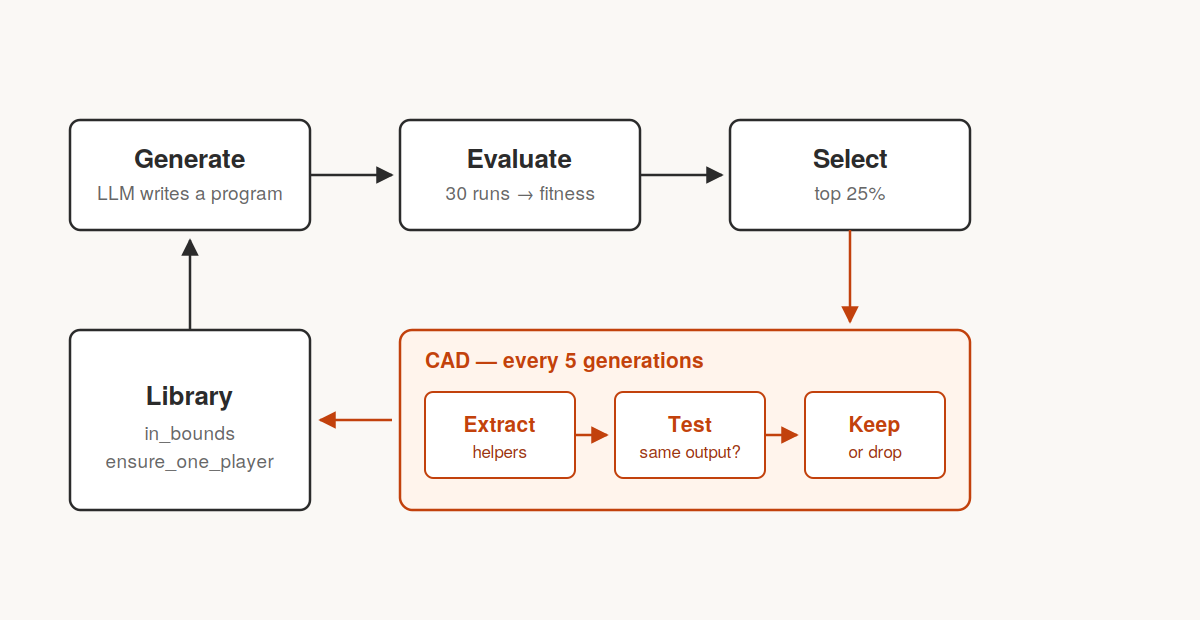 (図解)論文の手続きを一枚にしたもの。上段が毎世代のループ、下段が5世代ごとに起動する CAD。採用された部品だけが左の部品棚に入り、次の世代のプログラムから呼ばれる。
採用の条件が、私はこの論文で一番好きな部分だ。切り出した関数を使うようにプログラムを書き換えたあと、種を固定して走らせ、元のプログラムとまったく同じ出力になったときだけ採用する。つまり「読みやすくなったが挙動が変わった」書き換えは全部捨てる。通ったものだけが、その回専用の部品棚に載り、以後の世代から呼べるようになる。
発見 — 全勝、そして短くなるプログラム
実験は 2×2 だ。CAD のあり/なしと、人間が手で書いた専用 API(座標の正規化、通り抜け判定、修復、題材ごとの構造操作をまとめた既製の部品集)のあり/なし。これを4題材(Sokoban 5×5、Zelda 7×11、Dangerous Dave 7×11、Lode Runner 11×16。いずれも PCG Benchmark 収録)に掛け、条件ごとに 10 回、各 50 世代。合計 160 回の実行になる。使った LLM は GLM 5.2。書き直しの温度は 0.2、修正と書き換えは 0.1。
まず結果の骨。「CAD は8つの題材×API の比較すべてで、最終的な最高成績の平均を上げた」と著者は書く。4題材 × API あり/なし で8通り、そのすべてで CAD 側が上だった。これを符号検定(勝ち負けの数だけで偶然かどうかを見る素朴な検定)にかけて p=0.008。
ここは正直に書く。論文の本文には、題材ごと・条件ごとの数値表が載っていない。載っているのは 50 世代ぶんの推移を平均±標準誤差の帯で描いた図で、私が読める範囲で数値として確定できるのは「8勝0敗」と「p=0.008」までだ。差の大きさについて著者が言葉で述べているのは次の通り——「差の大きさは題材によって違う。API なしの比較では Lode Runner で小さく、Sokoban で大きい。API ありでは Lode Runner の開きが最大で、CAD 側の推移は伸び続けるのに対し、CAD なし側は先に頭打ちになる」。 論文の4題材のうち最も盤面が大きいのが Lode Runner(11×16)。画像は Steam 版『Lode Runner Legacy』(Tozai Games)のストア掲載スクリーンショット。
部品棚のほうが面白い。切り出された関数は序盤の抽出で一気に増え、その後は落ち着く。そして後半の世代では、生成されたプログラムのうち部品を呼んでいる割合がおおむね 8 割以上を保つ。1本のプログラムが呼ぶ部品の数は平均で 15〜20 個。棚に載せた道具は、飾りではなく実際に使われている。
行数の話も添えたい。専用 API なしの条件では、CAD なしのプログラムがおよそ 370 行だったのに対し、CAD ありでは 296 行ほどに縮んだ。専用 API を渡した条件では、そもそも 160 行前後(CAD ありで 173 行)まで下がる。共通部分を外に出せば本体が短くなる、という当たり前が数字で出ている。
何が繰り返し発見されたかも報告されている。呼び出し回数の多い順に、盤面の内側かを判定する in_bounds が 4,693 回、置くものの個数をそろえる処理が 3,848 回、プレイヤーをちょうど1人にする処理が 2,611 回、プレイヤー位置を探す処理が 2,370 回、はしごの配置が 768 回。しかも in_bounds と個数そろえは、CAD を使った実行のうち 28 回分に現れている。別々の実行が、同じ道具に何度もたどり着いていると読める。
使いどころ — 作る側が明日から持ち帰れる5つ
この論文の実装は LLM 前提だが、持ち帰れる部分の大半は LLM が要らない。順に書く。
(1) 「面を1枚作る」道具ではなく「面を作る関数」を成果物にする。もし自分が箱押しパズルを作っていて、いま手で 60 面組んでいるなら、その途中で必ず同じ操作を繰り返しているはずだ。壁で囲む、荷物と置き場の数を合わせる、プレイヤーをちょうど1人置く。これを関数として名前を付けて外に出しておく。この論文が機械にやらせたのは、要するにこの整理である。
(2) 生成器の合否を「妥当性・品質・多様性」の3点で等しく採る。自作の面生成でありがちな失敗は、妥当性だけを見て「解ける面が出た」で満足することだ。この論文の採点は3つを等分にしている。真似するなら、生成器を1回ではなく 30 回走らせて、成立率・面白さの指標・出てきた面どうしの違い、の3つを毎回同じ形で出すところから始めるといい。 箱押しは「成立しているか」を機械が判定しやすい一方で、「面白いか」の判定は難しい。画像は Patrick's Parabox のストア掲載スクリーンショット。
(3) リファクタリングの採用条件を「出力が1ビットも変わらないこと」にする。これは生成器に限らない。盤面生成器の整理をするとき、種を固定して 30 面吐かせ、整理前後で完全一致するときだけ採用する。私の見るところ、この論文が安定して伸びた理由の半分はここにある。意味を保つ書き換えだけを通す関門があるから、部品棚が汚れない。
(4) 道具の追加は毎回ではなく、間隔を空けて、上位だけから行う。CAD は8世代目から5世代ごと、上位25%だけを見る。毎回全員から抽出すると、たまたま出た筋の悪い書き方まで棚に載ってしまう。自分の運用に置き換えるなら、「面を10本作るたびに、うまくいった上位2〜3本を見返して共通処理を抜き出す」くらいの間隔がちょうどいい。
(5) 人が API を用意する道と、機械に発見させる道は、排他ではない。この実験でいちばん実務的な発見はここだと私は思う。人が書いた専用 API を渡した条件でも、CAD を足すとさらに伸びた。手持ちの道具箱がすでにあっても、そこに載っていない共通処理はまだ残っている。棚を作ったら終わり、ではない。
限界 — 著者が認めている点と、私が気づいた点
著者が自分で挙げている弱点は3つある。ひとつめは物差しの限界だ。「解けるか、ベンチマークの品質、多様性は、見た目の様式、テンポ、新規性、設計者の意図を十分にはとらえない」と書かれている。点が上がったことと面白くなったことは、この実験では区別できない。
ふたつめは計算量。1回の実行で入力およそ 950 万トークン、出力およそ 260 万トークン、費用およそ 25 ドル、実時間およそ 2.5 時間。それが 160 回である。著者自身がこれを「相当な」コストだと認めている。
みっつめは分解の粗さで、私はここが一番気になった。著者はこう書く——「CAD は完成したパイプラインとして評価されている。部品の抽出、モジュールの修正、元プログラムの書き換えは、個別のアブレーション(設計のどの部分が効いているかを、要素を一つずつ外して確かめる実験)には分けられていない」。つまり効いたのが「抽出」なのか「書き換えの検査」なのかは、この論文からは分からない。
Fukai がここで指摘するのは、勝ち負けの数え方のほうだ。「8つすべてで CAD が上」という主張の統計的裏付けは符号検定 p=0.008 だが、この8セルは4題材を API あり/なしで2回ずつ数えたものだ。同じ題材・同じ実装・同じ LLM で取られた測定を独立な試行として数えているぶん、実質の独立性は8より小さい可能性がある。加えて本文に条件別の数値表が無いため、読者の側で差の大きさを検算できない。方向はきれいに揃っている——そこは私も信じてよいと読む——が、どれくらい効くのかは、この論文からは持ち帰れない。
Fukai の読み
私はこの研究を、生成 AI の話としてではなく、設計作業の自動化がどこまで来たかの目盛りとして読みたい。面そのものを自動で作る研究なら、少なくとも 20 年前から積み上がっている。この論文が自動化したのは、面を作る道具を整理する仕事——つまりリファクタリングの判断である。しかもその判断基準は「読みやすくなったか」ではなく「出力が変わらないか」という、人間なら怠けがちなところに置かれている。設計批評の語彙で言えば、これは創造性の自動化ではなく、職人が道具箱を片づける習慣の自動化に近い。派手ではないが、効くのはいつもそちらだ、と私は読む。
おわりに — 次に読むなら
強化学習で面を作る側の話と並べて読むと、地図が見えてくる。当サイトでは Earle ら: 複数のエージェントに面を作らせる と Bhaumik ら: 波動関数崩壊と強化学習を組み合わせる を扱っている。今日の論文は、その「作り手」をさらに一段上から探す話だ。
生成の対象そのものを一段ずらす、という発想に興味が向いたなら、Nasir ら: ゲームの「ルールそのもの」を進化させる が兄弟にあたる。面を探すのか、面を作る手続きを探すのか、遊びのルールを探すのか——探索の階層をどこに置くかという同じ問いの、別の答えだ。解ける面を確実に出すための工夫という点では Xu ら: 仕掛けを座標に格上げして解けるレベルを自動生成する も近い。
そして、機械が繰り返し発見した道具の名前をもう一度見てほしい。盤面の内側かどうか。置くものの数がそろっているか。プレイヤーはちょうど1人か。手でパズルを組んでいる人が、無意識に毎回確かめていることばかりだ。自動化の研究を読む面白さの半分は、こういう「言われてみれば自分もやっていた」の発見にある。
参考文献
本記事で参照した論文と関連資料:
・同論文の全文(本記事の数値・引用はこちらから確認した。投稿日 2026-08-18)
・著者所属: Matthew Siper / Julian Togelius = Game Innovation Lab, New York University、Ahmed Khalifa = Institute of Digital Games, University of Malta。arXiv のコメント欄に IEEE Conference on Games 2026 への採録が記載されている(2026-09-06 確認)。
・関連記事: Earle ら: レベル設計を複数エージェントの協働に組み替える / Bhaumik ら: WFC と強化学習を縫い合わせる / Nasir ら: ゲームのルールそのものを進化させる / Xu ら: 仕掛けを座標に格上げして解けるレベルを生成する
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
学ぶ — カリキュラム
関連シリーズ
論文ダイジェスト第78回 / 全89回