PAPER-DIGEST · 2026-09-07
Baek ら: 「ゼルダを7割、マリオを3割」の面を、文章で注文する — Fukai が読む
PCG / レベル・ブレンディング / 言語条件つき生成
一段落要約
「ゼルダを7割、スーパーマリオを3割」という注文で面を出す。そんな生成器の論文が今年3月に arXiv に出ていた。韓国の光州科学技術院(GIST)と東国大学校の5人による研究である。4本のゲームの面を同じ1つの置き場に収め、文章と比率で混ぜられるようにした。
混ぜ方は2通りある。1つは、2本の注文文をそれぞれ数値の列に直し、比率をつけて足し合わせる方法。もう1つは「Aをもとに、Bの要素を加えて」という1本の文を書く方法だ。前者は指定した比率どおりに動いた。後者はまだ効きが弱い。
1本ごとに専用の生成器を作る場合と比べると、共通化した生成器は全体の一致度が約4.4%落ちた。ただし4本のうちロードランナーだけは落ちていない。なお、この論文は査読前の preprint(投稿前原稿)である。先にそう断っておく。
はじめに — 誰が、どこに書いた論文か
今日読むのは Multiverse という論文である。著者は In-Chang Baek、Jiyun Jung、Geum-Hwan Hwang、Sung-Hyun Kim、Kyung-Joong Kim の5名。Baek 氏ら4名は光州科学技術院(GIST)、Jung 氏は東国大学校の所属だ。
arXiv:2603.26782 として2026年3月25日に投稿され、3月31日に改訂版が出ている。本文は8ページ、図5点、表4点。会議名の記載がないので、現時点では査読を通っていない preprint として扱う。
私がこれを選んだ理由は単純だ。パズルの面を作る仕組みは、たいてい1本のゲームの中で閉じている。「別のゲームの面と混ぜる」という発想を、言葉で操作できる形にまで持ってきた例は、まだ少ない。
背景 — 「文章から面へ」と「面と面を混ぜる」は別々に育ってきた
まず前提から。text-to-level(文章から面を作ること)は、ここ数年で実用的な入口になってきた。「左に階段、右に敵が2体」と書けば、その通りの配置が出てくる。設計者が数値を直接いじらずに済むのが利点だ。
ただし、これまでの研究の多くは1本のゲームの中だけで動いていた。マリオの生成器はマリオしか作れず、ゼルダの生成器はゼルダしか作れない。ゲームごとにタイルの種類も、その意味も違うからである。
一方で「レベル・ブレンディング」という別の系譜がある。2本のゲームの面を同じ潜在空間(latent space。面の特徴を数値の座標に落とし込んだ置き場)に入れ、その座標を混ぜて中間の面を作る研究だ。Sarkar らが VAE を使って示した仕事がよく知られている。
ただしこちらは、座標を直接いじる操作だった。「もう少しゼルダ寄りに」と言葉で頼むことはできない。著者らの狙いは、この2つの系譜を1つにまとめることである。
アプローチ — 違う言葉を共通の言葉に置き換えてから、正解の数を増やす
使った題材は4本。ゼルダ、Dungeon(PCGRL という研究用の題材集にあるダンジョン)、ロードランナー、スーパーマリオブラザーズである。前2つはダンジョン探索もの、後2つは横スクロールのアクションだ。ジャンルが2つに割れているのが、後で効いてくる。
面のデータは合計5,576枚。すべて16×16マスに揃え、34種類のタイルで表している。枚数を増やすため、横スクロール側は左右反転、ダンジョン側は回転と反転で水増ししている。
各面に付ける説明文は、人ではなく VLM(Vision-Language Model。画像を見て文章を書けるモデル)に書かせた。長さは平均11.2語、ばらつきは2.4語。「中央に塊のある四角い部屋、周囲は壁」といった短い文である。
ここからが工夫のひとつ目だ。ゲームごとに違う言葉を、共通の言葉に置き換える。コウモリもクリボーも「敵」に、はしごもつたも「登れるもの」にする。こうした言い換え規則を15個用意し、敵・地形・登れるもの・集めるもの・触れる仕掛け・危険物の6種類に寄せた。
工夫のふたつ目は、正解の数を増やしたことである。ふつうの対照学習(contrastive learning。正しい組み合わせを近づけ、それ以外を遠ざける学習のしかた)では、1枚の面に対して正解の文は1本しかない。著者らは、言い換えたあとの文どうしの近さが 0.3 を超えたら、別のゲームの面であっても正解として扱った。
面を実際に描き出すのは、条件つきの VQ-VAE と呼ばれる生成器だ。面の特徴を、あらかじめ用意した256種類の「部品番号」のどれかに置き換えて持ち、そこに文章の特徴を継ぎ足して復元する。混ぜるときは、2本の文の特徴を比率で足し合わせるか、2本ぶんを1文に書き下すかのどちらかを使う。
発見 — つまみは効く。ただし両端は効かない
まず、共通化の代価から。一致度(論文の ViTScore。生成した面と手本の面を画像として見比べ、どれだけ似ているかを −1 から 1 で表す)は、1本ごとの専用生成器でダンジョン0.794、ゼルダ0.767、スーパーマリオ0.623、ロードランナー0.792、全体0.744だった。共通の生成器では順に0.728、0.719、0.599、0.799、全体0.711。論文はこれを「全体でおよそ4.4%の緩やかな低下」と書いている。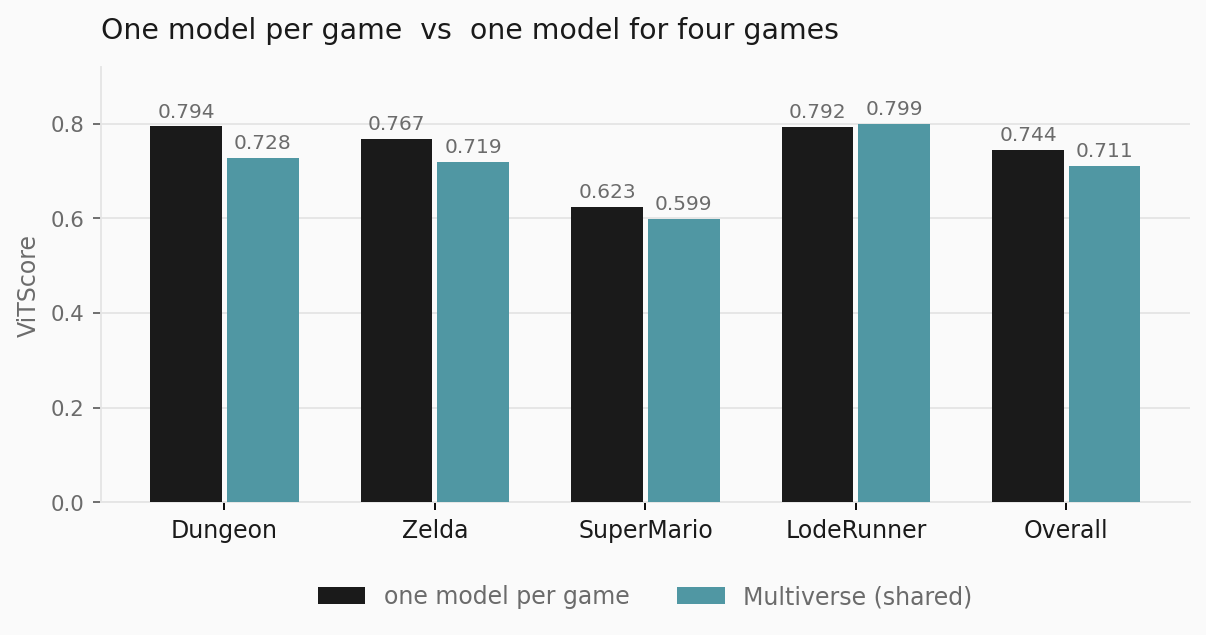 (図解)論文 Table I より。ロードランナーだけは共通生成器のほうがわずかに高い。
目を引くのはそのロードランナーだ。専用生成器 0.792 に対し、共通生成器は 0.799 とわずかに上回っている。他の3本が下がる中で、ここだけ下がっていない。著者はこの点を大きくは論じていないが、覚えておく価値はある。
次が本題の「つまみ」である。同じジャンル内での組み合わせで、Aの比率を 0%、25%、50%、75%、100% と動かすと、Aへの一致度は 0.392 → 0.379 → 0.501 → 0.645 → 0.671 と上がる。Bへの一致度は 0.664 → 0.650 → 0.493 → 0.394 → 0.371 と下がる。狙いどおり、入れ替わっている。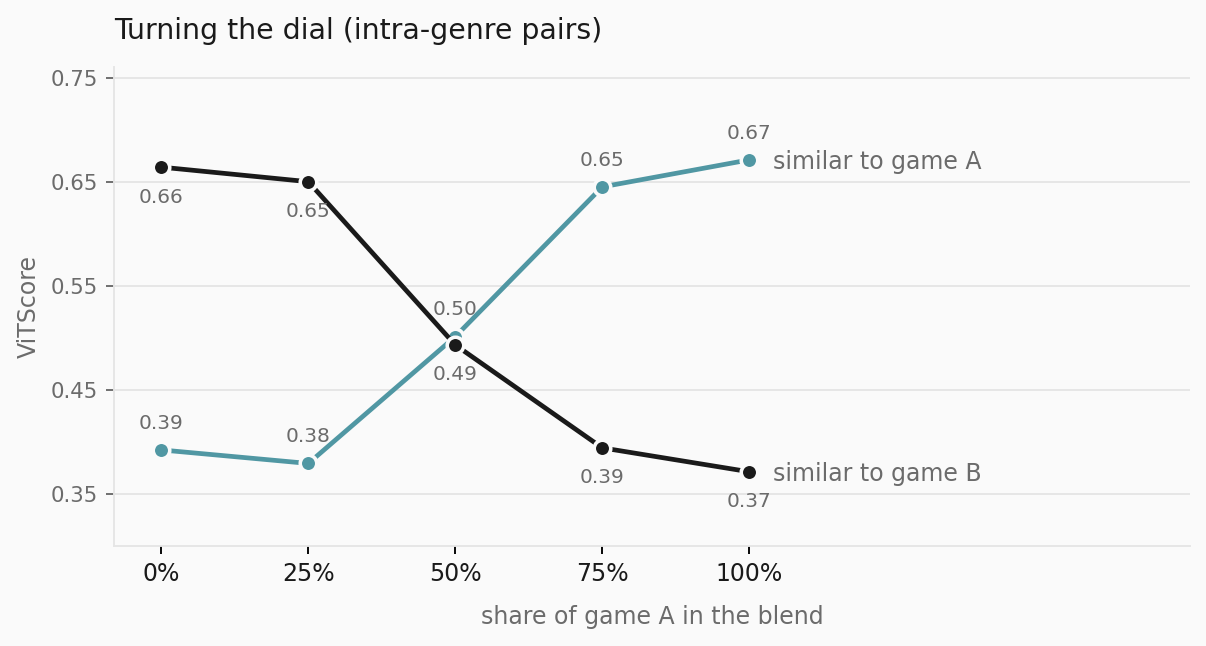 (図解)論文 Table II(同ジャンル内)より。2本の線は中央で交差する。
ただし、なめらかではない。0%から25%へ動かしても、値はほとんど変わらない。むしろ 0.392 から 0.379 へわずかに下がっている。動きが出るのは 25% から 75% のあいだだ。つまみの両端は、あまり仕事をしていない。
比率と一致度がどれだけ連動しているかは、相関という数値で測られている。全体では Multiverse が 0.527、比較用の従来型が 0.509。同じジャンル内に限ると 0.580 対 0.558 で、論文はここに有意差の印を付けている。差そのものは小さい、というのが正直な読み方だろう。
文章1本で混ぜる場合はどうか。2文をただ繋いだときは 48:52、1文に溶かし込んだときは 49:51 と、ほぼ半々になった。「Aをもとに、Bを加えて」と書くと 58:42、逆向きに書くと 37:63。書く順番が、そのまま混ざり具合として出ている。
使いどころ — 生成器を1つに畳む、発想を広げる、共通語彙を作る
使いどころを具体的に挙げてみる。1つ目は、複数のパズルを並行して運営している場合だ。日替わりパズルを何種類も抱えていると、生成器も種類のぶんだけ必要になる。この論文は「1つにまとめても全体で4.4%の低下で済む」という目安を与えてくれる。
しかもロードランナーは下がらなかった。データの少ない題材ほど、隣の題材から借りられる可能性がある。手持ちの面がまだ少ない新作パズルを作るなら、既存の題材といっしょに学習させてみる価値はある、と読める。
2つ目は、発想を広げる道具としての使い方である。比率を25%に置いて出てきた面を、そのまま出荷するのではなく「こういう組み合わせもあるのか」と眺める。設計者の隣に置く相談相手として使うのなら、一致度が0.5でも十分に役に立つ。
3つ目は、自分のゲームに「共通語彙」を用意することだ。著者らの言い換え表は、そのまま真似できる。コウモリもスライムも「敵」、はしごもつたも「登れるもの」。この6分類を自作のタイルに当てはめるだけで、言葉で面を注文する土台ができる。
4つ目は注意点として。もし比率のつまみをプレイヤーや設計者に見せるなら、両端付近はほとんど効かないことを覚えておきたい。0%と25%が同じ顔をして出てくると、つまみが壊れていると受け取られる。刻みを粗くするか、内側だけを見せるほうが誠実だろう。
限界 — 著者が認めている点と、私が気づいた点
限界を整理する。まず著者自身が認めている点。文章による混合の効きが弱い、と論文は書いている。理由も明記されていて、学習に使った説明文が「1本のゲームの中で閉じた文」ばかりで、混ぜ方そのものを学んでいないためだという。
ここから先が、Fukai がここで指摘する点である。1つは評価の物差しだ。ViTScore は、生成した面と手本の面を画像として見比べた似かたを測る。つまり「見た目が中間かどうか」しか見ていない。遊べるかどうか、クリアできるかどうかを測った数値は、この論文には出てこない。
もう1つは面の切り方だ。すべての面が16×16マスに揃えられている。スーパーマリオの面は、本来もっと横に長い。16×16に切り出した時点で、それは「面」ではなく「面の一部分」である。マリオの一致度が4本のうち最も低い(専用0.623 / 共通0.599)ことと、無関係ではないだろう。
3つ目は言葉の出どころである。説明文を書いたのは人間ではなく VLM だ。平均11.2語という短さも、機械が書いた文らしい長さに見える。「言葉で操作できる」と言うとき、いまのところその言葉は機械語に近い。人間の設計者が書く曖昧な指示で同じことができるかは、まだ分からない。
Fukai の読み
私はこの研究を、「面を作る技術」よりも「ゲーム同士に共通の物差しを引く技術」として読みたい。ゼルダのコウモリとマリオのクリボーを同じ「敵」の欄に入れる、という一見素朴な操作が、この論文の中心にある。出力された混成の面よりも、その手前にできた共通の置き場のほうが資産に見える。設計批評の語彙で言えば、これはジャンルという離散的な分類を、連続した座標に置き換える試みだと整理できる。ここだけは私の解釈であって、著者がそう書いているわけではない。
おわりに — あわせて読むと地図が見える3本
この論文だけでは地図が足りない、と感じたら、先行研究を勧めたい。1つは Sarkar らの「Controllable Level Blending between Games using Variational Autoencoders」である。潜在空間で面を混ぜるという発想の出発点にあたる。
もう1つは、同じ著者グループによる IPCGRL。言葉で指示を出しながら強化学習で面を作る研究で、今回の Multiverse はその延長線上にある。あわせて読むと、この研究室が何を積み上げてきたかが見えてくる。
そして、言語モデルに面そのものを書かせる系譜としては Todd らの「Level Generation Through Large Language Models」がある。同じ「言葉から面へ」でも、通る経路がまったく違うことが分かるはずだ。
参考文献
本記事で参照した論文と関連資料:
・In-Chang Baek — Google Scholar(第一著者の他の論文)
・関連研究: Level Generation Through Large Language Models (Graham Todd et al., 2023)
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第79回 / 全89回