PAPER-DIGEST · 2026-09-18
Guo ら: 人は10試合ほどで「目先の得」から離れたが、自己進化するAIは離れられなかった — Fukai が読む
繰り返し遊んで何が変わるか — 勝敗ではなく「手つき」を測る
要点 — 勝率は同じでも、手つきは違っていた
同じゲームを何度も遊ぶと、人は何が変わるのか。この論文が測ったのは勝率ではない。手の選び方そのものである。学生32人に3種類の対戦ゲームを計709試合遊ばせ、まったく同じ物差しで、自分で学習していくと謳うAIエージェント4種類も走らせた。
結果は対照的だった。人はおおむね、そのターンで一番得が大きい手から、先を見た手へと移っていった。ゲームごとの行動指標で見ると、12人中11人、11人中10人、9人中8人が終盤で改善している。AIのほうは短い区間では伸びるのに、それが続かなかった。
面白いのは、勝敗だけを見ていたらこの差は見えなかったという点だ。勝率は人もAIもほとんど0%付近に張り付いている。著者らはだから手つきを測る物差しを作った。なおこれは査読を通っていない preprint(公開原稿)である。そこは差し引いて読む。
誰が書いた、どんな原稿か
著者は Yingying Guo、Zhuoxuan Ju、Ruibo Ming、Ruicheng Feng、Jinjin Gu の5名。原稿には香港中文大学(深圳)、ジョージタウン大学、INSAIT(ソフィアの研究所)、テンセントの所属が記されている。
公開先は arXiv、識別子は arXiv:2608.07490。主分類は cs.HC(人とコンピュータの関わり)、副分類は cs.AI である。会議名やジャーナル名の記載はない。つまりこれは preprint(査読前の公開原稿)であり、peer-reviewed な論文ではない。数字の扱いは、その前提で読むことになる。
私がこれを今日選んだ理由は単純だ。大規模言語モデル(LLM。大量の文章で学習した、言葉を扱うAI)をゲームで評価する研究はもう山ほどある。だがそのほとんどが最後に勝ったか負けたかを見ている。パズルを作る側が本当に知りたいのは、遊んだ経験が次の一手をどう変えるかのほうだ。
そしてこの原稿は、その「どう変わったか」を記録から取り出す手順を具体的に書いている。測り方の提案は、そのまま設計の道具になる。AIが弱かったという話として読むのは、この原稿の半分しか読んでいないことになると私は思う。
なぜ「勝率では足りない」のか
ゲームがAIの試験場として好まれるのには理由がある。ルールが文章で書き切れる。手が順番に連なる。そして全部の手が記録として残る。三拍子そろっている題材は、実はそう多くない。
しかし著者らによれば、これまでの評価は「1回のプレイの中での賢さ」に偏ってきた。合法な手を選べるか。詰みを見つけられるか。1エピソード(1試合)の内側で完結する能力である。
測られてこなかったのが二つ目の能力だ。原稿の言い方を借りれば、繰り返しの相互作用が、状態の評価の仕方・手の選び方・経験の使い回し方を変えるかどうか。人間なら当たり前にやっていることが、評価の枠から漏れていた。
導入で挙がる例がオセロだ。「初心者はある盤面を見て、そのターンで一番多く石をひっくり返す手を好むかもしれない。ルールを素直に読めば、たくさん返すのが前進に見えるからだ」。だが強い打ち手は逆に、返す石を少なく抑えて次に打てる場所を残す。上達とは、この乗り換えのことである。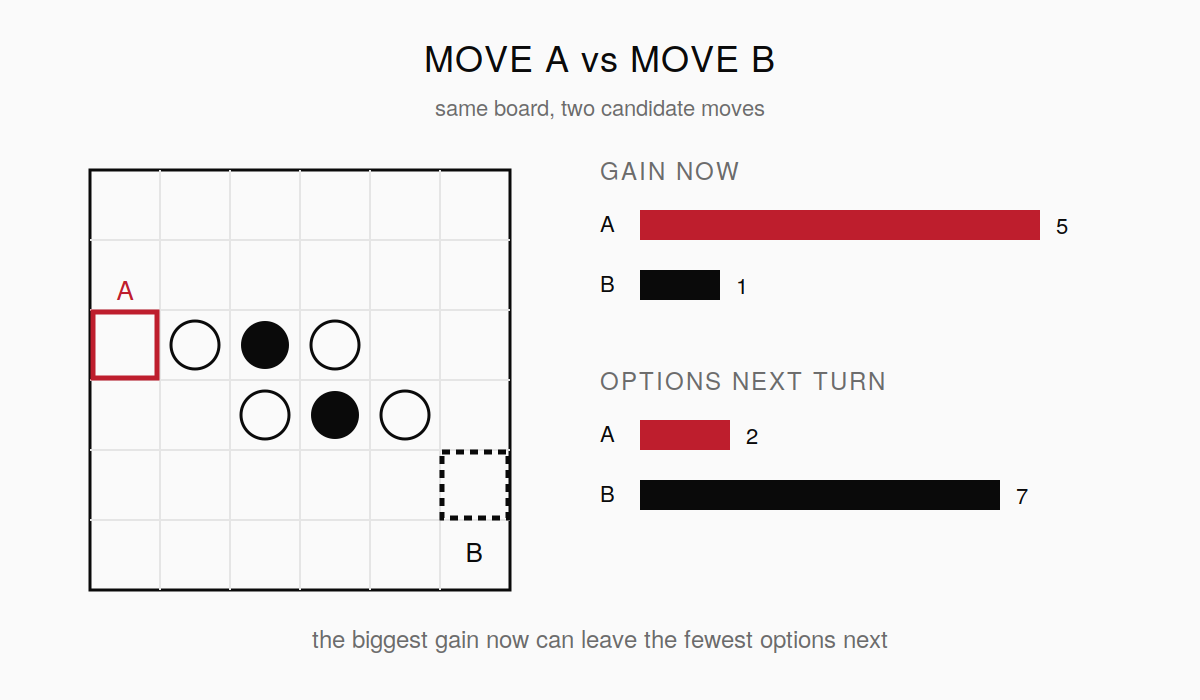 (図解・模式図)同じ盤面の2つの候補手。今の得が一番大きい手が、次のターンに残る選択肢を一番減らすことがある。数字は論文のデータではなく、考え方を示すための例。
3つのゲームと、2つの共通の物差し
使われたゲームは3つ。Four in a Row(いわゆる四目並べ)、Othello6(6×6の小さい盤のオセロ)、CircleCat(猫を囲む遊び)である。CircleCat のルールは原稿にこう書かれている。1手につき空いているマスに壁を1枚置く。猫は1歩動く。猫が外に出られなくなれば勝ち、端まで到達されれば負け。
全ゲーム共通の物差しが2つ作られた。1つ目が GVD(Greedy Value Difference、貪欲な基準手との差)。原稿の定義は「プレイヤーの手が、そのゲーム固有の貪欲な基準手より良いかどうかを測る」。ここでいう貪欲な手とは、目先の得だけを最大にする手のことだ。
2つ目が GTA(Greedy Trap Avoidance、貪欲な罠の回避)。こちらは「貪欲な基準手が、他の選択肢よりはっきり悪い局面だけに注目する」。目先の得に飛びついたら損をする場面だけを抜き出して、そこでどう打ったかを見るわけである。罠の前でだけ採点する、と言い換えてもいい。
これに加えて、ゲームごとの行動診断の指標が置かれた。Four in a Row には EAR・CPQ(重要局面での手の質)・OCI、Othello6 には MCI(動ける手の数の制御)と CPQ、CircleCat には EPD・EPC・CAR(囲い込みで減らせた面積)。名前は物々しいが、やっていることは「そのゲームで上手い人がやることを1つずつ数字にした」である。
人間側の集め方はこうだ。参加者は修士・博士の学生32人、集まった試合は計709。そのゲームを最近遊んでいないことが参加条件だった(すでに持っている定石が混ざるのを避けるため)。絞り込み後は Four in a Row が12人、Othello6 が11人、CircleCat が9人。各自11試合以上。分析では連続する試合を5試合ずつの束にまとめ、最初の3試合を Early、真ん中の5試合を Mid、最後の3試合を Final と呼んでいる。
AI側は、自分で学んで変わっていくと謳う4つの手法 — CEL、EvoTest、EvolveR、ReasoningBank — を、同じ記録と評価の手順で走らせた。1ゲームあたり128エピソードである。
人は動いた。AIは動いて、戻った
人間の側から見ていく。共通の物差し(GVD と GTA)は、中央値で見ると最初の2束のうちに改善していた。つまり10試合前後で、目先の得への飛びつきが減っている。
ゲームごとの指標のほうがはっきりしている。Othello6 の CPQ は11人中10人、CircleCat の CAR は9人中8人、Four in a Row の CPQ は12人中11人が、終盤で改善した。ほぼ全員である。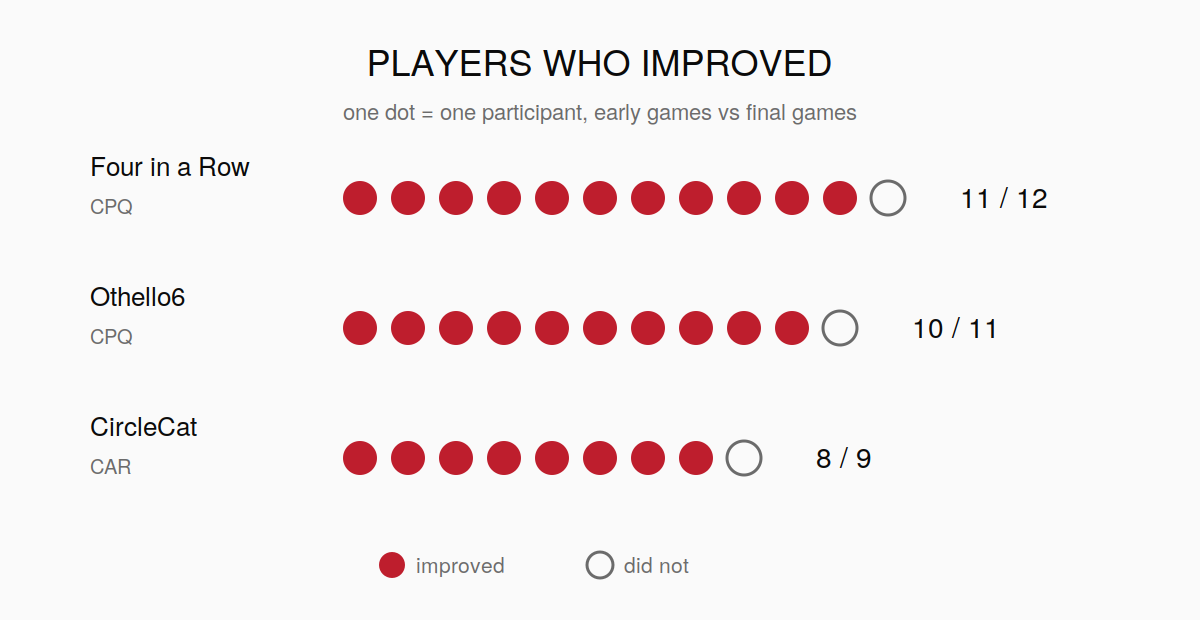 (図解)ゲームごとの行動指標で、終盤に改善した参加者の数。点1つが1人。数字は論文本文の記述による。
AI側について、著者らはこう書いている。「3つのゲームを通して、現在の自己進化型エージェントは、人間の軌跡に見られたような安定した行動の改善を示さない」。そして伸びが無いわけではない、とも書く。「個々の手法は短い区間では改善することがあるが、その伸びはしばしば不安定で、手法ごとにばらばらで、後のエピソードまで一貫して維持されない」。
ここで効いてくるのが勝率の表(Table 4)だ。人間の中央値は、Four in a Row が最初の10試合0.0%から最後の10試合10.0%、Othello6 は0.0%から0.0%、CircleCat は20.0%から20.0%。AI側は CEL・EvoTest・ReasoningBank が全ゲームで0.0%のまま、EvolveR だけが Four in a Row と CircleCat の最初の10で10.0%を出し、最後の10では0.0%に落ちている。勝敗だけを見ていたら、人もAIも「何も起きていない」ように見える。著者らも表の説明で、勝敗は弱く鈍い信号だと述べている。
もう1つ、私が持ち帰る価値があると思ったのが、失敗の内訳を4段に分けた表(Table 3)である。第1段は次の盤面を思い描けない(合法手や詰みを口では確認するのに、打った後の状態を安定して想像できない)。第2段は先の価値で手を比べられない(先が大事だと分かってはいるのに、候補手をその価値で比較できない)。
第3段は言葉にした戦略を実際の手の制約に落とせない(役に立つ原則は覚えているのに、手を選ぶ瞬間の縛りに変換できない)。第4段が経験を持続的な行動変化にできない。この4段は入れ子になっていて、下の段ができないと上の段には届かない、と著者らは整理している。原稿の結論部の一文が端的だ。「彼らの中心的な限界は、振り返りが無いことではなく、振り返りを信頼でき・検証でき・再利用できる意思決定行動の変化に変換できないことである」。
パズルを作る人は、ここから何を持ち帰れるか
1. 「貪欲な罠」を意図的に置き、そこだけで採点する。 GTA の考え方はそのまま設計に移せる。チュートリアルの次の面に、一番得に見える手が悪手になる局面を1つだけ仕込む。上達を測りたいなら、全局面を平均するより、この1局面での選択を見るほうが鋭い。私が作るなら、面の中に「罠マス」を明示的に持たせ、そこを通ったかどうかだけをログに残す。
2. テレメトリを「勝敗」から「手つき」へ移す。 記録するのは勝ったかどうかではなく、選ばれた手と、その局面での貪欲手との差である。デイリーパズルなら「最短手数の手」と「実際に打たれた手」の差でよい。既存のログに1列足すだけで済むことが多い。
3. 上達表示を作り直す。 連勝記録やクリア率は、この原稿の表4が示す通り鈍い。代わりに「罠を避けた率」を出す。プレイヤーに見せる数字としても、こちらのほうが具体的に上達を感じられるはずだ。ただし何を罠と呼ぶかを設計者が決める必要がある。そこが手間であり、同時に面白いところでもある。
4. 分析の単位を借りる。 5試合ずつの束、Early/Mid/Final という3区切り。参加者が9人でも学習の向きが見えたのだから、少人数のプレイテストにそのまま持ち込める。「10人に11回遊ばせる」は個人開発でも現実的な規模だ。
5. AIプレイテスターの使いどころを切り分ける。 この原稿を素直に読むなら、自己進化型のエージェントは「何度も遊んで上達していく人間」の代理としてはまだ使えないと読める。一方で、1回のプレイの中での合法手チェックや詰みの検出は別の能力である。自動プレイテストを入れるなら、この線で期待値を分けておくのが安全だ。
6. 被験者を集めるときの条件を真似る。 「そのゲームを最近遊んでいない」を参加条件にしたのは地味だが効いている。既にコツを知っている人が混ざると、学習曲線は最初から平らになる。新規プレイヤー向けの導入を検証したいなら、この一手間は省かないほうがいい。
何が分かっていないか
まず著者ら自身が認めている点から。環境が3つしかない。これは数より質を優先した意図的な選択だと書かれているが、3つのゲームで見えたことが他の題材でも成り立つ保証はない。特に3つとも対戦型の盤上ゲームであり、1人で解く純粋なパズルは含まれていない。
次に人間データのばらつきと費用。個人差を論じるにはもっと大きく多様なデータが要る、と著者らは書いている。そして強化学習エージェントとの比較はしていない。これは手順が変わるため意図的に範囲外に置いた、と明記されている。
ここから先は Fukai がここで指摘する点である。1つ目、試行回数がそろっていない。人間は最低11試合、AIは1ゲーム128エピソード。だからこの結果を「人のほうが速く学ぶ」とは読めない。比べられているのは速さではなく、伸びが続くかどうかである。
2つ目、参加者の偏り。32人はすべて修士・博士の学生で、絞り込むと各ゲーム9〜12人になる。抽象的な盤上ゲームを初見で分析的に扱う訓練を受けた層と言ってよい。「人は貪欲な手から離れる」ではなく「この条件の学生は、この3つのゲームで、11試合のうちに離れた」と読むのが正確だと私は思う。
3つ目、物差しが貪欲手の定義に依存している。GVD も GTA も「貪欲な基準手」との比較で定義される。基準の作り方が甘ければ、人もAIも実際より良く見える。この基準はゲームごとに人が決めるものなので、他の題材に持っていくときは、まずここを設計する仕事になる。
4つ目、勝率が軒並み0%である理由が切り分けられていない。著者らは勝敗を鈍い信号だと位置づけるが、鈍いのか、それとも対戦相手が単に強すぎたのか、この表だけでは決められない。もし後者なら、人間側の「安定した改善」も、負け続ける中での改善という限定つきの話になる。
Fukai の読み
私はこの原稿を、「上達を測る物差しを、結果から手つきへ移す」流れの中に置きたい。ゲームの評価は長いあいだ勝率とクリア率で語られてきたが、それは結果に現れるまで何も見えないという意味でもあった。ここで提案されているのは、結果が動く前に変化を捉える読み方である。設計批評の語彙で言えば、これはプレイテストの自動化ではなく、プレイテストで見るべき場所の再定義に近いと私は読む。そして面白いことに、この再定義の恩恵を先に受けるのはAIではなく、人間のプレイヤーを観察している私たちのほうだと思う。
次に何を読むと地図が見えるか
この原稿を面白いと思った人には、以前ここで読んだ Zhao らの「人はパズルを解きながら自分専用の部品を作る」 を並べて読むことを勧めたい。あちらは「繰り返しの中で何が蓄積されるか」を、こちらは「蓄積が手にどう出るか」を扱っている。裏表の関係にある。
初見のゲームで人がどこまで先を読んでいるかについては、Collins らの研究 が参考になる。目先の得と先読みの話を、実装に近い形で考えたいなら Into the Breach のように情報が全部見えている設計を触ってみるのが早い。見えているのに間違えるのだから、これは記憶の問題ではなく評価の問題だと分かる。
参考文献
本記事で参照した原稿と資料:
・同原稿の HTML 版(本文・Table 3・Table 4 の引用はここから)
・引用した数値の出どころ: 参加者数と試合数は実験設定の節、指標ごとの改善人数は結果の節、勝率は Table 4、失敗の4段は Table 3。
・この原稿には会議名・ジャーナル名・DOI の記載がない。したがって本記事では peer-reviewed な論文として扱っていない。
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第89回 / 全89回