PAPER-DIGEST · 2026-09-17
Li ら: 頼んでいないのに助けに来るAIは、10人中5人に閉じられた — Fukai が読む
ゲーム内AI支援 — 拒まれたのは助言の中身ではなく、渡し方だった
要点 — 断られたのは中身ではなく、渡し方だった
「ゲームの中でAIが助けてくれる」。便利そうに聞こえる。ところが実際に10人に遊んでもらったところ、少なくとも5人がその窓を最小化するか、途中で開くのをやめた。
今日読むのは、パズルゲームに組み込んだAI助言システム「PEARL」の評価論文である。IEEE Conference on Games (CoG) 2026 に採録された査読済みの論文だ。珍しいのは、作った本人たちが「これはうまくいかなかった」と正面から書いている点にある。
そして拒まれたのは、助言の中身ではなかった。同じ説明でも、プレイヤーが自分から聞きに行ったときには役に立ったと言われている。嫌われたのは「頼んでいないのに出てくる」という渡し方のほうだった。著者らは自分たちの設計を「私たちはClippyを作っていないか」と問い直している。
誰が書いた、どんな論文か
著者は Jiahong Li、Sai Siddartha Maram、Atieh Kashani、Ulia Zaman、Zhiyu Lin、Cameron Marano、Roger Azevedo、Jichen Zhu、Magy Seif El-Nasr の9名。arXiv には 2026年9月12日に投稿されている(arXiv:2609.13718)。
重要なのは、これが arXiv だけにある原稿ではない点だ。投稿されているのは「著者最終稿」で、IEEE Conference on Games (CoG) 2026 に採録済みと明記されている。つまり査読を通っている。本文8ページ、図3点、表1点。分野は cs.HC(人とコンピュータの関わり)が主で、cs.AI が従。
システムの名前は PEARL(Parallel Education Agent for Reflection and Learning)。仕組みとしては RAG(Retrieval-Augmented Generation、検索で外から資料を引いてきて、それを材料に文章を生成させる方式)である。素の言語モデルに「ゲームの中の事実」を持たせるための作りだ。
私がこの論文を今日選んだのは、うまくいかなかった記録だからだ。成功報告は「同じものを作れ」としか教えてくれない。失敗の記録は「どこで転ぶか」を教えてくれる。ヒント機能を持つパズルを作る人にとって、後者のほうがはるかに役に立つ。
『Parallel』というゲームと、すでにあった支援機能
Parallel は、並行プログラミング(複数の処理を同時に走らせる書き方)を学ぶためのパズルゲームだ。画面上では処理が矢印として動き回る。プレイヤーは信号とセマフォ(semaphore、同じ場所に同時に入れる数を制限する仕組み)を置き、線でつないで交通整理をする。
研究に使われたのは2つの面だ。レベル3は8区画の盤面で、同期の基本を教える。レベル13は16区画で、信号とセマフォの両方を使いながら複数の処理を噛み合わせる必要がある。
このゲームにはすでに「Community」という支援機能がついていた。これは OPM(Open Player Model、プレイヤーの記録を本人に開いて見せる仕組み)の可視化だ。他の人がどこで何をしたかを重ねたヒートマップ、解法を点と線でつないだグラフ、面ごとの成績の集計が見られる。
ただし、見えることと分かることは別である。先行研究では、可視化を出しても「学習者は結局それを自分で解釈しなければならず、それ自体が軽くない認知作業だ」と指摘されていた。約50回のプレイ観察でも、振り返りのない試行錯誤、失敗の原因を診断できないこと、同じ方針から離れられないことが繰り返し見つかっている。
そこに言語モデルを足したくなるのは自然だ。しかし素の言語モデルは、他の人のプレイ記録も、専門家がつけた「この手は良い/悪い」の注釈も持っていない。しかも論理パズルでは、線が1本違うだけで正解と行き詰まりが分かれる。ふわっとした意味の近さだけで探すと、その1本を取り違える。
PEARL の仕組みと、確かめ方
PEARL の検索は二本立てになっている。言葉の意味で探す部分と、盤面の形で探す部分だ。両方を使うのは、前述のとおり「意味の近さ」だけでは論理パズルに足りないからである。
意味のほうは、専門家が注釈した知識グラフを引く。研究に使った2つの面について133個の知識単位が用意され、それらを結ぶ391本の推奨の矢印が張られている。各単位には、その手が良いか悪いか、何の概念を表しているか、よくある誤解は何か、代わりに何を置くとよいかが書いてある。プレイヤーが正しい手を打ったときは別の良い手を4件、間違えたときは似た間違いを3件返す。
形のほうは、盤面をそのままグラフとして扱う。区画を点、プレイヤーが引いた同期の線を辺とみなし、隣接行列を0と1の並びに潰す。レベル3(8区画)なら64桁、レベル13(16区画)なら256桁の並びになる。あとは他の人の盤面と何か所違うかを数えるだけだ(論文はこれをハミング距離と呼んでいる)。
ここに2つのモードがある。「自分は合っているか」を知りたいときは、違いが最も少ない盤面を出して今の方針を後押しする。「どこが違うのか」を知りたいときは、そこまではよく似ているのに、肝心の一手で分かれて正解に辿り着いた盤面を出す。出すのは最大5件。
2つはつながっている。まず意味の検索が「次はこういう手がいい」を返し、その手を含む盤面だけが形の検索の対象になる。良くできた設計だと思う。
問題は既定値だった。PEARL は既定で proactive(プレイヤーが頼まなくても自分から出てくる)に設定されていた。しかも線を1本つなぐたびに発火する。同じセッション内で同じ内容を繰り返さない仕組みはあるが、時間の間隔制限も手数の制限もない。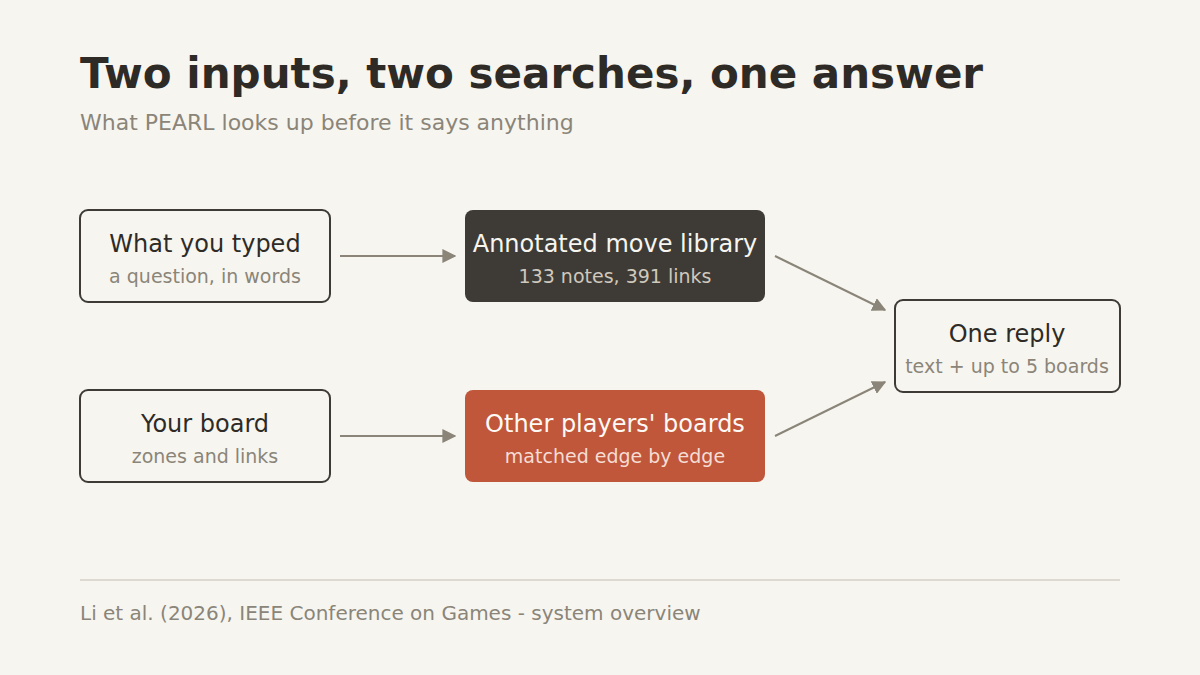 (図解)PEARL の二本立ての検索。入力は「打った手・書いた質問」と「今の盤面の形」の2つで、専門家の注釈と他人の盤面を引いてから1つの返答にまとめる。
参加者は10人。全員がコンピュータサイエンスの学部卒以上という背景を持つ。一人が両方の支援を体験する設計で、順番は入れ替えてある。半数はレベル3を Community で、レベル13を PEARL で。残り半数はその逆だ。各セッションは20分で、事前に道具の使い方を説明している。
測ったものは多い。TAM(技術受容モデル、その道具を有用だと思うか・使いやすいと思うかを尋ねる定番の尺度)、NASA-TLX(作業の負荷を測る定番の尺度)、PENS(ゲームがプレイヤーの欲求をどれだけ満たしたかを測る尺度)、そして並行プログラミングの知識を問う8問のテスト。加えて、遊んでいる最中に考えていることを声に出してもらい(think-aloud)、終了後に半構造化インタビューを行った。
分析はコードブック方式の主題分析である。研究の問いから14個のコードを先に決め、2人の研究者がまず同じ書き起こし1本(14区分)を別々に付けた。一致率は92.9%、Cohen の κ(カッパ、偶然の一致を差し引いた一致の指標)は.92。そこでコードブックを凍結し、残りを分担して付けている。手続きとしては丁寧だ。
何が起きたか
数字から見よう。TAM の「有用だと思うか」は7段階で Community が 4.98、PEARL が 4.57。「使いやすいか」は 5.02 対 4.75。どちらも既存の可視化のほうが上だった。
NASA-TLX の全体の負荷は 46.9 対 49.1 で、ほとんど変わらない。ところがフラストレーションの項目だけは 43.2 対 56.5 と大きく開いた。「疲れた」のではなく「いらいらした」のである。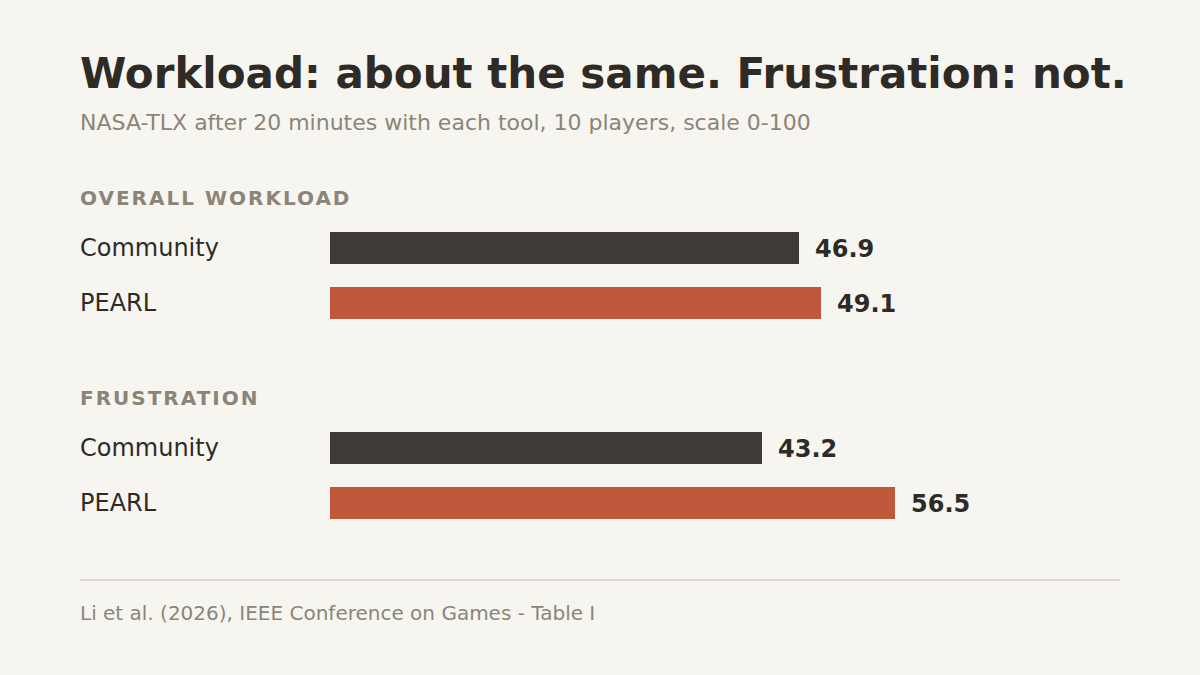 (図解)NASA-TLX の比較。全体の負荷はほぼ同じなのに、フラストレーションだけが13ポイント開いた。
行動はもっとはっきりしていた。少なくとも10人中5人が、遊んでいる途中でAIの窓を最小化するか、使うのをやめた。論文はこれを、押しつけがましい通知、一般論に終始する返答、そして信用のなさの3つが招いたと整理している。
とはいえ全否定ではない。10人中4人(P4、P6、P7、P10)は、2つの道具が別々の役割を持つと受け止めていた。P10 は「Community は全員に同じものが出る。AI のほうは今この瞬間の自分の配置に基づいている」と語っている。P6 は「今の解法の状態をもう知っているから、こちらから説明しなくていい」。
意味の検索が当たったときは「名前をつける」働きをしていた。P4 は、自分が勘で置いていた仕組みがミューテックス(排他制御)の話だと分かった瞬間を挙げている。一方で3人にとっては同じ台本の繰り返しに見えた。P8 が受け取った返答は「面白い選択をしましたね……よく考えてみてください」という調子で、何をすればよいのかが無かった。
他人の盤面については、結果が割れている。7人が「自分だけが詰まっているのではない」と安心したと答えた。5人は他人の盤面から自分と違う筋を見つけた。P10 はそれを、解いた後に他人のコードを眺める感覚に喩えている。一方で4人は「概念としては合っているのに、対応が分かりにくい」と言い、P3 に至っては励みどころか落ち込む材料だと述べている。
そして最も一貫していたのが割り込みへの不快感だ。10人中4人(P2、P3、P7、P10)が、頼んでいないのに出てくることを明確な不満として挙げた。P3 は「盤面に部品を置いている最中に割り込んで助言してくる」のが不快だと言い、P10 は「聞く前に答えを言ってくる」と表現した。PEARL を全体としては評価していた P7 でさえ「更新し終わっていないのに、更新するたびに反応してくる」と不満を述べている。
著者らの整理が鋭い。「反対されたのは助言の内容ではまずなかった。同じ参加者の何人かは、自分から求めたときには同じ説明を評価している。拒まれたのは、頼んでいない渡し方のほうだった」。
なお、8問の知識テストの平均は 5.50 問(68.8%、SD 0.94、幅は 4.0〜7.0)だった。「セマフォ」と「クリティカルセクション」の定義は10人全員が正解し、最も低い問題は10人中4人だった。ただし著者らは、この点数はセッション後の全体的な理解であって、どちらの道具が効いたかには帰属できないと明記している。
パズルを作る人は、ここから何を持ち帰れるか
1. 既定を「黙って待つ」にする。 もし自分が倉庫番系のパズルを作っていて、AIの助言を入れたくなったとしよう。この論文が示した失敗は、線を1本つなぐたびに発火し、間隔の制限も手数の制限も無かったことだった。逆をやればよい。普段は何も言わず、詰まったときにボタンを控えめに光らせるだけにする。押すかどうかはプレイヤーが決める。
2. 粒度を選ばせる。 P7 の言葉がそのまま設計書になる。「全然届いていないときは、全部説明してほしい。でも今日は惜しかったから、ひと言のヒントでよかった」。ヒント・方針・答えの3段を用意し、どれを開くかを毎回選ばせる。同じプレイヤーでも、日によって欲しい段が違う。
3. 他人の盤面を出すなら「分かれ目」を出す。 ただ似ている盤面を並べても効かない。PEARL の correction mode の考え方が使える。そこまでは自分と同じで、ある一手だけが違い、そこから正解に届いた記録を出す。デイリーパズルなら、同じ日の同じ手数まで一致した他の人の履歴を1件だけ出す、という形にできる。
4. 「自分だけじゃない」を見せる。 10人中7人が、他人も詰まっていると知って安心したと答えている。これは助言ですらない。今日の面で何手目に何人が間違えたか、という分布を出すだけで効く。ただし P3 のように落ち込む人もいるので、表示するかどうかは選べるようにする。
5. 汎用の言語モデルを貼るだけでは足りない。 PEARL が「なぜこの手が悪いのか」を言えたのは、専門家が133件の注釈と391本の矢印を用意していたからだ。裏を返せば、注釈が薄い領域ではそのまま一般論しか言わないAIになる。実際、10人中3人がそう受け取った。素のモデルを繋いで終わりにしない。
6. 助けを求める引き金を先に調べる。 参加者の多くは「何度も失敗してから」ようやく道具を開いていた。閾値は人によってまるで違う。P8 は「一貫して壁にぶつかる」まで何も開かず、P6 は好奇心だけで開き、P2 は時間切れが近づくまで意地で開かなかった。誰に向けて設計するのかを先に決める必要がある。
何が分かっていないか
著者たちは限界をはっきり書いている。まず参加者が10人で、全員がコンピュータサイエンスの学位を持っている。初心者や、技術以外の分野にそのまま広げることはできない。
次に、一人が両方を試す設計のため、順序と難易度の影響が残る。順番を入れ替えてはいるが、消えてはいない。
そして最も重要な限界がこれだ。PEARL と Community の比較は、検索の仕組みの差を取り出せない。2つは出し方も、出るタイミングも、画面も、やりとりの仕方も全部違う。著者らは「これは2つの対照的な支援の型を比べたのであって、検索の設計を比べたのではない」と明記している。
検索の品質の問題も、一部は知識グラフの抜けかもしれない、と著者は認めている。意味検索だけ・構造検索だけ・両方、を専門家の正解と突き合わせる比較は、今後の課題として残されている。
Fukai がここで指摘するのは、次の3点だ。第一に、20分は短い。初めて触る道具の割り込みは、いちばん目立つ場面で評価されている。1週間使ったら慣れるのか、それとももっと嫌になるのかは、この論文では分からない。
第二に、この研究は「学びに効いたか」には答えていない。知識テストの平均5.50問は条件別に切り分けられないと著者自身が書いている。答えが出ているのは「使ってもらえたか」までである。ここを混同して「AI支援は学習に効かない」と読むのは行き過ぎだ。
第三に、比較相手の Community は、このコミュニティですでに使われてきた道具である。慣れの差が Community に有利に働いた可能性は、私が読んだ限り限界の節に明示されていない。もっとも、それでも「割り込みが嫌われた」という中心の発見は、慣れでは説明しにくい。
Fukai の読み
私はこの研究を、論点が「AIが何を言うか」から「AIがいつ口を開くか」へ移った印として読みたい。検索の作り込みは相当なものだ。133件の注釈、391本の矢印、256桁の盤面照合。それを台無しにしたのは、たった一つの既定値だった。線を1本つなぐたびに発火する、という設定である。設計批評の語彙で言えば、これはヒント機能の自動化の話ではなく、「ヒントを求める」という行為そのものを設計する話だと整理できる。求めていない助けは、正しくても助けにならない。
次に何を読むと地図が見えるか
論文をもう少し辿りたい人へ。パズルのソルバーを一手ごとの先生に変える話は Wang らの研究が扱っている。ヒントに値段をつけると人がどれだけ買うかは McCaughey らの研究、プレイヤーが解きながら自分専用の部品を育てていく過程は Zhao らの研究が詳しい。この3本と今日の論文を並べると、「教える側の設計」の地図がだいたい描ける。
遊んで確かめたい人へ。並行処理をそのままパズルにした 7 Billion Humans と Human Resource Machine は、今日の Parallel といちばん近い場所にある。他人の解法の分布をグラフで見せる SpaceChem は Community 側の考え方そのものだ。そして The Witness は、ヒントを一切出さないという選択を最後まで貫いている。この3つを並べて遊ぶと、今日の論文が扱った軸が体で分かる。
参考文献
本記事で参照した論文と関連資料:
・著者最終稿。2026 IEEE Conference on Games (CoG) に採録済み(査読あり)。本文8ページ、図3点、表1点
・本文で触れた関連記事: Wang ら: パズルのソルバーを一手ごとの先生にする / McCaughey ら: 人がヒントを買う量を変えるのは「値段が変わった」と聞いた瞬間だけ / Zhao ら: 人はパズルを解きながら「自分専用の部品」を作る
・本文で触れたゲーム: 7 Billion Humans / Human Resource Machine / SpaceChem / The Witness
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第87回 / 全89回