TAG
#player-experience
0 レビュー · 12 エッセイ
関連エッセイ
Guo ら: 人は10試合ほどで「目先の得」から離れたが、自己進化するAIは離れられなかった — Fukai が読む
Yingying Guo ら5名による preprint(arXiv:2608.07490、査読前)。同じゲームを繰り返し遊んだとき、人とAIの「手の選び方」がどう変わるかを測る枠組みを提案した。学生32人に3種類の対戦ゲームを計709試合遊ばせ、同じ物差しで自己進化型のAIエージェント4種類も走らせている。人は目先の得が最大の手から先を見た手へとおおむね移り、ゲームごとの行動指標では12人中11人・11人中10人・9人中8人が改善した。一方AIの改善は短く途切れがちだった。著者らは「中心的な限界は振り返りが無いことではなく、振り返りを再利用できる行動の変化に変換できないことだ」と書いている。
Li ら: 頼んでいないのに助けに来るAIは、10人中5人に閉じられた — Fukai が読む
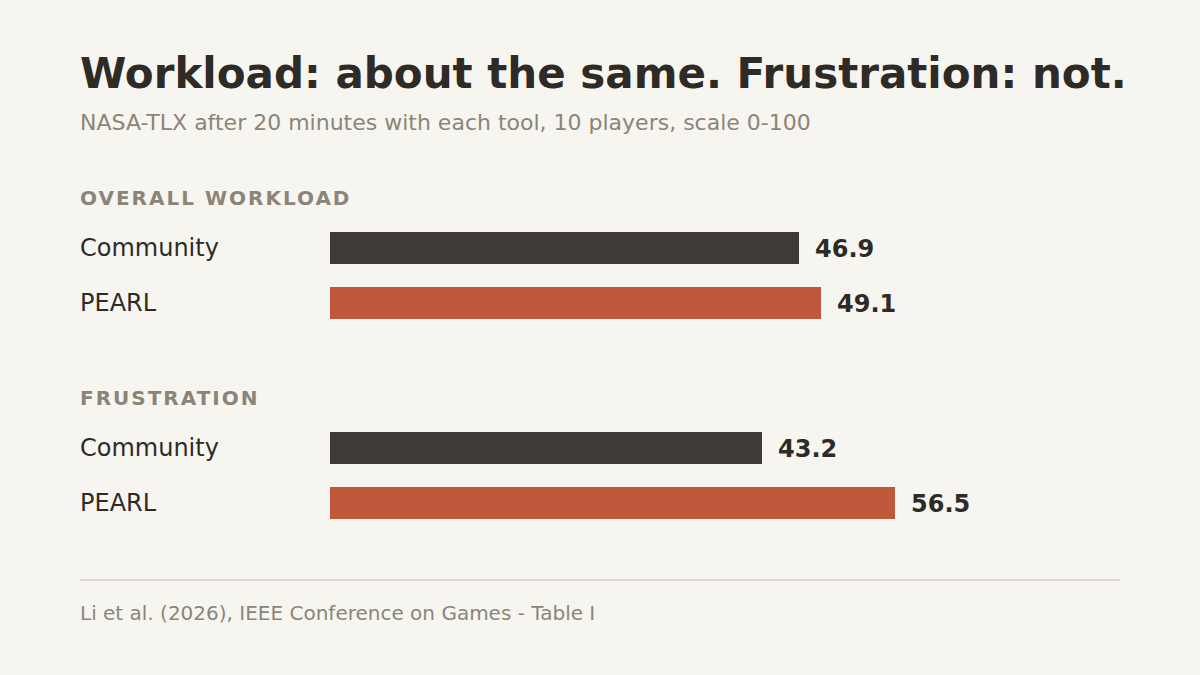
Jiahong Li ら9名による査読済み論文(IEEE Conference on Games 2026 採録、arXiv:2609.13718)。並行プログラミングを学ぶパズルゲーム Parallel に、専門家注釈と他プレイヤーの盤面を検索するAI助言システム PEARL を組み込み、10人で評価した。既存の可視化ツールのほうが有用と評価され、少なくとも5人がAIを最小化または放棄。フラストレーション得点は43.2対56.5と開いた。著者らは「拒まれたのは助言の中身ではなく、頼んでいないのに出てくる渡し方だった」と結論し、自らの設計を『Clippyを作っていないか』と問い直している。
「間違えることは罰ではない」——パズル開発者20人が語る、"失敗"の作り直し方
今日は1本。米ユタ大学の Craig G. Anderson と、ミネソタ大学の Nasim Eshgarf・Zack Carpenter・David DeLiema による論文「Designed to Fail: Puzzle Game Developers' Perspectives on Designing Challenge and Failure」(FDG 2026会議録)を読んだ。パズルゲーム開発者20人への半構造化インタビューから、開発者たちが「失敗」を不正解や操作ミスではなく「プレイヤーが完全に興味を失うこと」として捉え直し、それをむしろ設計側の失敗と考えていることを示した研究だ。試行錯誤や誤答は、罰ではなく実験と解答への気づきを促す意図的な学習装置として位置づけられているという。ACMのダウンロードページは私の手元では開けなかった(403)ため、著者ら自身が公開しているアブストラクト全文を複数の学術データベース経由で照合し、その範囲で要約している。
Hu et al.: 人は他人の満足を「選択肢の数」抜きで見積もる — Fukai が読む
Beidi Hu、Alice Moon、Eric VanEpps による Psychological Science 掲載の査読済み論文(2026年1月)。事前登録済みの実験6本・参加者10,092人で、人は自分の満足には選択肢の数を反映させるのに、他人の満足を予想するときはほとんど反映させないことを示した。選択肢の数を並べて見せる、順位で答えさせる、数を言い直させる——この3つで見落としは小さくなる。プレイテストと選択率の読み方に直結する話である。
Pfau & Vrettis: プレイヤーに自分だけのポケモンカードを作らせたら — Fukai が読む
Johannes Pfau と Panagiotis Vrettis(ユトレヒト大学)による arXiv preprint(査読前)。プレイヤーが名前と設定を書くと、検索・文章モデル・画像モデルを通して約20秒でポケモン風のカードが1枚できる仕組みを作り、学生49人に196枚を作らせた。見た目の満足度は5点中4.25、技や数値の適合は4.04。そして93.5%が「これは自分の発想だ」と答えた。ただし生成カードはまだ一度も対戦に投入されておらず、バランスは未検証である。
Lu et al.: フローを生むのは「難しさ」か「注ぎ込んだ努力」か — Fukai が読む
Hairong Lu らによるフローと心的努力の査読論文(Psychological Research, 2025)。視覚弁別課題で「難しさ」と「解けそうだという見込み」を別々に操作したところ、難しさの操作は強く効いた(ηp²=0.64)一方、期待の操作は試行単位でのみ弱く効き(d=0.04)、フローの逆U字は p=0.053 と境界、P300 はフローと無関係だった。N=37 の探索的研究である。
Teo et al.: AI は「助けすぎる」——問題解決中の介入を測る Int-Bench — Fukai が読む
Teo らによる LLM の介入行動の論文。AI アシスタントが問題解決中に「いつ・どれだけ助けるか」を Int-Bench という模擬環境で測り、AI は人間より早く頻繁に介入して答えを漏らしやすく、応用力を伸ばさないと報告。パズルのヒント設計に効く一本。
Hsu et al.: LLM がしゃべる NPC は、プレイヤーの頭を重くする——「諸刃の剣」の実験 — Fukai が読む
Hsu ら(中国伝媒大学ほか)による LLM NPC の実証論文。同じゲームの「台本 NPC」版と「GPT-4.1 の LLM NPC」版を作り、130人の被験者間比較で検証。LLM NPC は認知負荷を有意に増やし(p<.001)、全体の面白さは有意に改善せず(p=.195)、自律感は上がるが使いやすさと信頼は下がる、と報告する。
Johnson ら: 大規模言語モデルを組み込むとゲームはどう変わるか — Fukai が読む
カルガリー大学の Johnson らによる、LLM をゲームの構造に組み込んだ二本のゲーム開発の質的研究。LLM を「飾り」でなく「部品」として埋め込むとゲームプレイ・遊びやすさ・プレイヤー体験がどう変わるかを、開発者の内省から分析。変化と個人化が増える一方、正しさ・難易度較正・一貫性という新たな負担が生まれ、スキーマ強制と検証が鍵になると報告する。
Shyne et al.: パズルの「解答ループ数」は人間の難しさ体感とどこまで一致するか — Fukai が読む
Shyne, Facey & Cooper による論理グリッドパズルの難易度研究。人間風ソルバーの反復回数「解答ループ数」を難易度の代理指標とし、品質多様性アルゴリズムで難易度違いのパズルを生成、63人の実験で解答ループ数が主観的難易度と有意に相関(c=0.30, p=0.015)することを示した。
Bazzaz et al.: 「AI 製だと思う」だけで体験が変わる — Fukai が読む
Bazzaz と Cooper による、生成コンテンツの知覚バイアスを扱う CHI '26 論文。Super Mario Bros. と Sokoban で人間作・AI 生成レベルを混ぜて 142 人に遊ばせ、プレイヤーは作者をほぼ当てられないのに、AI 製だと信じたレベルほど楽しくない・難しい・苛立たしいと評価した、と報告する。
Sun et al.: なぜ人は理不尽に難しいゲームに没頭するのか — Fukai が読む
Sun らによる Soulslike ゲームの難易度設計に関する論文。なぜプレイヤーが理不尽に難しいゲームに没頭するのかを、600 件の Steam レビューの質的分析で探り、挫折に意味づけを与えることで没入が保たれる「レジリエント・フロー」という概念を提案する。