PAPER-DIGEST · 2026-09-14
Dygert & Jarosz: 文の読み違いを直せる人は、ひらめき問題も解けていた — Fukai が読む
認知心理学 — 問題解決と文章理解に共通する「再構築」
一段落要約
文を読み違えたあとで自力で読み直せる人は、ひらめき系のパズルもよく解けていた。査読誌 Journal of Intelligence に 2026 年 7 月 1 日付で載った論文の結論である。読み直しとひらめきは、同じ土台の上で起きているらしい。
実験は 2 本。学部生 85 人と 97 人が参加した。作業記憶の大きさや、図形の類推で測る知能を統計的に差し引いても、関係は残った。一方、手順どおり計算するだけの問題の成績とは、まったく結び付かなかった。
数字で言うと、実験 I の偏相関は r = 0.33(p = .002)、共有する分散は 11% ほど。実験 II では、曖昧な文を読み解く力がアナグラムの成績に 5〜9% の説明力を足した。ただし小さな標本で、事前登録もされていない。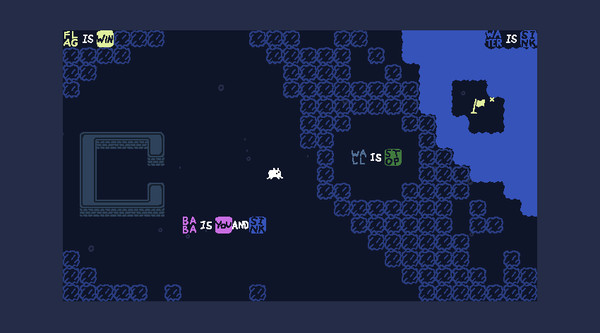 『Baba Is You』(Hempuli Oy, 2019)。盤面に並んだ単語そのものがルールで、押して並べ替えると意味が変わる。画像: Steam ストアページ
誰が、どこに書いた論文か?
著者は Sarah K. C. Dygert と Andrew F. Jarosz。どちらもミシシッピ州立大学の心理学部に所属している。掲載先は Journal of Intelligence の第 14 巻 7 号、論文番号 128 で、公開日は 2026 年 7 月 1 日である。
ここは大事なので先に書いておく。これは arXiv に置かれただけの preprint(査読前の原稿)ではなく、査読を通ったオープンアクセス論文である。著者が付けたキーワードは creativity(創造性)、problem-solving(問題解決)、ambiguity(曖昧さ)、comprehension(文章理解)の 4 つだ。
私が今日この 1 本を選んだ理由は単純だ。パズルを作る人は毎日「アハ体験」を設計しようとしている。その正体を、まったく別の作業、つまり文章の読み直しと同じ引き出しから説明しようとする論文だからである。なお 2026-09 時点で被引用はほとんど付いておらず、まだ広く議論されていない段階だ。
ひらめきの正体とされてきた「再構築」とは何か?
再構築(restructuring。行き詰まったときに、問題の捉え方そのものを作り直すこと)は、ひらめき研究の中心にある考え方だ。論文はこう書いている。「再構築が解へ導き、そこで『洞察』が起きる。解が、前触れなく突然現れるのだ」。
もうひとつの主役が「袋小路文」(garden path sentence)である。論文の定義では、構造や意味の上で一時的に曖昧な部分が「最初は誤って解釈される」文のことだ。読み進めた先で矛盾が出て、読者はそこで前に戻って読み直すことになる。
英語の教科書に必ず出る例を私の補足として挙げておく。The horse raced past the barn fell. 多くの読者は raced を動詞として読み、最後の fell で行き詰まる。正しくは「納屋の前を走らされた馬が倒れた」で、raced は馬を修飾していた。日本語話者には「黒い目の大きな女の子」の読み方が割れる感覚が近い。
この 2 つは長いあいだ別の分野で研究されてきた。ただし妙な共通点がある。どちらも、作業記憶容量(一度に頭に置いておける情報の量)との結び付きが弱いと報告されてきたのだ。著者はそこに目を付け、両者が同じ処理を共有しているのではないかと考えた。
どうやって「同じ処理か」を確かめたのか?
実験 I には、ミシシッピ州立大学で一般心理学を受講する学部生 85 人(男性 25 人、女性 60 人)が参加した。全員が英語の母語話者で、課題はおよそ 1 時間である。
言語側の課題は 50 文。そのうち 12 文が袋小路文で、残り 38 文は曖昧さのない正しい文だった。読んだあとに真偽を判断させ、正しく読み解けたかを測る。ひらめき側は 2 つで、アナグラム(文字を並べ替えて単語を作る問題)が 29 問、レビュス(絵と文字の配置で言い回しを表す問題)が 24 問。どちらも 1 問 30 秒である。
設計の肝は引き算にある。曖昧でない文をどれだけ正しく読めるか、という「ふつうの読解力」を統計的に取り除いたうえで、袋小路文の成績とひらめき課題の成績を突き合わせた。読解力が高いから両方できる、という当たり前の説明を先に潰しておくためだ。
実験 II は別の 97 人(男性 32 人、女性 65 人)で行われた。実験 I の参加者は含まれていない。ここでは作業記憶を対称性スパン課題で、流動性知能(初めて見る問題を筋道立てて解く力)を図形類推 25 問で測っている。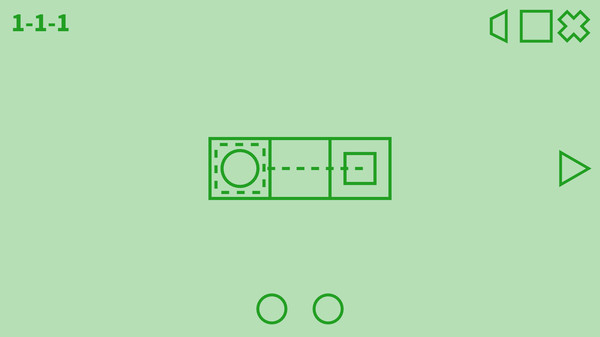 『Understand』(Artless Games, 2020)。ルールは説明されず、線を引いて反応を見ながら当てていく。画像: Steam ストアページ
そして問題を 2 種類に分けた。創造型はアナグラム、分析型はモジュラー計算 48 問である。モジュラー計算は決まった手順を踏むだけで答えが出る課題で、読み直しは要らない。文のほうも、袋小路文 12 文と統制 24 文に加え、関係節が曖昧な文 12 文と統制 24 文を足した。後者は選択式で、「どちらもあり得る」という選択肢が用意されている。
何が分かったのか?
実験 I の中心の数字はこれだ。曖昧でない文の理解を取り除いたうえでの偏相関が r = 0.33、p = .002。論文は「これらの構成概念のあいだで分散の 11% が共有されていることを示唆する(R² = 0.11)」と書いている。
逆向きの組み合わせでは関係が出ない。ひらめきの成績と曖昧でない文の正答率を、袋小路文の成績を取り除いて見ると r = 0.14、p = .215 だった。ベイズ因子でも、曖昧文を含むモデルのほうが 19.59 倍支持されている。反応時間で見ても、同じ向きの弱い関係(r = 0.23、p = .04)が出た。
実験 II では、作業記憶を先にモデルへ入れても、曖昧文の成績は創造型の成績に 9%(ΔR² = 0.09) を追加した。流動性知能を先に入れた場合でも 5%(ΔR² = 0.05) 残る。文の種類別では、袋小路文が ΔR² = 0.06(B = 0.26、t(96) = 2.64、p = .010)、関係節文が ΔR² = 0.10(B = 0.90、t(96) = 3.48、p = .001)だった。
対照実験がよく効いている。同じ曖昧文の成績は、分析型のモジュラー計算をまったく予測しなかった。追加の説明力は ΔR² < 0.01 で、ベイズ因子は 0.30。つまりデータは帰無仮説(関係がない)のほうが 3.31 倍尤もらしい。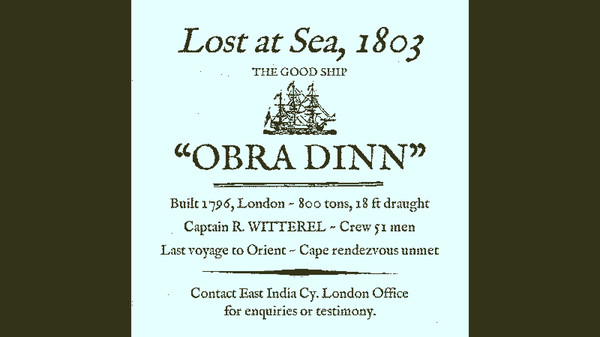 『Return of the Obra Dinn』(Lucas Pope (3909 LLC), 2018)。最初の見立てが外れていたと気づいた瞬間から、本当の推理が始まる。画像: Steam ストアページ
いちばん面白いのは、関係節文をさらに割った分析である。本当に読み直しが必要な文(RC-True)だけが創造型の成績を予測した(ΔR² = 0.05、B = 0.23、t(96) = 2.42、p = .017)。読み直しが要らない側(RC-NP1)は、まったく予測しない(B = −0.007、p = .941)。曖昧な文を読んだことではなく、読み直したことが効いている、と読める形になっている。
著者自身の結論はこうだ。2 つの研究は「創造的問題解決における再構築が、曖昧な言語を理解するために必要な修正と同じ処理を使っている、という見方と整合的である」。断定ではなく、整合的だ、という言い方をしている点は押さえておきたい。
パズルを作る側は、これをどう使えるか?
まず持ち帰り文をひとつ置く。この論文の枠組みに沿うなら、パズルの難しさは「覚えておく量」と「捨てさせる前提の数」という別々の二軸に分けて設計できる。根拠は実験 II にある。作業記憶と流動性知能を差し引いてなお、読み直しの力が創造型の成績を 5〜9% 説明した。同じ「難しい」でも、負荷のかかる場所が違うということだ。
使い道その 1、ミスリードを面の設計材料として明示的に扱う。『Baba Is You』は Hempuli Oy が 2019 年に発売した、ルール文そのものを押して書き換えるメタパズルである(レビュー)。あの難所の多くは、記憶量ではなく「最初に思い込んだ役割の割り当て」を壊す作業でできている。袋小路文の構造とほとんど同じだ。
使い道その 2、ヒントの設計を変える。行き詰まった相手に情報を足すのが普通のヒントだが、この結果に沿うなら、効くのは最初の読みを疑わせる一言のほうかもしれない。「この壁は本当に壁か」「その数字は個数を表しているか」。RC-True だけが効いた結果は、そういう向きを示している。
使い道その 3、チュートリアルの順番を二軸で組む。前半で覚える要素を増やす面と、前半で教えた前提を後半で裏切る面は、別の能力に効いている可能性が高い。両方を同じ「難易度 5」の袋に入れると、プレイヤーの詰まり方を読み違える。
使い道その 4、答え方の形式そのものを設計対象にする。実験 II では関係節の問題に「どちらもあり得る」という選択肢を置いた。著者はこれを、参加者の読み方を変えてしまったかもしれない懸念として挙げている。作り手から見れば逆で、選択肢に曖昧さの受け皿を一つ足すだけで、プレイヤーは自分の解釈を疑い始めるという設計手段になる。
使い道その 5、ルールを言葉で説明しない出題を、別枠の難しさとして扱う。『Understand』は Artless Games が 2020 年に発売した、隠された規則を線で探り当てる論理推理のパズルゲームである(レビュー)。ここで要求されるのは記憶よりも、自分が立てた仮説を捨てる速さだ。
念のため書いておくと、これは相関の研究である。「ミスリード面を増やせば創造性が伸びる」という因果の話は、この論文からは出てこない。出てくるのは、設計者が難しさを分けて考えるための物差しまでだ。
どこまで信じてよいのか?
著者自身が挙げている弱点から書く。まず測定の信頼性が低い。袋小路文の曖昧文で α = 0.60、統制文では α = 0.40 だった。これは相関を弱めもするし、効果の大きさの見積もりをぶれさせもする、と著者は書いている。
次に、再構築そのものを直接測ってはいない。論文の言葉では「本研究に再構築の直接の測定は存在しない」。結果のパターンが共有処理の考えと整合的だというところまでで、著者は「初期の一歩」と位置づけている。
さらに実験 II の反応時間分析は結果が一貫しなかった。関係節文の選択肢に「どちらもあり得る」を置いたことが、参加者に無理やり読み直しをさせた可能性も、著者自身が認めている。
ここから先は Fukai が読んで気づいた点である。第一に、両実験とも事前登録されていない(論文にその旨の記載がある)。第二に、参加者は 1 つの大学の学部生 85 人と 97 人で、性別の偏りもある。この規模と出自で、人一般の話に広げるのは早い。
第三に、実験 II の創造型の代表がアナグラム 1 種類だけになっている。実験 I にあったレビュスが外れているため、「創造的問題解決」と呼ばれているものの中身が、実験によって少し違う。第四に、袋小路文は英語の語順に強く依存する材料であり、日本語話者で同じ関係が出るかは、この論文からは何も言えない。
Fukai の読み
ここだけは私の解釈である。私はこの研究を、「難しさ」を一枚岩として測ってきた歴史に、もう一本の物差しを差し込む試みとして読みたい。パズルの難易度はこれまで、手数・分岐数・必要な記憶量といった、盤面の側の量で語られてきた。この論文が置いているのはプレイヤーの側の量、すなわち「自分の最初の解釈を手放す作業」である。設計批評の語彙で言えば、これはミスリードを演出ではなく機構として数えることに近い。もっとも、著者たちは自分の結果を「整合的」までしか言っていない。私もそこから先へ一歩踏み出しただけだと断っておく。
次に何を読むと地図が見えるか?
ひらめきの側から地図を広げたい人には、当サイトで以前に紹介した Chao et al. の「ひらめきの正体は『遠くまで探す』こと」を並べて読むことを勧める。今日の論文が「最初の読みを捨てる」側から見た洞察だとすれば、あちらは「どこまで遠くを探すか」側から見た洞察である。
言語側から入るなら、文章理解の研究にある「good enough(ほどほどで済ませる)処理」の系譜を追うとよい。読者は文を最後まで厳密に組み直さず、しばしば最初の解釈を引きずる、という一連の知見だ。今日の論文は、その引きずりを断ち切れる度合いの個人差を見ている、と整理できる。
データは公開されている。著者は 2 つの研究のデータを Open Science Framework に置いた(論文には 2026 年 4 月 4 日にアクセスした旨の記載がある)。信頼性に疑問を持った読者が自分で確かめられる形になっているのは、この論文の良いところだ。
参考文献
本記事で参照した論文と関連資料:
・DOI: 10.3390/jintelligence14070128
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第84回 / 全89回