PAPER-DIGEST · 2026-09-11
Tudor ら: 開けば見える勝敗表を、AI は負ける直前まで開かなかった — Fukai が読む
ゲームAI — 300ターンの長期プレイで測る「状態の監視」と「計画と実行のずれ」
要点 — 300ターン遊ばせて分かったこと
情報が画面のどこかに「ある」ことと、遊ぶ側がそれを「見る」ことは、別のことである。今日読む論文は、その差を数字にした。オックスフォード大学などの研究チームが、AI に『Sid Meier's Civilization VI』を1戦300ターン以上、まるごと遊ばせた記録である。
AI は勝敗の進み具合を、30〜75ターンに一度しか確認しなかった。渡された手引きには「20ターンごとに見ろ」と書いてあった。結果、敗北が事前に照会できたはずの20戦のうち7戦で、最後の20ターンに一度も勝敗表を開かないまま負けている。
もう一つの発見は、自分で書いた計画を自分で守れないことだ。日誌に「次はこうする」と書いた約束のうち、10ターン以内に実行されたのは 48.2%〜65.8% にとどまった。著者はこれを「能力が無いのではなく、指示の下での逸脱だ」と整理している。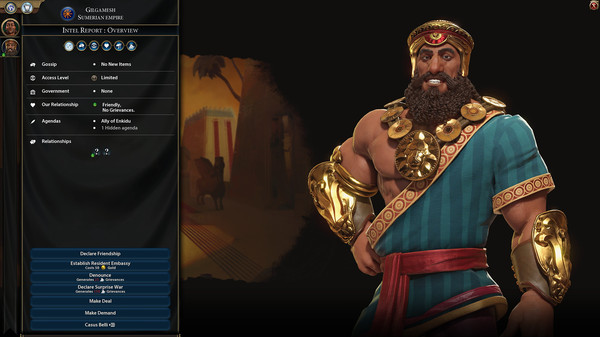 『Sid Meier's Civilization VI』(Firaxis Games, 2016)。1戦が数百ターン続くターン制ストラテジー。今回の論文の実験場である。画像: Steam ストアページ
この論文は誰が書いた、どんな研究か?
論文の題は「CivBench: A Long-Horizon Benchmark for Tool-Mediated Agents in Civilization VI」。arXiv に2026年9月2日に投稿された preprint(査読を通る前に公開される原稿)で、分野は cs.AI である。会議名の記載は無く、2026年9月時点で査読を通ったという情報も見つからない。まだ広く議論されていない段階の研究として読む。
著者は7人。Austin Tudor、David Andrews、Jakob Nicolaus Foerster、Rui Ponte Costa がオックスフォード大学、Liam Wilkinson が Tony Blair Institute for Global Change、Jamie Heagerty が Google DeepMind、Harry Coppock が UK AI Security Institute と Imperial College London の所属として記載されている。実験環境と分析の一式は GitHub で公開されている。
私がこれを今日選んだのは、結論がゲームAI の内輪話で終わらないからだ。「情報は出してあるのに見てもらえない」は、UI を作る人が毎日ぶつかっている問題そのものである。しかもこの論文は、その見てもらえなさを、300ターンという長さの中で回数として数えている。感想ではなく頻度で語れる材料は、そう多くない。
なぜ「長く遊ばせる」評価が必要だったのか?
これまでの評価は、AI の能力を部品ごとに切り出して測ってきた。著者の書き方では「既存の評価は推論、道具の使用、短い先読みといった要素を切り離して測る一方で、それらが長い時間の中でどう噛み合うかについては見通しが乏しい」。10手で終わる試験では、300手の途中で起きる崩れが見えない。
著者が特に問題にするのは二つだ。「関係のある状態を把握し続けているか」と「口に出した計画を、その後の行動に移しているか」。どちらも正解率だけを見る採点では消える。勝ったか負けたかという1ビットに、数千回の判断が圧縮されてしまうからである。
シヴィライゼーションを AI の実験場に使う研究は前からある。Qi らの CivRealm(2024年、ICLR)、FuxiAILab の CivAgent、Chen らの Vox Deorum(2025年)がそれだ。CivBench が変えたのは、情報が「存在すること」と「実際に照会されること」を切り離した点である。著者はこれを「状態の入手可能性と、それが明示的に照会されるかどうかを分離する語りの層」と説明している。
市販のゲームをそのまま使う理由も書かれている。攻略の定石は学習データに入っている可能性があるが、それでも「毎回の対戦は部分観測のもとでの即応を要求する」。地形も相手も毎回違うので、暗記した手順をなぞるだけでは進まない。手作りの練習環境より面倒な代わりに、崩れ方が本番に近い。
どうやって AI にシヴィライゼーションを遊ばせたのか?
『Sid Meier's Civilization VI』は Firaxis Games が 2016 年に発売したターン制のストラテジーゲームである。都市を建て、技術を研究し、外交と戦争をこなしながら、科学・文化・宗教・征服のいずれかで勝利を狙う。1戦が数百ターン続く。人間が遊んでも半日で終わらない長さだ。
著者はこのゲームに MCP(Model Context Protocol、AI が外部の道具を呼び出すための共通の作法)の窓口を付けた。用意した道具は76個。状態の照会が27個、ユニットの操作が10個、都市経営が9個、外交が7個、統治が10個、宗教と文化が5個、進行管理が8個という内訳である。1ターンに5〜15回の呼び出しが走り、1戦で数千回に達する。
ここが要点だが、画面の絵を文章に変える「語り」の関数は29個あり、AI は自分が照会した状態しか見えない。勝利の進み具合も外交の空気も、道具を呼ばなければ届かない。著者の表現では「関係する情報は表現可能だが、受け身では観測されない」。人間なら画面の隅で勝手に目に入るゲージを、AI は毎回取りに行く必要がある。
試したのは4系統のモデルで、採用された記録は23戦。Claude Opus 4.6 が8戦、Gemini 3.1 Pro が6戦、GPT-5.4 が7戦、Kimi-K2.5 が1戦である。盤面は3種類作られ、難易度 Immortal の Cry Havoc は有効な記録が足りず結果から外された。1戦は230〜326ターンに及び、2〜8時間と API 料金31〜229ドルを費やしている。
何が分かったのか?
物差しは2つある。PMR は、土台の操作(ターン終了など)を除いた呼び出しのうち、全体状況の照会に使われた割合だ。RAG@10 は、日誌に書いた約束のうち続く10ターンで実行されたものの割合で、完全実行を1、部分実行を0.5として数える。どちらも勝敗ではなく、途中の中身を見る物差しである。
PMR は 0.96%〜2.13% だった。100回の操作のうち、全体を見渡すために使われたのは1〜2回ということになる。勝利の進み具合の照会は30〜75ターンに一度しか起きていない(Table 2)。手引きは20ターンごとを勧めていたので、勧められた頻度の半分以下である。
もっと具体的な数字がある。敗北の兆しを事前に照会できたはずの20戦のうち、最後の20ターンに一度も勝利進行を確認しなかったのが7戦。内訳は Claude Opus 4.6 が6戦中3戦、Gemini 3.1 Pro が5戦中1戦、GPT-5.4 が8戦中4戦、Kimi-K2.5 が1戦中0戦である(Table 2)。
RAG@10 は 48.2%〜65.8%(Figure 4)。自分で書いた短期の約束のうち3分の1から半分が、続く10ターンで行動に移らなかった。勝利は23戦中3戦で、すべて最も易しい Ground Control 盤面。Claude Opus 4.6 が2勝、Gemini 3.1 Pro が1勝だが、モデル間の差は統計的に有意ではない(Fisher の正確検定、p = 0.488)。著者は「推論の改善だけでは、長期的に信頼できる振る舞いには足りないかもしれない」と書いている。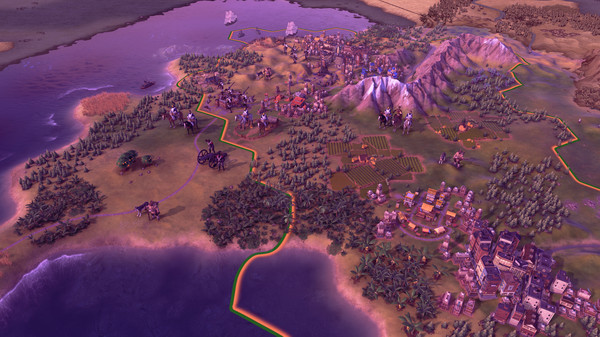 『Sid Meier's Civilization VI』(Firaxis Games, 2016)。勝利条件の進行状況は、人間にはいつでも開ける画面として用意されている。画像: Steam ストアページ
ゲームを作る人は、これをどう使えるか?
持ち帰れる要点は一つに絞れる。「訊けば出る」情報は、出していないのとほとんど同じだと考えた方がよい。以下、具体的な使いどころを5つ挙げる。
1つ目、情報の置き場所を変える。参考になるのは『Into the Breach』で、Subset Games が 2018 年に発売した移動制約グリッドの戦術パズルである。敵の次の一手を全部盤面に描いてしまう設計で、プレイヤーに照会の手間を一切かけさせない。もし自分が長期目標のあるゲームを作っているなら、勝敗に効くゲージは常時表示か、節目での押し付けにする。畳んだメニューの3階層目に置いた数字は、無いものとして設計を組んだ方が安全だ。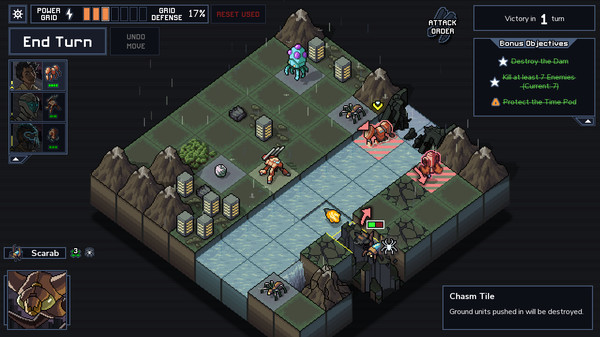 『Into the Breach』(Subset Games, 2018)。次のターンに何が起きるかを盤面側が先に見せてしまう設計で知られる。画像: Steam ストアページ
2つ目、この論文の物差しを自分のゲームの UI 検査に借りる。AI エージェントに自作ゲームを遊ばせ、ある情報を何ターンに一度照会したかを数えるだけでよい。数字が低ければ、その情報は見つけにくい場所にある。人間のプレイテストより安く、何度でも回せる。ただし後の節で書くように、AI の照会頻度を人間の注意の代用と見なすのは私の拡張であって、論文の主張ではない。
3つ目、計画と実行のずれを設計側で埋める。『Opus Magnum』は Zachtronics が 2017 年に発売したプログラミング・手順記述のパズルゲームで、書いた手順がそのまま動く。ずれが原理的に0になる設計である。もし自分が数十時間続く作品を作っているなら、プレイヤーが立てた方針を UI 側が覚え、逸れたときに静かに思い出させる仕組みが効く。RAG@10 の数字は、その物忘れが例外ではなく常態だと言っている。 『Opus Magnum』(Zachtronics, 2017)。手順を書いて動かす作りのため、立てた計画と実際の動作が原理的にずれない。画像: Steam ストアページ
4つ目、長編に LLM の相棒や敵 AI を載せるなら、見る動作を外から強制する。この論文の AI は、見ろと書かれた手引きを持っていても見なかった。つまり監視は、賢いモデルを選べば付いてくる性質ではない。もし自分が LLM 駆動の相手役を作るなら、「20ターンごとに必ず全体を照会させる」処理を枠組み側に書いてしまう方が確実である。
5つ目、負けの予告を惜しまない。20戦のうち7戦は、負けが見える情報が開かれないまま終わっている。これは情報を隠した結果ではなく、開かせ損ねた結果だ。もし自分が長い campaign やローグライトを作っているなら、敗北がほぼ確定する数十ターン前に、頼まれなくても警告を出す価値がある。「気づける人だけが得をする作り」は、腕前ではなく照会の習慣を試している。
この研究で分かっていないことは何か?
著者自身が挙げる弱点は多い。23戦では「大きな効果しか検出できない」。共通の手引きを渡しているので、観察されたのは「モデルの推論、道具の使用、指示追従の組み合わせ」になる。無作為や台本どおりに動く比較対象は置いていない。勝利はすべて一つの盤面で起きており、他の地形や難易度では振る舞いが変わり得ると明記されている。環境側には、ゲームのバージョン依存や、接続が1本しか張れないという制約もある。
物差しそのものへの留保も書かれている。PMR と RAG@K は「監視に数える道具の定義」と「計画文の解釈」に依存する。約束の実行を判定したのは Haiku 4.5 で、評価対象の Claude Opus 4.6 と同じ系統のモデルである。加えて、本番前の試走では21%しか完走しておらず、残りは記録として採用されていない。
Fukai がここで指摘するのは、三点である。第一に、「20ターンごと」という基準は人間が書いた手引きの数字であって、最適値として検証されたものではない。20ターンごとに見ていれば勝てたのかは、この論文からは分からない。第二に、PMR は割合なので、操作の回数が増えるだけで下がる。忙しく動いた AI は、見る回数が同じでも不注意に見える。第三に、対象は AI エージェントであって人間のプレイヤーではない。前の節で UI の話に引き寄せたのは私の外挿で、論文は人間の注意について何も測っていない。
Fukai の読み
ここからは私の読みである。私はこの研究を、物差しが「何ができるか」から「何を見に行くか」へ移っていく流れの中に置きたい。設計批評の語彙に翻訳すれば、これは能力の測定ではなく注意の配分の測定に近い。面白いのは、その配分が盤面の作りで動く点だ。訊かないと出ない情報を置いた瞬間、設計者は相手の注意を試す試験を出したことになる。人間相手なら、それは「気づける人だけが得をする作り」と読める。AI 相手でも同じ崩れが出たのなら、この試験が測っているのは思考の速さではなく習慣の設計の方だ、と私は読む。
次に何を読むと地図が見えるか?
もっと深く知りたい人は、まず CivRealm(Qi ら、2024年、ICLR)を読むとよい。シヴィライゼーションを AI の実験場に選ぶ発想の出どころが分かる。Vox Deorum(Chen ら、2025年)はシヴィライゼーション5を対象に、大規模言語モデルと従来型の AI を組み合わせた構成を報告している。今日の論文が測った「照会の頻度」は、この系譜の中では新しい切り口である。
当サイトでは、ルールを教えないゲームで AI の発見する力を測る試み(Battleday らの論文)と、人が初見のゲームをどこまで先読みするか(Collins らの論文)を扱った。今日の1本は、その二つの間にある「見に行く手間」を数えた研究として読める。能力と行動の間には、照会という一手が挟まっている。
参考文献
本記事で参照した論文と関連資料:
・civ6-mcp — 論文が公開している実験環境(GitHub)
・画像: Sid Meier's Civilization VI(Steam ストアページ) / Into the Breach(Steam ストアページ) / Opus Magnum(Steam ストアページ)
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第83回 / 全89回