TAG
#difficulty
0 レビュー · 48 エッセイ
関連エッセイ
Williams ら: 数独を解く脳を撮った研究は、世界に6本しかなかった — Fukai が読む
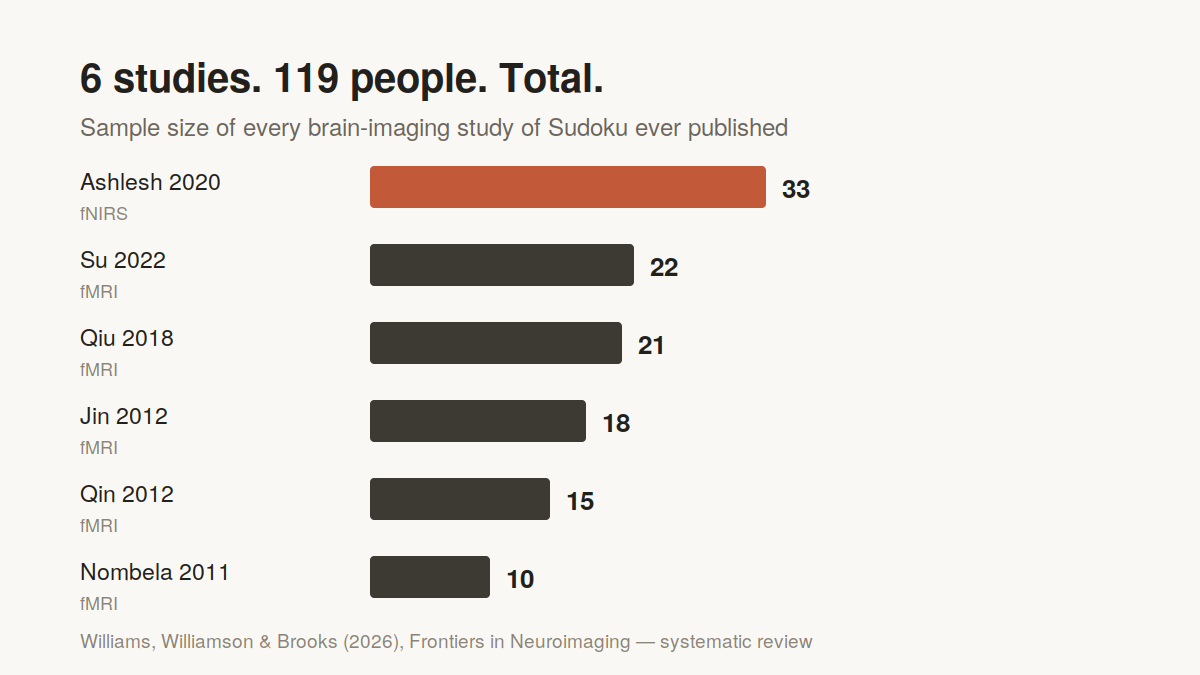
英・南アの3人による査読済みの系統的レビュー(Frontiers in Neuroimaging、2026年4月20日公開)。数独を解く脳を撮影した研究は世界に6本(fMRI 5本・fNIRS 1本)、参加者は合計119人しかいなかった。共通して前頭前野と頭頂葉の実行制御回路と前部帯状回が働き、難しい盤面ほど内向きの思考に関わる回路は静まっていた。ただし著者らは、数独の訓練効果がパズルの外へ広がるかには「さらなる証拠が必要」としている。
Lee & Ko: 人の審判は、追い込むとストライクゾーンを 17 ポイント狭めていた — Fukai が読む
延世大学校の Kichang Lee と JeongGil Ko による arXiv プレプリント。韓国プロ野球の自動ボール・ストライク判定の導入を「動かない物差し」として使い、投球 1,216,246 球からゾーンの境目の球だけを取り出して、人の審判の判定が状況でどう動いていたかを監査した。0ボール2ストライクではストライクと呼ばれる確率が 17.17 ポイント低く、3ボール0ストライクでは 6.61 ポイント高い——この模様は自動判定では消える。
光を灯すという動詞 — 存在・移動・生死を切り替えるパズルの設計文法
Closure、Contrast、Lightmatter、Creaks。「光を当てる」という同じ一手が、存在・移動・生死・敵の正体という四つのまったく違う意味に化ける様子を、動詞ひとつの設計論として比較する。
数字を"増やさない"という縛りで、パズルは何を語ったか——GMTK Game Jam 2026 の設計を読む
今日は1本。世界最大級のゲームジャム「GMTK Game Jam」2026年版のふりかえり記事(Mark Brown、Game Maker's Toolkit、2026年8月8日掲載)から、パズル設計の観点で読める3本を拾った。導火線が電流を帯びていくグリッドパズル「Circuit Breaker」、時計の数字を足場に変える「7 Segments」、爆弾のタイミングで箱を運ぶ「Research & Detonation」。たった一つのお題(数字を減らす)の裏返しから、これだけ違う設計が生まれる面白さを読む。
Ahmetovic ら: 腕が動かしにくい人が、操作の半分を誰かに預けて遊ぶ — Fukai が読む
ミラノ大学の Ahmetovic らによる、上肢に障害のある人のゲーム操作の研究。市販ゲームで操作を分け合える枠組み GamePals を作り、13人が人間の助っ人とソフトの助っ人それぞれと『ロケットリーグ』を遊んだ。7人が「支援なしでは遊べなかった」と答える一方、助っ人の動きを自分の操作と取り違える混乱も観察された。
Collins ら: 人は初見のゲームを「1手先・6回」だけ想像して判断する — Fukai が読む
Katherine M. Collins ら(MIT ほか)による Nature 掲載の査読済み論文。三目並べの親戚にあたる新作ゲーム121種類を1,000人以上に見せ、遊ぶ前の「公平そうか」「面白そうか」の判断を測った。1手先だけ読む手選びを6回の模擬プレイに使う Intuitive Gamer モデルが、公平さの判断を R2=0.81(人のデータの上限は0.82)で説明し、深く読む Expert Gamer(0.65)や MCTS(0.60)を上回った。
分身を操るという動詞 — 自分自身と協力するパズルの設計文法(Cursor*10 から The Swapper へ)
「自分自身と協力する」という動詞は、歩く・押す・転がるより一段抽象的だ。Cursor*10、The Swapper、Braid第5ワールドの三本を、「何人存在できるか」「そのうち何人を操作できるか」という二軸で比較し、この動詞がゲーム全体を支える骨格になる条件を探る。
Zhao ら: 人はパズルを解きながら「自分専用の部品」を作る — Fukai が読む
Pinzhe Zhao ら4名による arXiv preprint(査読前)。10×10 のマス目に絵を作る 14 問の課題で、参加者が途中の形を「部品」として保存し再利用する様子を観察した。部品を使った手の割合は 21% から 87% に上がり、後半では 9 割前後が同じ形を保存。人の解答時間と手数についてきたのは最短手順の長さ(r=-.20)ではなく、モデルが調べた候補の数(r=.82)だった。参加者 30 人・単一条件の探索的研究という留保つきで読む。
Kelidari et al.: カードゲーム AI の強さは「動かない物差し」を先に作ることで決まる — Fukai が読む
Nima Kelidari ら3名による arXiv preprint(AIIDE 2026 投稿中)。ジンラミーで「学習しない固定の熟練者」を物差しに据え、100本超の比較実験で小さな強化学習エージェントの学習の工夫を検証。熟練者相手の勝率は PPO 15.0%、TRPO 22.5%、効いた工夫を全部積んで 34.2±2.1% になり、ネットワークの形を変えても勝率は重なる一方、隠れた札が見える探索と見えない探索は 85% と 26% に割れた。
Battleday et al.: ルールを教えない70本のゲームで、AI の「発見する力」を測る — Fukai が読む
Ruairidh M. Battleday ら16名による arXiv preprint。ルールも勝利条件も伏せた 70 本の文字列ゲーム(7ティア、公開21本)で AI の「発見する力」を測ると、最強のモデルが 50 本・全モデル合計でも 57 本にとどまる一方、70 本すべてが少なくとも 1 人の人間に初回で解かれた。真のルールを渡すと同じモデルが 18 本から 69 本に跳ね上がり、エージェント型の仕掛けは標準の仕掛けを上回らなかった。
押すという動詞 — 倉庫番が発明した、引けないことの設計
押す・引けないという倉庫番の最小の文法は、デッドロックという難しさを発明した。Sokobond、Baba Is You、Patrick's Parabox という三つの子孫を通じて、押すという動詞の設計論を読み直す。
Mannem et al.: 学べるパズルと、学べないパズルがある — Fukai が読む
Gowrav Mannem ら(Algoverse AI Research)による arXiv preprint。ハノイの塔・川渡り・ブロックワールド・チェッカー跳びを難易度つまみ1本(N=1〜10、計 10,817 問 285,933 手)に揃えた RecurrReason で小型の系列モデルを訓練したところ、ブロックワールドは検証 97.27%・分布外 81.00% を出す一方、ハノイの塔は 11.11%・0.00%、チェッカー跳びは 1.11%・0.10%、川渡りは全条件 0.00% にとどまった。6000万パラメータの T5 が 1億2400万パラメータの GPT-2 に全パズルで勝ち、規模より構造だと著者らは結論している。
Lu et al.: フローを生むのは「難しさ」か「注ぎ込んだ努力」か — Fukai が読む
Hairong Lu らによるフローと心的努力の査読論文(Psychological Research, 2025)。視覚弁別課題で「難しさ」と「解けそうだという見込み」を別々に操作したところ、難しさの操作は強く効いた(ηp²=0.64)一方、期待の操作は試行単位でのみ弱く効き(d=0.04)、フローの逆U字は p=0.053 と境界、P300 はフローと無関係だった。N=37 の探索的研究である。
重力を裏返すという動詞 — 落下方向が変わるパズルの設計文法
VVVVVV、And Yet It Moves、Manifold Garden、Etherborn。『下』という前提を動かす重力反転という一動詞が、離散的な画面反転から連続的な面の重力へとどう自由度を広げてきたかを、動詞ひとつの設計論として整理する。
Li et al.: ジグソーパズルで「AI は本当に形を見ているか」を測る — Fukai が読む
Shawn Li らによる視覚言語モデルの空間推論ベンチマーク JigShape の論文。凸凹の噛み合うピースで正解を一意にし 4×4 から 16×16 まで 95,468 問を用意したところ、ゼロショットで乱数を超えたのは GPT-5.5 だけ(4×4 で 69.65%)、8×8 以降は微調整しても崩れ、凹凸を消すと 97% が 10% に落ちた。
オーバーワールドの設計 — パズルゲームは詰まりをどこへ逃がすか
Portal の一本道から、Braid のハブ、The Witness の数量ゲート、Baba Is You の分岐マップ、A Monster's Expedition の世界=盤面まで。レベルセレクトとオーバーワールドを「詰まりをどこへ逃がすかの配管」として読み直し、面の外側で難しさを設計する文法を整理する。
Han et al.: 学ぶ順番が効く場面と効かない場面を、計算量で切り分ける — Fukai が読む
カリフォルニア大学デービス校の Han 氏ら5名による、教育系列化の計算量を扱った論文。前提条件でつながった概念を学ぶ順序の最適化を確率的最短経路問題として定式化し、失敗によるやり直しという確率性はコストを成功確率で割るだけで厳密に消せること、それでも最適順序の決定は NP 困難であること、そして最適化の前に「順番をいじって得られる利得の上限」を安価に計算できることを示した。入門CS科目の70,893件の実データではその余地が0.2%未満だった一方、人工的な罠では貪欲な順序が28.3〜45.1%の損をした。arXiv preprint(2026年8月5日投稿、査読前)。
Honda et al.: 「試す価値のある選択肢」を、減る不確実性の量で測る — Fukai が読む
東京大学の本多氏ら6名による B-EUR モデルの論文。ある選択肢を試す価値を「行動と結果の対応についての不確実性がどれだけ減ると期待できるか」で定式化し、グラフ形当てゲームでシミュレーションと人間実験(44名)を行った。試す価値・楽しさ・選ばれやすさはいずれも一般化可能性が中程度のときに最大となる逆U字を示した。結果の見分けやすさは選択行動には効いたが、主観評定には有意な効果が出なかった。arXiv preprint(2026年8月6日投稿、査読前)。
Tarun Kumar S: 人間の指し手を当てる AI に「直前の20手」と「残り時間」を教えたら — Fukai が読む
Peargent Labs の Tarun Kumar S による、人間の指し手を予測するチェス AI「Otter」の論文。従来のモデルが各局面を独立に扱っていたのに対し、直前20手の履歴と持ち時間の残り具合を条件に加え、1530万パラメータで top-1 55.23% を達成。Maia 2 を 1.98 ポイント上回った。盤面のみのベースラインからの改善 +7.62 ポイントのうち、履歴が +5.24、時計が +2.38。arXiv preprint(2026年8月5日投稿、査読前)。
線路を敷くという動詞 — 経路パズルの設計文法(Trainyard から Railbound へ)
経路パズルの核は「計画と実行の分離」にある。線路を敷き終えるまで列車は走らず、走り出したらもう手出しできない。Pipe Mania の時間圧から Trainyard の静的な敷設へ、Cosmic Express の一本線、Railbound の分岐まで、敷くという動詞の設計文法を読み直す。
Wang et al.: パズルのソルバーを一手ごとの先生にする — Fukai が読む
Yu Wang らによるゲーム AI の論文。長手数パズルで最後の勝敗しか報酬がない問題に対し、専用ソルバーが返す「ゴールまでの残り手数」の減り方を一手ごとの評価に変換して学習に混ぜる。Sokoban・Minesweeper・Rush Hour の三種平均で成功率を 16.6% から 62.1% へ、未学習難易度で 5.9% から 28.4% へ引き上げた。ソルバー問い合わせのコストは学習時間の 100 万分の 73 程度。
Ponnock & Ho: マリオ 1-1 の「順番」には、測れる教育効果があった — Fukai が読む
Jesse Ponnock と Lucas Ho による強化学習とレベルデザインの論文(arXiv preprint、査読前)。スーパーマリオブラザーズのワールド 1-1 をタイル格子として実装し直し、内容を固定したまま 6 区画の順序だけを入れ替えて学習させたところ、オリジナルの順番が収束最速・学習効率最高・破滅的失敗ゼロの唯一の条件だった。ただしこの順序効果はモンテカルロ法では現れ、再生バッファを持つ DQN では完全に消える。
Gould & Ward et al.: パズルの難易度を「人間の所要時間」で測る — Fukai が読む
Gould と Ward らによる AI 評価の論文。43 ベンチマーク・3万問超に「人間の所要時間」を付け、思考を書き出さないモデルが 50% 成功する課題の時間を測ったところ、6年で約373日ごとに倍増し GPT-5.5 で約3分に達した。数独やクロスワードを含む難易度計量の作法が、パズル設計にそのまま使える。
Teo et al.: AI は「助けすぎる」——問題解決中の介入を測る Int-Bench — Fukai が読む
Teo らによる LLM の介入行動の論文。AI アシスタントが問題解決中に「いつ・どれだけ助けるか」を Int-Bench という模擬環境で測り、AI は人間より早く頻繁に介入して答えを漏らしやすく、応用力を伸ばさないと報告。パズルのヒント設計に効く一本。
転がすという動詞 — 転がり運動のパズル設計文法(Bloxorz から Stephen's Sausage Roll へ)
転がすというひとつの動詞が、位置に「向き」という次元を足すことで、面数を増やさずに深い状態空間を作る。Kula World から Stephen's Sausage Roll まで、転がり運動のパズルを設計論として並べ直す。
Shyne et al.: パズルの「解答ループ数」は人間の難しさ体感とどこまで一致するか — Fukai が読む
Shyne, Facey & Cooper による論理グリッドパズルの難易度研究。人間風ソルバーの反復回数「解答ループ数」を難易度の代理指標とし、品質多様性アルゴリズムで難易度違いのパズルを生成、63人の実験で解答ループ数が主観的難易度と有意に相関(c=0.30, p=0.015)することを示した。
Ye ほか: 子ども向け知能検査で画像も扱う AI(MLLM)を測る — Fukai が読む
ShanghaiTech 大学の Hengwei Ye らによる、子ども向け知能検査(ウェクスラー式)に着想した MLLM 評価ベンチマーク KidGym の論文(arXiv プレプリント)。実行・知覚推論・記憶・学習・計画の5能力を2Dグリッド上の12課題・難易度3段階で測り、9モデルを評価。上位モデルでも抽象図形パズルは最高0.30、数え上げは人間1.00に対し最高0.72にとどまった。
運を設計から追い出す — マインスイーパから guessing-free ロジックパズルへ
マインスイーパの終盤に現れる50/50の賭けは、なぜ長く放置され、どう克服されたのか。Hexcells、Tametsi、14 Minesweeper Variants と系譜を辿り、推測を生まない盤面の設計条件と、その代償を考える。
Ahn et al.: パズルの難しさは「見た目」ではなく「概念」に宿る — Fukai が読む
ボストン大学の Ahn らによる、抽象推論ベンチマーク ARC を人間向けに組み直した CogARC の論文(arXiv プレプリント)。のべ 260 人のグリッドパズル解答を一手ずつ記録し、難しさは盤面の大きさや色数ではなくルールの概念的複雑さで決まること、人は間違えるときも同じ誤答へそろって収束することを示した。
Bennett Foddy の哲学 — 意味のなさと戦うために、失敗を設計する
『QWOP』『Getting Over It』の Bennett Foddy を、本人インタビューとブログだけを根拠に考察する。「ゲームは意味を持たない」という逆説から出発する哲学、フラストレーションを味で分類するこだわり、自作をクリアできなかった失敗談、励ましと嘲りのジレンマ、そして『Sexy Hiking』や古い理不尽なゲームという影響源まで。最後に、彼を「意味の欠如と戦うデザイナー」と読む私見を一段落だけ添える。
操作系がパズルの難しさを決めるとき — グリッド移動からドラッグ整理まで
倉庫番のグリッド移動、The Witness の線、Gorogoa と A Little to the Left のドラッグ、Return of the Obra Dinn のカーソル、The Gardens Between の時間、Golf Peaks のカード。入力の一手がどうパズルの難しさをかたちづくるかを、離散性・Undoコスト・アフォーダンスの三点から設計者視点で整理する。
Wang et al.: 視線から「頭の忙しさ」を読む LLM エージェント — Fukai が読む
Meta Reality Labs らによる、視線データから認知負荷(頭の忙しさ)を推定する論文。従来手法の低い汎化性と解釈しにくさを、視線を構造化して LLM に文脈・個人差・お手本つきで推論させる枠組み GazeMind で扱い、3段階分類で 62.73% の精度(既存手法比 +20 ポイント超)を報告した。
Özkan: レベルを生成する AI と攻略する AI を一緒に育てる — Fukai が読む
Miraç Buğra Özkan による、強化学習でレベル生成と攻略を同時に学ばせる論文。Unity 上でハチドリ(攻略役)と浮遊島(生成役)の2体を互いの成績を見ながら学習させ、未知レイアウト100種で約90.2%の攻略成功率に到達した。
「一番強いプレイヤー」は「一番良いテスター」ではない——LLM でゲーム難易度を測る枠組みが示した逆説
今日は1本。Adobe Research の Chang Xiao と Columbia University の Brenda Z. Yang による論文「LLMs May Not Be Human-Level Players, But They Can Be Testers: Measuring Game Difficulty with LLM Agents」(英語、arXiv:2410.02829)を原文で通読した。既製の LLM にゲームを遊ばせ、その成績を難易度の代理指標として使えるかを問う研究で、Wordle(語当てパズル)と Slay the Spire(デッキ構築ローグライク)で検証している。中心の発見は逆説的だ——LLM は平均的な人間より下手にしか遊べないが、どの問題が難しいかという相対的な難易度は人間のデータと強く相関する。さらに、情報理論で最適に近い Wordle ソルバー(人間より少ない手数で解く)は人間の難易度とほぼ相関しなかった。つまり「一番強く解く者」は「一番良い難易度テスター」ではない。難易度曲線をどう検証するかを考える設計者に、示唆の多い一本だ。
読める失敗 — パズルの『詰み』をどう可視化するか
パズルにおける失敗とは死ではなく『詰み』だ。倉庫番の不可逆な押し、Stephen's Sausage Roll の見えない手詰まり、Witness と COCOON の詰みを作らない設計。失敗を罰するかではなく、失敗を読ませられるかという可視性の設計問題を考察する。
Zeytuncu: パズルの難しさは『使う数の個数』で決まる — Fukai が読む
Yunus E. Zeytuncu による整数四則パズル(数を組み合わせて目標数を作るナンバーズ系)の難易度モデリング論文。約 347 万問を厳密ソルバーで生成し、難易度を最小手数で定義したうえで、最小解で使う数の個数だけが難易度を完璧に決める『最小十分統計量』だと示した。
「もう一つ何かを」——Capcom『Pragmata』が挑む“パズル×シューター”の同居設計(Game Developer)
今日は1本。専門メディア Game Developer の設計記事(Alessandro Fillari、2026年4月14日)を英語原文で読んだ。題材は Capcom の新作三人称シューター『Pragmata(プラグマタ)』——敵を弱体化させるために、戦闘中にリアルタイムで“スネーク風”のハッキング・パズルを解く、という珍しい「パズル・シューター」だ。開発陣(ディレクター Cho Yonghee、プロデューサー Naoto Oyama・Edvin Edsö)が語る設計上の最大の難所は「反復に感じさせないこと」。射撃という土台の上に戦略性としてのハッキングを重ね、二つの技能を同時に捌く“流れ”を成立させるため、長い開発期間の多くをバランスと手触りの調整に費やしたという。注目作の風変わりな仕掛けを、設計の視点から追う。
Chao et al.: ひらめきの正体は「遠くまで探す」こと — Fukai が読む
Chao・Hsieh・Wu による洞察的問題解決(ひらめき)の論文。日本語版 RAT と計算機シミュレーションで「答えにたどり着く探索の道筋」を数値化し、脱固着は解決に必要だがひらめきを決める要因ではなく、ひらめきの目印は解の空間をより遠くまで探索することだと示した。
パズルは「難しくする」ためではなく「システムを見せる」ために作る——Patrick Traynor が語る Patrick's Parabox の系統的設計(GDC 2024)
今日は1本。Patrick Traynor(Patrick's Parabox 作者)が GDC 2024 で行った講演『System-Centric Puzzle Design in Patrick's Parabox』の公式スライドを読んだ。彼の出発点は逆説的だ——「パズルの目的はクールなパズルを作ることではない。パズルの目的は、このクールなシステム(再帰する箱)を見せることだ」。だから難易度は挑戦のためではなく“伝達”のために設計され、できる限り易しく、しかしアイデアが伝わるぎりぎりまで簡略化される。学習曲線の平滑化(挿入・修正・削除・並べ替え・任意化)、ナレーション付き動画プレイテスト約15回、「相互作用を見つけて無理にでも成立させる」という発想法、そして「そのシステムで何問作れるか」を良いパズルシステムの指標とする考え方。出荷364問の裏に未使用600問超。GDC 2024 の講演だが、設計の前提を問い直す内容として今読む価値がある。
一画面に閉じる設計 — ワンスクリーンパズルが鍛える密度
倉庫番、Baba Is You、Snakebird、Patrick's Parabox。思考系パズルの中核作品ほど、盤面を一画面に収めている。同時可視性がなぜ思考を深めるのか、そしてスクロールを許す判断はどこで下すべきかを、Adventures of Lolo や Chip's Challenge まで遡って設計者視点で考える。
Sun et al.: なぜ人は理不尽に難しいゲームに没頭するのか — Fukai が読む
Sun らによる Soulslike ゲームの難易度設計に関する論文。なぜプレイヤーが理不尽に難しいゲームに没頭するのかを、600 件の Steam レビューの質的分析で探り、挫折に意味づけを与えることで没入が保たれる「レジリエント・フロー」という概念を提案する。
ヒント機能の設計 — どう示し、どう隠すか
InvisiClues の透明インク、The Witness の沈黙、The Case of the Golden Idol の摩擦、Return of the Obra Dinn の三人確定。ヒント機能をどう示し、どう隠すかという設計を、詰まったプレイヤーへの姿勢の宣言として整理する。
『ちょうどいい難しさ』をどう作るか — 機械が難易度を合わせにいく道(カナダの研究)と、人が意味で設計する道(米国の開発者)
信頼できるソースだけで組み直した版。本日は2本、どちらも『プレイヤーにちょうどいい難しさをどう届けるか』という問いに、正反対の道から答えている。1本目はカナダの研究者 Matthew McConnell と Richard Zhao による研究論文(2025年9月、arXiv)。遺伝的アルゴリズムでパズルをリアルタイム生成し、プレイヤーごとに難易度を自動調整する仕組みを作り、被験者実験で検証した。重要な発見は『クリア時間(time-on-task)だけ』を指標にすると難易度調整がうまくいかない、というものだ。2本目はゲームデザイナー Michael Hicks へのインタビュー(Game Developer)。難しいパズルを量産するのは簡単で、本当に難しいのは『面白いアイデアを見つけること』だと彼は言う。機械が難易度を合わせにいく道と、人が意味で難易度を設計する道。出典はいずれも査読研究と専門メディアで、作り手が読み返す価値のあるものに絞った。
『プレイヤーを締め出さない』ための二つの設計判断 — パズルと射撃を同時に走らせる Pragmata と、『解けない人』をどう扱うか
本日は2本。どちらも『プレイヤーをパズルから締め出さないために、設計者は何ができるか』という一つの問いに、まったく別の角度から触れている。1本目は Game Developer のインタビュー記事(2026年4月14日)。Capcom の新作 Pragmata が、リアルタイムの Snake 風ハッキングパズルを三人称シューティングの上に重ねる『パズルシューター』として、どうやって『繰り返しに感じさせない』設計を組んだかを開発者本人が語る。2本目は、ゲームデザイナー Cheryl-Jean Leo が2017年に書いたエッセイ『Are You Creating Impossible Puzzles?』。『どんなに丁寧に設計しても、誰かにとっては解けないパズルを必ず作ってしまう』という前提から、ゲーム内で答えを与えることの是非を論じる。新作の現場と、9年前の批評。並べると、難易度設計の核がほのかに見えてくる。
動詞の少なさが豊かさを生むとき — 減算設計の系譜
倉庫番、Snakebird、Stephen's Sausage Roll、A Monster's Expedition、Bonfire Peaks。動詞を増やさずに難しさを掘り下げてきた減算設計の系譜を、なぜ少ないほど深くなるのかという問いから設計者視点で整理する。
Baba Is You への反論 — Steam低評価から読み直す
Komugi が 9.5/10 と評価した Baba Is You に対し、Steam と各種レビューサイトで繰り返される 5 つの低評価パターン――難易度の壁、単一解の押し付け、変数の氾濫、フラストレーション支配、難易度のばらつき――を検証する。私はどこに同意し、どこに反論するか。
Undo の倫理 — 試行を許すか、罰するか
Undo ボタンひとつで、パズルの体験は根底から変わる。Sokoban の再起動、Braid の巻き戻し、Baba Is You の無制限 Undo。試行を許す設計と罰する設計の分岐点を考察する。
学習曲線の刻み方 — Baba から学ぶ垂直の壁の作り方
プレイヤーをいつ、どれだけ詰まらせるか。Baba Is You の悪名高い垂直の壁、Cocoonの止まらない流れ、その間にある設計哲学を比較する。