PAPER-DIGEST · 2026-10-02
Xu と Verbrugge: 5×5マスの並べ方を、小さなAIが「毎回ちがう技」に翻訳した — Fukai が読む
スキルの自動生成 — 一貫性と多様性の綱引きを、手元の言語モデルで解く
まず要点(TL;DR)
ローグライクは毎回ちがう展開で遊ばせてくれる。けれど、毎回ちがう「技そのもの」はほとんど作ってくれない。技やユニットは今も人の手で書かれている。カナダ・マギル大学の Kaijie Xu と Clark Verbrugge は、そこに手元で動く小さめの言語モデルを入れてみた。
舞台は二人が作ったブラウザゲーム Neural Spore Genesis だ。プレイヤーは火・水・土・木・金の「元素セル」を5×5のマスに並べる。その並びを、モデルが戦闘スキルに「翻訳」する。結果、モデルは並べた元素に合った技をほぼ必ず出しつつ、同じ並びからでも毎回ちがう技を出した。比べた4種類の従来手法は、この両立ができなかった。ただし「縦一列」の形はほとんど読めておらず、人が遊んで確かめる実験もまだない。
はじめに — FDG 2026 で見つけた「技を生む」研究
おはよう。今朝もホットの濃いめのドリップコーヒーを淹れて、論文を一本プリントした。紹介するのは Generate Diverse Skills with Large Language Models だ(ワークショップの一覧では “Generate Infinite Skills with Large Language Models” という題で載っている)。著者はマギル大学の Kaijie Xu と Clark Verbrugge。当サイトでは以前、同じ二人の「重力の向きや時間をレベル生成の座標にする」研究も紹介している。
発表先は FDG '26(Foundations of Digital Games。2026年8月10〜13日、コペンハーゲン)に併設された PCG Workshop で、DOI も振られている。PCG(Procedural Content Generation、コンテンツの自動生成)の専門ワークショップだ。ワークショップ論文は本会議のフル論文より短く、途中段階の研究も多い。発表されて間もないので、まだ広く議論されていない段階でもある。
今日これを選んだのは、題材が「レベル」ではなく「技」だからだ。パズルやローグライクを作る人にとって、プレイヤーが組んだ形に意味を与える仕組みは、遊びの芯そのものになる。その翻訳を機械に任せられるのか。数字つきで確かめた研究は、まだ多くない。
背景 — ランダムは「展開」には効くが「仕組み」には届いていない
著者によれば、ローグライクやオートバトラー(auto-battler。編成だけ決めて、戦闘は自動で進むゲーム)の繰り返し遊べる面白さは、報酬や敵の並びのランダムさから来ている。ところが、そのランダムさは技やユニットの「中身」にまではあまり及ばない。何も制約せずにランダムにすると、効果がちぐはぐで、戦略として読めず、プレイヤーが狙った形とも無関係な技になりがちだからだ。
既存の自動生成にも工夫はある。たとえば Noita の呪文の組み合わせは、論文でも豊かな呪文エンジンの例として挙がっている。ただ、こうした仕組みは決められた効果の語彙と、決められた組み合わせ方の中で動く。言語モデルでゲームを作る研究も増えたが、多くは文章で指示を出すものだ。プレイヤーが組んだ「空間の形」から、実際に動く戦闘の仕組みを作る研究はほとんどなかった、と著者は整理している。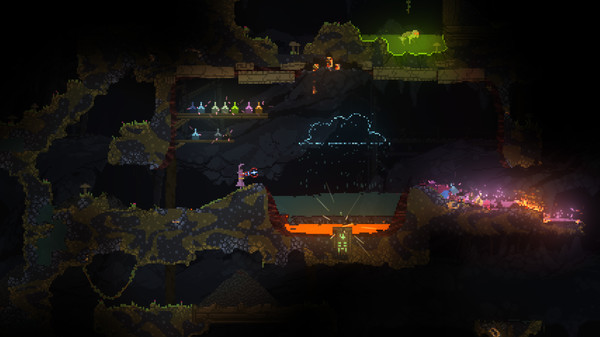 Noita(Steam ストアのスクリーンショット)。論文が「豊かな呪文エンジン」の商業例として挙げる作品
ここで二つの要求がぶつかる。一つは一貫性だ。火が多い十字形なら、火の範囲攻撃が出てほしい。水の弾が出ては困る。もう一つは多様性だ。同じ形を別の回で組んだら、ちがう技が出てほしい。著者はこれを「一貫性と多様性の綱引き」と呼んでいる。
アプローチ — 並びを「特徴」に要約し、モデルに技の設計図を書かせる
ゲームは三つの段階を回る。まず買い物。市場に並ぶ4つの元素セルを金で買う(お金を払えば並びを引き直せる)。次に組み立て。5つのスキル枠それぞれに5×5のマスがあり、買ったセルを配る。最後に戦闘。組んだスキルが、強さが段階的に上がる敵の波に向けて自動で使われる。報酬は次の買い物に回る。
マスの並びは、そのままモデルに渡すわけではない。まず「特徴」に要約する。いちばん多い元素、形の種類(横線・縦線・斜線・密なかたまり・L字・T字・角の集まりの7種)、埋まり具合、左右対称の度合い、元素の混ざり方(1種・2種・3種・多種)だ。さらに「攻撃的」「防御的」「補助的」「バランス型」という意図の目安も、簡単な決まりで付ける。
モデルは、その要約を受け取って、技の設計図を JSON(データを書くための決まった書式)で書く。設計図には決まった型(スキーマ。どの欄に何を書くかの決まり)がある。行動は弾・範囲・回復・盾・強化・突進・召喚・光線・全方位・罠・反響の11種、付加効果は吸収・気絶・減速・吹き飛ばし・継続ダメージ・貫通・連鎖・飛散・追尾・会心・出血の11種だ。威力や射程、再使用までの時間には上限と下限がある。名前と説明文も一緒に書かせる。
比べた相手は4つある。形と意図から決まった技を出す「決まり型」、型に合う範囲で完全にランダムに選ぶ「ランダム型」、人が書いた20種の技を強さだけ調整して当てはめる「テンプレート型」、元素と形ごとに人が決めた確率で選ぶ「確率型」だ。モデルは手元のGPU(RTX 4080)で動く Llama 3.1 8B と Qwen2.5 14B の2つ。7つの形×5つの元素×3つの混ざり方で105通りの並びを作り、それぞれ5回ずつ、つまり1条件525個の技を作らせた。採点は11の自動指標で行う。
物差し — 「合っているか」と「ばらけているか」を別々に測る
11の指標は三つの組に分かれる。一つ目は「壊れていないか」。設計図が型どおりか、数値が範囲内かを見る。二つ目は「合っているか」。いちばん多い元素と技の主な元素が一致すれば1点、二番手の元素なら0.5点、どこにもなければ0点、という元素の一致度が中心だ。形に対して、ふさわしい行動の種類を選べたかも測る。
三つ目は「ばらけているか」。いちばん大事なのは、同じ並びから作った5個の技どうしが、どれだけちがうかを測る指標だ。技を埋め込み(embedding。文やデータを、意味の近さが測れる数の並びに直したもの)にして、互いの距離の平均をとる。0なら毎回同じ技が出ている。ほかに、行動の種類の偏りのなさや、11種の付加効果のうち何種を一度でも使ったか、なども測っている。
人が遊んで評価する実験はない。すべて自動の採点だ。この点は著者自身が限界として明記している。後の節で詳しく触れる。
発見 — 小さなモデルが「合っていて、しかも毎回ちがう」を両立した
論文の Table 2 から主な数字を引く。元素の一致度は、Llama 3.1 8B と Qwen2.5 14B がどちらも 0.994。決まり型は 1.000 だが、同じ並びからの技のばらけ具合は 0.000、つまり毎回まったく同じ技だった。テンプレート型もばらけ具合は 0.000。ランダム型は元素の一致度が 0.301、テンプレート型は 0.371 にとどまった。ばらけ具合は Llama が 0.429、Qwen が 0.433、確率型が 0.371 だ。
著者の言葉を借りれば、二つのモデルは「高い一貫性と高い多様性」の領域にいて、どの比較相手もそこに届かなかった(論文の Figure 6)。元素の一致度などの差は、Kruskal-Wallis 検定(3つ以上のグループの差が偶然かどうかを確かめる方法)で p < 10⁻⁵ と報告されている。付加効果の利用率も、モデルは 1.000(11種すべて使った)で、確率型は 0.455 だった。
弱点もはっきり出た。形にふさわしい行動を選べたかの指標は、決まり型の 1.000 に対し、Llama が 0.422、Qwen が 0.554 だ。形ごとに見ると差が大きい(Figure 4)。密なかたまりは Llama 0.97、Qwen 1.00 と高い。ところが縦線は Llama 0.07、Qwen 0.09 だった。著者は、モデルが線の向きをうまく区別できていないと見ている。説明文と実際の効果の一致度では、手書きのテンプレート型が 0.503 で最も高く、モデルは 0.42〜0.43 だった。
温度(temperature。モデルの出力のでたらめさを決めるつまみ)を変えた実験もある(Table 3、Llama のみ、50通り×2回)。ばらけ具合は 0.3 で 0.297、1.2 で 0.472 まで上がった。それでも元素の一致度は 0.9 以下で 1.000、1.2 でも 0.995 と、ほとんど落ちなかった。著者はこれを「温度が多様性の主なつまみだ」と結論している。大きい Qwen は形の一致などで勝るが、生成速度は毎秒およそ15トークンに対し8トークンと、約1.9倍遅い。
使いどころ — パズルやローグライクを作る人へ
一つ目。もし Backpack Battles のような「並べ方で強さが決まる」ゲームを作っているなら、この論文の流れがそのまま型紙になる。並びをまず数個の特徴に要約し、モデルには決まった型の設計図だけを書かせる。モデルに盤面を丸ごと理解させようとしない。この「要約してから渡す」が、元素の一致度 0.994 を支えていると読める。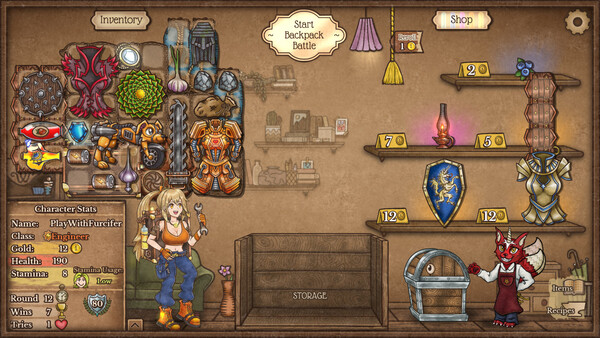 Backpack Battles(Steam ストアのスクリーンショット)。並べ方そのものが戦力になるゲームの一例(論文では扱われていない)
二つ目。決まり型を捨てずに並べて持つ。決まり型は形の一致で満点、モデルは縦線でほぼ0点だった。ならば、プレイヤーがはっきり意図を込めやすい形(線の向きなど)は決まり型で骨格を決め、名前や付加効果の組み合わせだけをモデルに任せる、という分担が考えられる。プレイヤーが「縦に並べたのに縦の技が出ない」と感じれば、それは理不尽に映るからだ。
三つ目。温度を「レア度」のつまみとして使う。温度を上げると、元素の一致をほぼ保ったまま、ばらけ具合が上がった。たとえば通常の報酬は低い温度、宝箱や特別なイベントは高い温度、と分ければ、珍しさの演出に使える。ただし論文は強さの釣り合いを測っていないので、上げた温度で強すぎる技が出ないかは自分で確かめる必要がある。
四つ目。パズルの「描いた形がルールになる」仕掛けにも応用できる。プレイヤーが描いた図形を特徴に要約し、それを短いルール(押す・引く・凍らせる等)の設計図に翻訳させる。型の上限と下限が、盤面を壊すルールを防ぐ柵になる。設計図が型どおりになる率は Qwen で 1.000、Llama で 0.984 だった。それでも数%は崩れるので、受け取る側で型を検査する仕組みは必須だ。
限界 — 著者が認める点と、私が気づいた点
(a) 著者自身が認めている弱点は四つだ。まず、人による評価がない。埋め込みの近さや決まりへの適合は測れても、プレイヤーが感じる一貫性や驚き、自分で作った手応えは測れていない。次に、7つの形・5つの元素・3つの混ざり方という閉じた枠の中の結果であり、もっと曖昧な組み方への一般化は示していない。さらに、モデルは 8B〜14B の手元向けに限られ、大きなモデルで形の弱点が埋まるかは分からない。最後に、指示文(プロンプト)は1種類だけで、書き方を変えた比較や、例を見せる工夫は試していない。
(b) Fukai がここで指摘するのは、まず強さの釣り合いが測られていない点だ。私が確認した範囲では、論文は技の強さや戦闘の勝ちやすさを評価していない。オートバトラーでは、ちがう技が出ることより、ちがう技がどれも使い物になることのほうが難しい。「多様」と「遊べる多様」の間には、まだ距離がある。
Fukai がもう一つ指摘するのは、物差しの性質だ。形の一致を測る指標は「この形にはこの行動が期待される」という集合で採点する。決まり型が満点なのは、その期待とほぼ同じ決まりで動いているから、とも読める。逆に、モデルが縦線で別の行動を選んだのが本当に「まちがい」なのかは、人に遊ばせないと決められない。また、ばらけ具合は埋め込みの距離で測るため、名前や説明文の言い回しがちがうだけでも数値が上がりうる。効果の中身がどれだけちがうかとは、分けて考えたい。
最後に速さだ。論文は毎秒何トークンかは示すが、1つの技を作るのに何秒かかるのか、遊んでいる最中に作るのか事前に作り置くのかは書いていない。実際のゲームに入れるなら、待ち時間と作り置きの設計は自分で詰める必要がある。
Fukai の読み — プレイヤーの並べ方は「ソースコード」になる
ここからは私の意見だ。論文はマスの並びを技に「コンパイルする(compile。人が書いたものを機械が実行できる形に変換する)」と表現している。私はこの言葉づかいを、設計の大きな流れの中に位置づけたい。Noita のような呪文エンジンは、プレイヤーの組み合わせを文字どおりに実行する。そこでは組み方の意味を決めるのは規則であり、驚きは規則の組み合わせ爆発から生まれる。この研究は逆で、「組み方の意味を読み取る」仕事を言語モデルに任せている。設計批評の言葉で言えば、プレイヤーの表現への「解釈」の自動化に近い。そう読むと、縦線が読めないという弱点は、単なる精度不足ではなくなる。解釈がずれたとき、プレイヤーはそれを「意外な発見」と感じるのか、「裏切り」と感じるのか。そこを人で測ることが、この研究の次の一歩の核心だと私は読んでいる。
おわりに — 地図を広げるなら
もっと深く知りたい人は、生成器の「表現の幅」を測る考え方の原点である Smith と Whitehead の2010年の論文を合わせて読むとよい。この研究の多様性の指標も、その流れの上にある。言語モデルを PCG に実用的に使う道筋なら、Nasir と Togelius の2023年の研究が入口になる。論文が参照している Withington(2025)の「10億通りの呪文の可能性空間」の分析も、規則で組む側の地図として対になる。
著者たち自身は、次にプレイヤー実験と、より大きなモデルでの検証、例を見せる指示文の工夫を挙げている。オートバトラーなら種族・職業・相性といった変数を構造化して渡し、強さの調整と検証はゲーム側の仕組みに任せる、という形も提案している。続報が出たら、また紙に印刷して色ペンを持とうと思う。
参考文献
本記事で参照した論文と関連資料:
・関連研究: Practical PCG Through Large Language Models (Muhammad U. Nasir, Julian Togelius, 2023, arXiv)
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第99回 / 全99回
次に読む
関連レビュー
Desktop Dungeons: Rewind
一画面ぶんの小さなダンジョンに潜り、未踏のマスを開くと体力が戻るルールを使って格上のモンスターを1体ずつ倒していく、ターン制のパズル・ローグライク。2013年の『Desktop Dungeons』を QCF Design が3D表示で作り直し、手を巻き戻す rewind と拠点の王国建設を載せた版。
Isle of Arrows
ランダムに配られたタイルを空に浮かぶ島へ1枚ずつ置き、道を伸ばして塔を並べ、侵入者の波を防ぐパズル寄りのタワーディフェンス。要らないタイルはコインを払って飛ばせる。Gridpop による盤上遊戯とタワーディフェンスの混血。
Duskers
無人になった宇宙船へドローンを送り込み、燃料と部品を拾って次の船へ渡る。ドローンへの指示はすべて文字を打って出し、見えるのはカメラ一枚と、何かがいることだけを知らせるセンサーの点。Misfits Attic が作った、暗がりで段取りを組む一人用の作品。