PAPER-DIGEST · 2026-09-30
Surendran & Cooper: 単語を穴埋めして作るミニゲームで、詳しい設計書は短い指示に勝てなかった — Fukai が読む
生成AI × PCG — Mad Libs 式のミニゲーム生成
一段落要約
「場所」「数字」「形容詞」。こうした言葉の空欄を埋めると、生成AIがその場で小さなゲームを書き上げる。子どもの頃に遊んだ穴埋め作文「Mad Libs」を、ゲーム作りに持ち込んだ研究だ。
著者は2種類の指示文(プロンプト)を比べた。細かく書いた設計書のような「Full」と、ジャンルと単語だけを渡す「Simple」である。4ジャンル・計96本を作って遊んだ結果、起動するかどうか、クリアできるかどうかでは両者はほぼ互角だった。
一方で、入れた単語がゲームに現れた割合と、ゲーム同士の見た目や遊びの違いは、短い Simple の方が上回った。ただし完成までたどり着けるゲームは全体の約半分。著者2人だけが評価した小さな予備的研究でもある。
誰が、どこに書いた論文か
著者は Akash Surendran と Seth Cooper。どちらも米ノースイースタン大学(Northeastern University)の所属だ。Cooper はパズルの自動生成や、ゲームを使った研究を長く手がけてきた研究者だ。
発表先は FDG '26(Foundations of Digital Games、2026年8月・コペンハーゲン)に併設された PCG Workshop だ。PCG は Procedural Content Generation、つまりゲームの中身をプログラムで自動生成する技術のこと。論文には ACM の DOI が付いている。ワークショップ論文なので、本会議の長い論文より短く、途中経過の報告に近い位置づけだと私は理解している。
今日これを選んだのは、題材が「ミニゲーム」だからだ。数秒で終わる遊びを次々に出す『メイド イン ワリオ』の系譜は、パズルサイトにとっても身近である。生成AIでゲームを作る研究の多くは「もっと大きく、もっと完璧に」を目指す。この論文はあえて逆を向いている。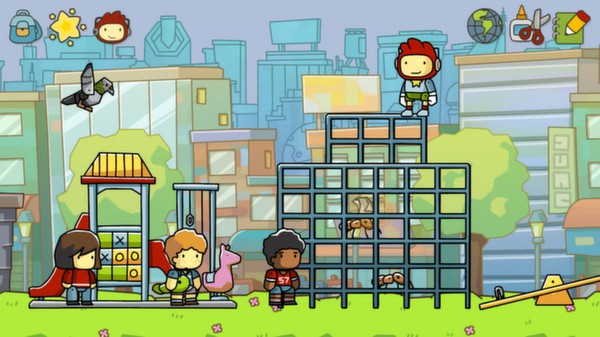 Scribblenauts Unlimited(5th Cell Media、2012)。書いた言葉がそのまま物になって現れる。言葉からゲームの中身が決まる、という発想の先輩格だ(Steam スクリーンショット)
なぜ「未完成でいい」ゲームなのか
ゲームを作るのは今も大変だ。作る敷居を下げる道具や言語は昔から研究されてきた。近年は大規模言語モデル(LLM。大量の文章で学習し、文章やプログラムを書けるAI)にコードを書かせる研究が増えている。
論文の関連研究の節は、その流れを短く押さえている。ボードゲームを生成した METAGAME や Ludi。ゲームを記述する専用言語 VGDL を使った進化的な生成。そして LLM による Unity の試作品づくりや、ワリオ風ミニゲームの仕組み生成だ。
ただし大きなゲームを丸ごと生成すると、つじつまの合わなさや粗さが目立つ。著者はここで発想を反転させる。数秒で終わるミニゲームなら、粗さは見逃されやすい。むしろ笑いにつながるかもしれない。Mad Libs の面白さも、文脈を知らずに選んだ単語がちぐはぐにはまる瞬間にある。
だから目標は「LLM の能力を伸ばすこと」ではない。今ある LLM をそのまま使い、磨かれていない、小さくて個人向けのゲームを作ることだ、と著者は書いている。
どうやって作り、どう確かめたのか
仕組みは単純だ。指示文のひな形に {{PLACE}} や {{VERB_1}} のような空欄を置く。遊ぶ人には中身を見せず、「場所」「動詞」といった項目だけのリストを渡す。埋めた単語を空欄に差し込み、完成した指示文を LLM に渡してゲームのコードを書かせる。
たとえば「{{PLACE}} で {{VERB_1}} している感じにすること」という一文は、「家」と「走る」を入れると「家で走っている感じにすること」になる。使ったモデルは Anthropic の Claude Sonnet 4.5。ゲームは Python の Pygame で、画像素材なしのコードだけで描かれる。
比べたひな形は2種類だ。Full は設計書に近く、遊び方、目的、体力などの具体的な値、よくあるバグの避け方まで書いてある。Simple はジャンル名と単語の一覧、それに「単語をゲームに入れること」という指示だけだ。
ジャンルはタワーディフェンス、プラットフォーマー(足場を跳んで進むゲーム)、反射神経を試すリアクション、ジグソーパズルの4つ。著者2人がそれぞれ単語リストを8個ずつ作り、各リストから Full と Simple の両方で3本ずつ生成した。計96本を、作っていない方の著者が遊んで評価した。ジャンルとひな形の種類は伏せられていた。
評価の問いは段階式で4つ。起動するか。遊べるか。クリアできるか。そして面白いか。加えて、単語がタイトル・画面の文字・それ以外の形でいくつ現れたかを数え、同じ条件の3本が遊びや見た目で「はっきり違う」かも数えている。
何が分かったのか
まず動くかどうか。論文の Table 1 によると、起動したのは Full が100%、Simple が98%。遊べたのは Full 98%、Simple 92%。ここまではどちらも高い。
壁はその先にある。クリアできたのは Full 50%、Simple 48%。面白いと判定されたのは Full 31%、Simple 35%だった。著者は、ほぼ半数のゲームが完成状態に届かないか、不当に難しかったと書く。原因はたいてい調整とバランスの不足だという。
ジャンルで差も出た。タワーディフェンスは Full なら12本すべてクリアできたが、Simple は6本。ところが「面白い」は Full が0本、Simple が5本だった。ジグソーはクリアできたのが Full 3本、Simple 6本。リアクションは Full 4本、Simple 8本である(各ジャンル・各ひな形12本中)。
単語の取り込みは Simple が優位だった。表の全体値で、使われた単語の種類は Full 41%に対し Simple 64%。画面の文字として現れた割合は Full 28%、Simple 57%。3本の生成物が互いにはっきり違った割合も、Full 60%に対し Simple 75%だった。
ただしジグソーでは中身が逆転する。Full は単語が指す物を絵として描いたが、Simple は単語をできるだけ詰め込もうとした。結果、パズルの絵がいつも「単語を書き並べた板」になったという。数字の上では Simple が勝っても、遊びとしては別の話になる例だ。
著者のまとめは慎重だ。どちらの作り方も結果はおおむね同程度で、一方が明らかに優れるわけではない。ミニゲームなら短い指示文で十分かもしれない、というのが結論である。
どこで壊れたのか
私がいちばん面白く読んだのは、壊れ方の観察だ。作り手が自分の作品で同じ落とし穴に落ちないための、良いチェックリストになっている。
まず数字。画面に「5」と出ていて、コインが5枚あると思わせるのに、実際には2枚しかない。著者は、数字は文脈から切り離されて空欄に入るので、意味の通る範囲に収めるのが難しいと指摘する。ジグソーでは、何も描かれていない白いピースが複数あり、置き場所を当てずっぽうで探すしかない例があった。
プラットフォーマーでは、跳んでも届かない高さの足場が出た。リアクションでは、著者が反応できない速さで押す的が出てきた。どれも「遊べるが、クリアできない」の典型だ。
単語の現れ方にも型があった。図形と色を組み合わせて単語の絵を描く「図形の絵」(メガネ、トマト、星など)。四角に色を塗るだけの表現(青い水、黄色いラード、緑の粘液)。怒りが速く動く赤い物体で表されるなど、単語の感情をとらえた例もあったという。著者は、単語が文字として画面に出ること自体が「入った」感覚を強めたと書いている。
パズルを作る側は、これをどう使えるか
一つ目。もし自分がデイリーパズルの「おまけ」を作っているなら、この穴埋め方式はそのまま試せる。読者から「今日の単語」を3つ集め、それを題材にした一回限りのミニゲームを出す。大事なのは、完成度よりも「自分の言葉が入った」と感じさせることだ。論文の観察どおり、単語を画面に文字で出すだけでも効く可能性がある。
二つ目。生成したものをそのまま出さず、必ず検査を挟む。論文では起動率はほぼ100%でも、クリアできたのは半分だった。倉庫番風のパズルなら、ソルバー(解けるかどうかを自動で調べるプログラム)で解けることを確かめてから出す。当サイトで紹介したAI に遊ばせて直す研究や検証器をカリキュラムにする研究は、この「穴」を埋める方向の仕事だ。
三つ目。数字の空欄は遊ぶ人に任せない。コインの枚数や制限時間のように、遊びの成否を決める値は作り手側で範囲を固定する。遊ぶ人に埋めさせるのは、名詞や形容詞のような「見た目と雰囲気」を決める言葉にとどめる。論文の数字の失敗例は、この線引きの必要性をよく示している。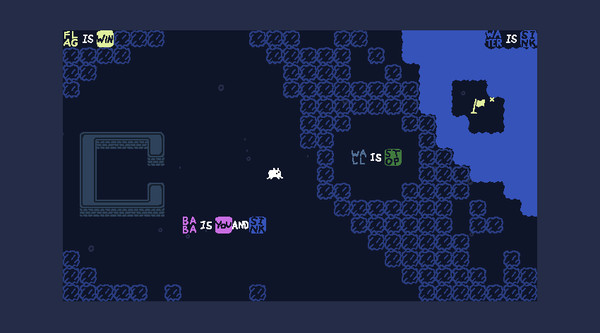 Baba Is You(Hempuli Oy、2019)。言葉のブロックを並べ替えるとルールが変わる。言葉を「見た目」ではなく「仕組み」に効かせた例として、穴埋め生成の先を考えるのに役立つ(Steam スクリーンショット)
四つ目。ジャンルごとに指示の詳しさを変える。タワーディフェンスは詳しい Full の方がクリアしやすかったが、面白さは Simple が上だった。ジグソーは Simple だと絵が単語の板になった。ジャンルによって「縛るべきところ」が違う、と読める。自分のパズルで、どこは固定し、どこを生成に任せるかを決める手がかりになる。
五つ目。同じ指示から3本作って選ばせる。論文では、同じ条件の兄弟作とはっきり違ったゲームが Full で60%、Simple で75%あった。数本を並べて遊ぶ人に選ばせれば、失敗作を引く体験を「くじ引き」の楽しさに変えられるかもしれない。
どこまで信じてよいのか
著者自身が認める限界は多い。使ったモデルは Claude Sonnet 4.5 の1つだけで、生成AI全般の能力を代表しない。もっと詳しいひな形で結果が伸びるかも試していない。評価は著者2人による非公式なもので、各ゲームを見たのは1人だけ。2人ともゲーム制作の経験者で、実験の当事者でもある。無関係な人を集めた評価はしていない、と明記している。
「面白いか」は最も主観的な問いで、評価した著者の好みにほぼ任されていた、とも書かれている。したがって Full 31%・Simple 35%という数字は、傾向の目安として読むべきだろう。
Fukai がここで指摘するのは、比較の規模だ。1ジャンル・1ひな形あたり12本で、元になった単語リストは各ジャンル4つしかない。Full と Simple の数本の差は、単語の選び方ひとつで入れ替わりうる。論文も統計的な検定は行っておらず、「優劣なし」という著者の結論は妥当だが、「Simple の方が良い」とまでは言えない。
もう一つ、この研究では遊ぶ人自身が単語を入れて遊ぶ体験を測っていない。Mad Libs の笑いは、自分が選んだ単語だからこそ生まれるはずだ。著者も今後の課題に、遊ぶ人を対象にした調査を挙げている。私はそこが、この方式の価値を決める本丸だと考える。
Fukai の読み
ここからは私の意見だ。私はこの研究を、「生成の品質」から「生成の手触り」へ関心が移る流れの中に位置づけたい。これまでの PCG 研究は、解けるか、難しさは適切か、を主に測ってきた。この論文が数えたのは「単語がどこに現れたか」と「3本がどれだけ違ったか」である。設計批評の言葉で言えば、これは作品の出来ではなく、遊ぶ人の「関与の手応え」を測ろうとする試みに近い。半数がクリアできないゲームでも、自分の単語が赤い怒りの物体になって飛んでくれば、人は笑うかもしれない。その仮説を確かめる次の実験を、私は待っている。
次に何を読むと地図が見えるか
著者は今後の方向として、複数の LLM での比較、手元で動く小さなモデルでの生成、不快な内容が生成される可能性への配慮、遊ぶ人を対象にした調査を挙げている。さらに、コードを書かせる代わりに「ワールドモデル」(映像を直接生成して、遊べる世界そのものを作るAI)でミニゲームを作る案にも触れている。
その方向を知りたい人は、論文が引く Genie(Bruce ら、2024)と、拡散モデルでゲーム画面を生成する Valevski ら(2025)を読むとよい。当サイトの動画生成AIをゲームエンジンとして読み直す論文の解説も入口になる。
言葉がゲームを動かす感覚を体で知りたいなら、Scribblenauts Unlimited と Baba Is You を遊んでみてほしい。前者は言葉が物になり、後者は言葉がルールになる。この論文の穴埋めミニゲームは、そのちょうど手前にいる。
参考文献
本記事で参照した論文と関連資料:
・Fill-in-the-Blank Microgames (Akash Surendran, Seth Cooper, 2026, PCG Workshop at FDG '26、全文 PDF)
・DOI: 10.1145/3815598.3815713 (ACM Digital Library)
・関連研究: Genie: Generative Interactive Environments (Bruce et al., 2024)
・関連研究: Diffusion Models Are Real-Time Game Engines (Valevski et al., 2024 arXiv / 2025)
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第97回 / 全98回