PAPER-DIGEST · 2026-09-24
Kemmerly ら: 当たっていないのに自信がある人は、多く賭け、多く調べた — Fukai が読む
意思決定の心理学 — 根拠のない自信は、行動のどこに出るのか
一段落要約
自分の知識をどれだけ信じているか。その「自信」のうち、実際の正しさでは説明できない部分を、この論文は「根拠のない自信(unjustified confidence)」と呼ぶ。Kemmerly らは米国の成人 997 人に、大学フットボールの試合結果を 40 問当てさせ、1問ごとに自信を答えさせた。そのうえで、同じ人が遊びのお金で賭ける場面でどう振る舞うかを見た。
正答率の差を統計的に取り除いても、自信の高い人ほど賭け金が大きく(相関 r = .18)、有料の情報を買う割合も高かった(r = .10)。一方、渡された情報を見て予想を直す度合いとは、ほとんど関係がなかった(r = −.04)。気持ちの面では「やれる気がする」「迷わず決められる」感覚が強かった。ただ「新しい情報に開かれている」という自己評価とは無関係だった。
パズルに置き換えるなら、こう読める。当たっていないのに自信がある人は、大胆に答えを出し、ヒントも手に取る。けれどヒントで考えを変えるとは限らない。ただしこれは相関の研究で、原因と結果の向きまでは分からない。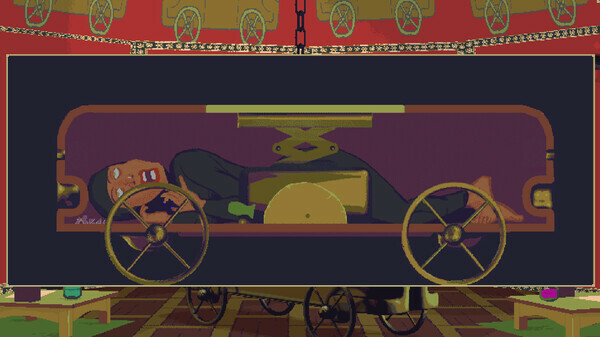 『The Case of the Golden Idol』(Color Gray Games, 2022)。空欄をすべて埋めてから正誤の判定を受ける推理パズル。自信の持ち方が、そのまま遊び方に出る。画像: Steam ストアのスクリーンショット
誰が、どこに書いた論文か?
著者は4人。筆頭の Rowan Kemmerly は米ラトガース大学ニューアーク校の心理学科に所属する。Andrew M. Parker は RAND 研究所、Annie H. Somerville は法律事務所 King & Spalding、Eric R. Stone はウェイクフォレスト大学心理学科だ。Parker と Stone は、自信と知識をめぐる論文を以前にも共著している(本文で Parker & Stone, 2014 が引かれている)。
発表先は Judgment and Decision Making(判断と意思決定の専門誌)第21巻の e16。2026年7月10日にオンライン公開された査読済みの論文で、ライセンスは CC BY 4.0 だ。測定方法、除外の基準、変数の計算方法は、OSF に事前登録(実験の前に分析の手順を公開しておくこと)されている。公開から2か月あまりで、まだ広く議論されている段階ではない。
今日これを選んだのは、以前に読んだ McCaughey らの「情報を買うコスト」の論文(記事はこちら)と、ちょうど裏表になっているからだ。あちらは値段が調べ方をどう変えるかを見た。こちらは、同じ値段でも自信の違いで調べ方が変わるかを見ている。ヒントを売る・置く設計を考える人には、並べて読む価値がある。
「自信のずれ」は、どこまで分かっていたのか
人の自信が実際の知識と合わないことは、判断と意思決定の研究で長く確かめられてきた。論文はこれを2つに分けて整理する。1つは、全体として自信が高すぎること(過信)。もう1つは、自信の高い人と低い人の差が、実際の知識の差とあまり連動しないことだ。
問題は、その「ずれ」が行動にどう響くかである。人は自信があるから行動する。だから根拠のない自信は判断の質を下げるはずだ、と考えられてきた。けれど著者によれば、これまでの研究の多くは成績や損得といった「結果」を主役にし、自信はその原因の1つとして扱うにとどまっていた。
著者はこれを裏返す。自信を主役に据え、それが同時にいくつもの気持ちや行動とどうつながるかを見る。こうすると、自信がある道筋では良い方向に、別の道筋では悪い方向に働く、という食い違いも見つけられる。結果だけを見ていると、この2つは打ち消し合って見えなくなってしまう。
もう1つの論点は「知識への自信」と「予測への自信」の違いだ。すでに起きたことを知っているか(知識)と、これから起きることを当てられるか(予測)。同じ自信でも、性質が違うかもしれない。この論文は、同じ対戦カードを使って両方を比べている。
どうやって「根拠のない自信」を測ったのか
参加者は Qualtrics(オンライン調査会社)のパネルから集めた。まず 1,976 人に声をかけ、アメフトに興味のない 517 人を除いた。同意した 1,118 人から、回答時間が短すぎる人などを除き、最終的に 997 人が分析に残った。調査は 2021年9月20〜21日に行われている。
参加者は2つの条件にランダムに分けられた。「知識」条件では、前シーズン(2020〜21年)の大学フットボールの試合について、2校のどちらが勝ったかを 40 問答える。「予測」条件では、同じ 40 組について、始まったばかりの 2021〜22年シーズンの勝者を予想する。どちらも1問ごとに、自信を 50%(当てずっぽう)から 100%(確実)まで 10% 刻みで答えた。
要になるのは「根拠のない自信」の取り出し方だ。著者は、自信のうち実際の正答率で説明できる部分を、統計的に差し引いた。残った部分が根拠のない自信である(偏相関という手法。ほかの変数の影響を除いたうえでの関係の強さ)。
次に、気持ちを尋ねる質問票に答えてもらう。「やれる気がする(empowerment)」「迷わず決められる(decisiveness)」「新しい情報に開かれている(openness)」の3つを、それぞれ6項目・5段階で測った。
最後が行動の課題だ。遊びのお金 20ドルを元手に 16 ラウンド、チームのシーズン末の順位(Sagarin というレーティング)を予想し、0.10〜1.00ドルを賭ける。予想が当たれば賭け金は倍になり、大きく外れれば失う。前半8ラウンドは、予想のあとに前年の順位が無料で示され、予想を直せる。後半8ラウンドは、その前年の順位を10セントで買うかを選べる。本気で取り組んでもらうため、参加者の1%には遊びのお金の残高が本物のお金で支払われた。
この課題から3つの行動を取り出す。1つ目は平均の賭け金(リスクを取る度合い)。2つ目は、無料で示された前年の順位の方へ、どれだけ予想を動かしたか(情報を使う度合い)。3つ目は、後半で10セントを払って情報を買った割合(情報を探す度合い)である。
何が分かったのか
まず、自信のずれそのもの。正答率は平均 52% で、当てずっぽうの 50% とほとんど変わらない。一方、自信は平均 72%。原文では過信の大きさを 21 ポイントとしている。予測条件のほうが自信は高く(平均 .74 対 .70)、過信もわずかに大きかった(.22 対 .20)。
自信と正しさの連動も弱かった。知識条件で相関 r = .15、予測条件では r = −.02 で、ほぼゼロである。未来を当てる問題では「自信がある人ほど当たる」という関係が見られなかったことになる。
気持ちとの関係。正答率を差し引いたうえで、根拠のない自信は「やれる気がする」と r = .25、「迷わず決められる」と r = .20 の関係があった。ところが「新しい情報に開かれている」とは r = .05 で、統計的に意味のある関係はなかった。自信過剰な人ほど頑固だ、とはこのデータからは言えない。
行動との関係。賭け金とは r = .18(知識条件 .15、予測条件 .23)。有料の情報を買う割合とは r = .10 だ。ただし後者は、知識条件では r = .14 だったが、予測条件では .06 で有意ではなかった。そして無料の情報で予想を直す度合いとは、全体で r = −.04。予測条件だけで見ると r = −.09 で、わずかにマイナスだった。
重回帰分析(複数の要因を同時に入れ、それぞれ独自の効き目を見る方法)も行われた。賭け金をもっともよく説明したのは自信で(β = .16)、「やれる気がする」も少し効いていた(β = .10)。情報を買う割合では、自信がプラス(β = .10)、「開かれている」がマイナス(β = −.09)だった。自分は情報に開かれていると答えた人ほど、情報を買わなかったことになる。
ただ、数字の大きさには気をつけたい。相関はどれも .10〜.25 の範囲で、小さめだ。回帰モデルで説明できたばらつきは、賭け金で 4.2%、情報の購入で 1.7% にとどまる。「傾向は確かにあるが、行動の大部分は別の要因で決まっている」と読むのが正確だろう。
パズルを作る側は、これをどう使えるか
この論文の題材はアメフトの賭けだが、骨組みは「答える前にどれだけ自信があるか」と「情報を取りに行くか、使うか」の組み合わせだ。これはパズルのヒント設計とよく似た形をしている。以下は、私がこの結果をゲームに持ち帰るならどうするか、という読みの提案である(論文はゲームを扱っていない)。
(1) ヒントの「購入数」と「効き目」を別の指標として測る。この研究では、根拠のない自信は情報を買う行動と結びついたが、情報で考えを変える度合いとはほぼ無関係だった。ヒントがよく売れていることは、ヒントが役立っていることを意味しない。ヒントを見たあとに答えが変わったか、正解に近づいたかを、別のログとして取っておきたい。
(2) 答え合わせの粒度で、自信のずれを早めに知らせる。『Return of the Obra Dinn』(Lucas Pope, 2018)では、乗員の運命は3人分そろって正しいときにだけ確定する。1人ずつの答えに自信があるだけでは、何も返ってこない。自信と正しさが連動しにくい状況では、こうした「まとめての判定」が、大きな失敗の前にずれを気づかせる仕組みとして働く、と私は読む。 『Return of the Obra Dinn』(Lucas Pope, 2018)。乗員の運命は3人分が正しくそろったときにだけ確定する。1人ぶんの自信では答え合わせにならない。画像: Steam ストアのスクリーンショット
(3) 賭け金を自分で決めさせる場面には、自信の差がそのまま乗ると想定する。スコアを倍にするか選ばせる、手持ちを賭けて挑む、といった仕組みでは、根拠のない自信が強い人ほど大きく張る。未来を当てる予測条件のほうが関係が強かった(r = .23)ことから、運の要素がある場面ほど効きやすいとも読める。大負けのあとの立て直し手段を用意しておくと、自信過剰な人を早々に脱落させずに済む。
(4) 「知識の問い」と「予測の問い」を分けて考える。すでに画面にある手がかりから答える問題と、まだ起きていないことを当てる問題では、自信のふるまいが少し違った。予測では、自信と正しさの関係がほぼゼロだった。予測型の問いで「確信度」を入力させる UI を作っても、それは正しさの手がかりとしては当てにならない可能性がある。
(5) アンケートの自己申告を信用しすぎない。自分は情報に開かれていると答えた人ほど、有料の情報を買わなかった(β = −.09)。プレイテストで「ヒントがあれば使う」と答えた人が、実際に使うとは限らない。質問票と行動ログを両方取っておくのが安全だ。
どこまで信じてよいのか
(a) まず、著者自身が認めている弱点。いちばん大きいのは、正答率がほぼ当てずっぽう(平均 52%)で、正答率の測定の信頼性(α = .17。同じものを一貫して測れているかの指標で、1に近いほど良い)がきわめて低かったことだ。著者は、正答率で調整しても実質的な違いはほとんど生じないと認めている。つまりここでの「根拠のない自信」は、事実上「自信そのもの」に近い。
気持ちの尺度の一貫性も控えめだった(α = .53〜.66)。情報を使う度合いの計算では、14〜15% の回答が計算できず、約3割が上下限で切り詰められ、回帰分析からは外された。題材はアメフトの賭け1つだけで、他の分野に広げられるかは分からない。そして著者自身が、この研究は相関の研究であり、原因の向きは決められないと明言している。
(b) ここからは Fukai がここで指摘する点だ。第一に、「情報を買う」ことと「情報を使う」ことは、別のラウンド・別の条件で測られている。前半は無料、後半は有料で、同じ情報を「買って、使ったか」を追ったわけではない。だから「自信過剰な人は、買ったヒントを使わない」とまでは言えない。
第二に、賭けは遊びのお金で、本物のお金になるのは参加者の1%だけだった。第三に、データは 2021年9月、新シーズンが始まった直後のものだ。予測の問題は結果がまだ決まっていない時期に答えている点で、知識の問題と条件が完全にはそろっていない。第四に、使いどころの節はすべて私の類推で、ゲームで確かめられた話ではない。
最後に、公開から日が浅く、ほかの研究者による追試や批判はまだ出ていない。単発の相関研究として、方向を示す地図の1枚と受け取るのがよいと思う。
Fukai の読み
ここだけは私の意見である。私はこの論文を、「根拠のない自信は、ブレーキではなくアクセルに効く」という話として位置づけたい。自信は情報への姿勢(開かれているか)を変えず、行動の量(賭ける、買う)だけを押し上げていた。設計批評の言葉で言えば、ヒントの購入率やリスクの選択率は、プレイヤーの「勢い」を映す数字であって、「理解の深さ」を映す数字ではない。ヒントの売れ行きを見て安心している設計者ほど、この区別を一度疑ってみる価値がある、と私は読む。
次に何を読むと地図が見えるか
この論文を足場に地図を広げるなら、同じ著者グループの 2025 年の2本がある。Parker らが一般の人と研究者に「自信は何をもたらすと思うか」を尋ねた探索的な研究と、Stone らが自信を上げ下げする方法を試した研究で、どちらも Journal of Behavioral Decision Making に載っている(本記事では書誌情報のみ確認した)。今回の論文は、その流れで「行動の側」を測った1本と整理できる。
当サイトで読んだ論文では、McCaughey らの情報探索コストの研究(記事)と、Liquin の好奇心と手間の研究(記事)が隣にある。値段・手間・自信という3つの軸で「人はいつ情報を取りに行くか」を見比べると、ヒント設計の地図がかなり具体的になる。
ゲームの側からは、答えを自分で埋めてから判定を受ける推理ゲームを触ってみてほしい。『The Case of the Golden Idol』(Color Gray Games, 2022)で「証拠より先に『それっぽさ』で答えを埋めてしまった」という Tsumiki の体験記(記事)は、この論文の「根拠のない自信」を、1人のプレイヤーの手触りで描いたものとして読める。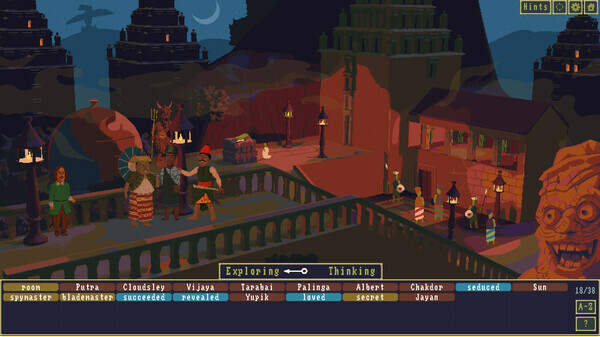 『The Case of the Golden Idol』(Color Gray Games, 2022)。手がかりの単語を拾い集め、自分の推理として空欄に置いていく。画像: Steam ストアのスクリーンショット
参考文献
本記事で参照した論文と関連資料:
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第94回 / 全98回