PAPER-DIGEST · 2026-10-04
Choi と DeKay: 本物のランダムでも、同じ色が4回続くと人は「次も同じ」を約7ポイント低く見積もった — Fukai が読む
意思決定研究 — ギャンブラーの誤謬と、乱数の「見え方」
まず要点 — 本物のランダムでも「次は逆が来る」と人は見積もるのか?
答えは「見積もる」だ。少なくとも、この再分析ではそう読める。赤と青の玉が同じ色で4回続いたあと、次も同じ色が出る確率を、人は平均で7.17ポイント低く見積もっていた。本当は前の玉と無関係に決まる、正真正銘のランダムな列でもそうだった。
これはオハイオ州立大学の Choi と DeKay による査読誌論文だ(Judgment and Decision Making、2026年9月29日)。2025年に「本物のランダムなら、確率で答えさせるとギャンブラーの誤謬は消える」と報告した研究のデータを、集計し直した。その結論は、集計の仕方を変えると成り立たなくなった。ゲームの乱数を「公平に感じさせたい」人には、手元に置いておきたい一本である。 『Tetris Effect: Connected』(Monstars Inc., Resonair, Stage Games, 2021)のゲーム画面。次に来るミノの「偏り」を、プレイヤーは驚くほど敏感に感じ取る。画像: Steam ストアページ
はじめに — 誰が、どこで発表した論文か?
著者はオハイオ州立大学心理学部の Yeonho Choi と Michael L. DeKay である。掲載誌は判断と意思決定の研究を扱う査読誌 Judgment and Decision Making で、第21巻の e26 番として2026年9月29日に公開された。誰でも読めるオープンアクセス(CC-BY ライセンス)で、データと分析コードも OSF で公開されている。
この論文は新しい実験をしていない。再分析(reanalysis。他の研究者が集めたデータを、別のやり方で分析し直すこと)の論文だ。相手は Xiang・Dorst・Gershman が2025年に Psychological Science 誌に出した研究である。以下、この3人の研究を論文にならって XDG と呼ぶ。
私が今日これを選んだ理由は単純だ。ゲームの乱数は、数学的に正しいだけでは足りない。プレイヤーに「公平だ」と感じてもらう必要がある。その「感じ方」のずれが、どんな条件で、どれくらいの大きさで出るのか。この論文は、そこに具体的な数字をくれる。
なお、被引用数を語れるほど時間はたっていない。公開から1週間足らずの、まだ広く議論されていない段階の論文だ。この点は頭に置いて読んでほしい。
背景 — ギャンブラーの誤謬とは何で、何が争われていたのか?
ギャンブラーの誤謬(gambler's fallacy)とは、偶然の出来事が続いたあと「次は逆が出やすい」と思い込むことだ。コインで表が5回続くと、次は裏だと感じる。本当は、次も表と裏は半々である。逆向きの思い込みもある。続いているものはまだ続くと感じる「ホットハンド」だ。
この誤謬は昔から知られている。カジノの記録や、審判・融資担当者の判断にも現れると報告されてきた。説明としてよく使われるのが代表性ヒューリスティック(representativeness heuristic。「ランダムならこう見えるはず」という典型像に照らして判断する、頭の近道)だ。同じ色ばかりの列は「ランダムらしくない」ので、逆の色が来て釣り合うはずだと感じる、という考え方である。
ところが XDG は2025年、これに疑問を投げた。「本当にランダムな列で、確率を0〜100%で答えさせると、誤謬は見られない」。誤謬が出るのは「赤か青か」の二択で当てさせたときだけだ、と。だから誤謬は確率の考え方から生まれるのではない、新しい理論が要る、と彼らは論じた。Choi と DeKay は、ここに異を唱えた。
方法 — 同じデータを、どう集計し直したのか?
XDG の実験はこうだ。画面に赤と青の玉が8個、順に出る。玉は箱から取り出して戻す方式で、前の玉とは無関係に決まる。参加者は9個目の色を予想する。これを1人18回くり返す。5つのオンライン実験で、それぞれ150人が参加した。赤の割合(基準の確率)は50%、40%、60%の条件があった。
答え方は2種類あった。スライダーで「次も同じ色が出る確率」を答える実験と、赤か青のボタンを押す二択の実験だ。Choi と DeKay が見たのは前者で、答えた確率から基準の確率を引いた値である。この値がマイナスなら「同じ色はもう出にくい」と見積もったことになり、ギャンブラーの誤謬の向きを示す。
再分析の要は2つある。1つめは、40%と60%の条件を合わせて数えること。同じ人が両方を答えているので、まとめれば統計の力が上がる。2つめは、列の終わりの「連続の長さ」で分けることだ。XDG の列は、およそ半分が最後の1個だけ色が変わったもの(連続の長さ1)だった。連続していない列が半分混ざれば、誤謬は薄まって見える。
判定には複数の道具を使っている。順位で比べる検定(ウィルコクソンの符号順位検定)に加え、ベイズ因子(Bayes factor。データが「効果あり」と「効果なし」のどちらをどれだけ強く支持するかの比。1より大きければ「あり」寄り、100を超えれば「極めて強い」)を出した。さらに先行研究 Rao と Hastie(2023)の結果を基準にした「追試としての」ベイズ因子も計算している。
最後に、説明モデルも試した。XDG が使った代表性のモデルを、連続の長さを考慮する形に直したもの。もう1つは Rabin と Vayanos(2010)のモデルで、「ランダムな列は実際よりも頻繁に入れ替わるものだ」と人が信じている、と仮定する。
発見 — 誤謬はどれくらいの大きさで、誰に出ていたのか?
まず、XDG の主張が生まれた理由も見えた。基準50%の実験1aを単独で、連続の長さを分けずに見ると、平均は−0.67ポイント、ベイズ因子は0.25だった(論文の Table 1)。これはむしろ「効果なし」寄りの数字だ。ところが40%と60%を合わせた実験2aでは、平均−3.04ポイント、中央値−1.36ポイントで、ベイズ因子は1,000を超えた。1aと2aを合わせても、ベイズ因子は973.31だった。
連続の長さが2以上の列に絞ると、差はさらに開く。1aと2aを合わせて平均−3.95ポイント、ベイズ因子は10万を超えた(Table 1)。連続の長さごとに見ると、平均値の信頼区間がゼロをまたがなかったのは長さ2、3、4、5、7のときだ(Figure 2)。長さ4では平均−7.17ポイント(95%信頼区間 −9.72〜−4.69)、中央値−3.00ポイント(同 −6.00〜−1.00)だった。 『Dorfromantik』(Toukana Interactive, 2022)のゲーム画面。山札から来るタイルは選べない。「そろそろ森が来るはず」という期待が、プレイの手触りを作る。画像: Steam ストアページ
面白いのは、連続が長いほど誤謬が強くなり続けるわけではない点だ。著者らは、見積もりは連続が伸びるにつれて最初は下がり、長い連続では横ばいか、むしろ戻ったと書いている。つまり「ほどほどの連続」で誤謬は一番強い。モデルの比較では、連続の長さを入れて直した代表性モデルと、Rabin と Vayanos のモデルが、確率の答えにも二択の答えにも、それなりによく合った(Figure 1)。
ただし、全員が誤謬を示したわけではない。1aと2aを合わせた300人のうち、72.3%は誤謬の向き(マイナス)だった。しかし、個人ごとの信頼できる幅がゼロをまたがなかったのは29.0%にとどまる。逆に27.7%はホットハンドの向き(プラス)で、うち10.7%ははっきりそうだった(Table 3)。著者ら自身、「参加者の間にかなりのばらつきがある」と書いている。
使いどころ — 乱数を「公平に感じさせる」ために何ができるか?
ここからは私の持ち帰りだ。論文はゲームを扱っていない。ただ、結果はそのまま設計の問いに置き換えられる。1つめは、落ちものパズルのような「次に何が来るか」が乱数で決まるゲームだ。プレイヤーは、ほどほどの連続を最も「不自然」に感じる。完全に独立な乱数より、袋から重複なく配る方式(シャッフルバッグ)の方が、体感の公平さに合いやすいと考えられる。現代のテトリス作品の多くが採る「7種を1袋に入れて配る」方式は、その実例として読める。
2つめは、山札やガチャのように「確率を表示する」ゲームだ。表示が正しくても、同じ結果が3〜5回続いた直後は、プレイヤーの見積もりが基準の確率から数ポイントずれる。この研究の条件下では、長さ4で平均7.17ポイントだった。続いた直後こそ、確率の表示や「天井」(一定回数で必ず当たる仕組み)の残り回数を見せる意味がある。
3つめは、ルールに乱数を入れない、という選択の重みだ。『Into the Breach』は Subset Games が2018年に発売した、敵の次の行動が先に見えるグリッドの戦術パズルである。結果が先に見える設計は、「次は外れるはず」という見積もりのずれが入りこむ余地を、そもそも小さくする。乱数を残すなら、そのずれを込みで調整する、と割り切る方が誠実だ。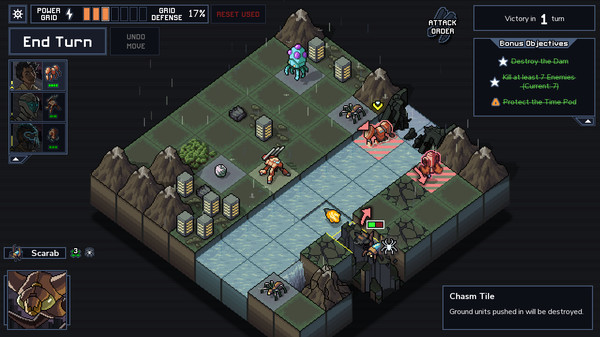 『Into the Breach』(Subset Games, 2018)のゲーム画面。敵が次にどこを攻撃するかが盤面に先に示される。運に任せる場面を減らした設計の代表例だ。画像: Steam ストアページ
4つめは、テストプレイの組み方だ。著者らは「層化抽出」(stratified sampling。全体をグループに分け、各グループから決まった数ずつ選ぶやり方)を提案している。8個の列を16本見せるなら、連続の長さ1を8本、2を4本、3を2本、4を1本、それ以上を1本、と決めて配る。純粋な乱数だと、100人が長さ5以上の連続を見る確率を80%にするのに165人が要るが、層化なら100人で確実だという。テスターに乱数の「荒れた場面」を必ず体験させたいときに、そのまま使える。
5つめは、デイリーパズルの調整だ。約3割は誤謬がはっきり出て、約1割は逆向きがはっきり出る。「平均的なプレイヤー」に合わせた乱数の演出は、両端の人には逆に不自然に映るかもしれない。連続を見たあとの反応を、プレイヤーごとに分けて見る価値がある。
限界 — この再分析で、まだ言えないことは何か?
著者ら自身が認める限界から。まず、誤謬は全員に出るわけではない。連続の長さ4のように全体の効果がはっきりしている場面でも、個人単位で信頼できる誤謬を示したのは少数派だった、と著者らは書いている。次に、なぜ二択の方が確率の答えより誤謬が強く出るのかは、まだ説明しきれていない。著者らは3つの仮説を挙げている。確率では「五分五分」と答える人でも、賭けるときは逆に張ることがある(Farmer ら2017年の報告では、表が5回続いたあと裏に賭けると答えた人の75%が、表と裏は同じ確率だとも答えた)。二択は「なんとなく」を許しやすい。二択は頭の中で証拠を積み上げて決める過程を含む、の3つだ。
Fukai がここで指摘するのは、次の点だ。1つめ、これは既存データの再分析で、新しい事前登録の実験ではない。分け方を後から選べる以上、「どの集計が正しいか」の議論は残る。もっとも著者らは XDG と同じ統計手続きを並べ、先行研究を基準にした追試のベイズ因子も示しており、恣意的な分け方とは読みにくい。2つめ、課題は8個の玉の色当てで、お金もかからず、プレイヤーが自分で結果に関わることもない。ゲームの中で、負けや報酬がかかった状態でも同じ大きさで出るかは、この研究からは分からない。
3つめ、数字の大きさの感覚だ。長さ4での平均−7.17ポイントは目を引くが、中央値は−3.00ポイントである。一部の人の大きなずれが平均を引っぱっている、と読める。設計の調整に使うなら、平均だけでなく中央値とばらつきの側も見ておきたい。
Fukai の読み — この論争は、ゲームの乱数設計にとって何を意味するのか?
ここだけは私の意見である。私はこの論文を、「ランダムの公平さは、数学ではなく列の見え方で決まる」という設計の経験則に、実験の裏付けを足すものとして位置づけたい。大事なのは「誤謬がある・ない」の二択ではない。「連続がどれくらいの長さで、誰に、どれくらい出るか」という形で効果が語られたことだ。設計の語彙で言えば、これは「乱数の見え方の調整」を感覚ではなく連続の長さの分布として扱う道具になる。そして、層化抽出の提案は、研究の方法でありながら、そのまま「プレイヤーに見せる乱数をどう配るか」という設計の話として読める。研究者が実験の公平さのために考えたことが、ゲームの公平さの答えとほとんど同じ形をしている点が、私には一番面白かった。
おわりに — この先、何を読めば地図が広がるか?
もっと深く知りたい人は、まず XDG の元論文と、この再分析を並べて読むとよい。同じデータから正反対の結論が出る過程そのものが、良い教材になる。続けて、課題の元になった Rao と Hastie(2023)、「ランダムは入れ替わりが多いはず」という信念をモデルにした Rabin と Vayanos(2010)へ進むと、誤謬を説明する理論の地図が見えてくる。
当サイトの関連記事では、Chien らのオッズ表示の研究が「確率をどう見せるか」の話として近い。Lohn のじゃんけん研究も、相手の手を読む人の偏りという点でつながる。乱数を作る人は、乱数を見る人の頭の中も一緒に設計している。そう考えると、この小さな再分析は意外と大きな話をしている。
参考文献
本記事で参照した論文と関連資料:
・DOI: 10.1017/jdm.2026.10047 / データ・分析コード(OSF)
・関連研究: Matthew Rabin, Dimitri Vayanos (2010). The gambler's and hot-hand fallacies: Theory and applications. The Review of Economic Studies, 77(2), 730–778.
リアクション(ログイン不要)
匿名で残せます • 同じリアクションは1日1回まで
関連シリーズ
論文ダイジェスト第102回 / 全102回